600 terabájt videót címkézett fel 95 perc alatt a CoreWeave és az Anyscale
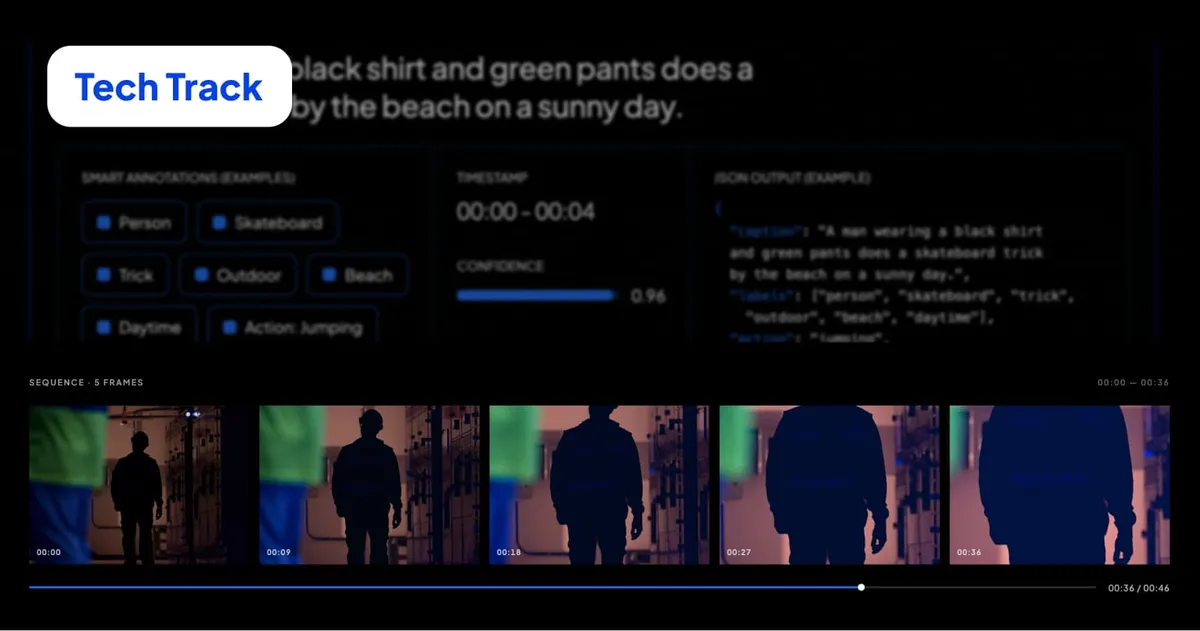
A CoreWeave és az Anyscale 600 terabájtnyi videó feldolgozását végezte el 95 perc alatt, egy 1600 NVIDIA GPU-ból álló klaszteren. A vállalatok szerint a fiók létrehozásától a termelési feladat elindításáig kevesebb mint 24 óra telt el.
- 600 terabájtnyi videót dolgoztak fel 95 perc alatt.
- A klaszter 1600 NVIDIA RTX PRO 6000 Blackwell GPU-t használt.
- A rendszer a fiók létrehozásától számítva kevesebb mint 24 óra alatt állt munkába.
- A Ray Data GPU-óránként 3,7-szer több feliratot készített, mint a Ray Core.
- Az áteresztőképesség másodpercenként 1273-ról 12 666 feliratra nőtt.
A videófeldolgozás GPU-s feladattá vált
A nagy nyelvi modellek betanításához szükséges adatok előkészítése egyre többféle multimédiás tartalmat érint. A videókat, hanganyagokat, LiDAR-adatokat és műholdfelvételeket dekódolni, szűrni, jellemzőkkel ellátni és egységesíteni kell. A CoreWeave szerint ez exabájtos léptékben már GPU-kat igényel, miközben az ilyen infrastruktúra felépítése hagyományosan heteket vagy hónapokat vehet igénybe.
A 2026. október 2-án ismertetett tesztben az Anyscale a Ray nyílt forráskódú keretrendszerét használta a munkafolyamatok ütemezésére, az adatok továbbítására és a munkások számának skálázására. A CoreWeave biztosította az alapul szolgáló infrastruktúrát, a tárhelyet és a klaszter állapotának felügyeletét.
Kevesebb mint egy nap alatt indult el a teljes rendszer
A CoreWeave egy dinamikusan skálázódó klasztert állított be 1600 NVIDIA RTX PRO 6000 Blackwell Server Edition GPU-val. A rendszerhez 200 AMD Turin 9655P csomópont tartozott, csomópontonként 192 vCPU-val, az adatok tárolására pedig a CoreWeave AI Object Storage szolgált.
Az Anyscale telepítése egy óra alatt megtörtént, mivel a CoreWeave Kubernetes Service már biztosította a menedzselt vezérlősíkot, a GPU-illesztőprogramokat, a hálózatot és a csomópontok életciklusának kezelését. A tizedik órára elkészült a Ray Data alapú, folyamatos adatfolyamként működő feldolgozás. A CPU-k dekódolták és szűrték a videókat, a GPU-k pedig a Qwen3-VL-8B modellel készítették el a feliratokat és annotációkat.
A huszadik órára ugyanazt a kódot hibákat toleráló Anyscale Job feladattá alakították át, átírás nélkül. A rendszer újrapróbálkozást és automatikus skálázást is használt.
A Ray Data javította a GPU-k kihasználását
A kezdeti, 600 gigabájtos tesztben a Ray Core kézzel kezelt szereplőkre és rögzített GPU-készletre támaszkodott. A Ray Data ezzel szemben folyamatosan továbbította a feldolgozást, a Parquet-manifesztumból olvasta be az adatokat, és a terheléshez igazította az erőforrásokat.
A CoreWeave összehasonlítása szerint 43 700 klipből egymillió felirat előállításakor a Ray Data a Ray Core által felhasznált GPU-idő 73 százalékából dolgozott, miközben GPU-óránként 3,7-szer több feliratot készített. A vállalat ezt az automatikus skálázással és a számítási lépések összehangolásával magyarázza.
A 600 gigabájtos adathalmazt 1000 szintetikus változat létrehozásával 600 terabájtra növelték. A feldolgozás csúcsán 35 820 CPU-mag 43 700 eredeti klipből 70 milliót állított elő, az objektumtárhely pedig másodpercenként 40 gigabájtos írási sebességet kezelt.
1600 GPU 95 perc alatt dolgozta fel a 600 TB-ot
A teljes, 600 terabájtos adathalmaz feliratkészítése 95 perc alatt fejeződött be. A CoreWeave AI Object Storage másodpercenként 110 és 120 gigabájt közötti olvasási sebességet biztosított, nagyjából 46 CPU-csomóponton keresztül.
A klaszter 256-ról 1600 GPU-ra bővítése mellett a GPU-nkénti feliratkészítési hatékonyság stabil maradt. A teljes áteresztőképesség másodpercenként 1273-ról 12 666 feliratra nőtt, ami 10,2-szeres növekedés.
A CoreWeave szerint a helyi NVMe-tárhelyet használó LOTA gyorsító a modellbetöltésnél is szerepet kapott. A 17 gigabájtos Qwen3-VL-modell teljes betöltése körülbelül két másodpercig tartott, miközben az egyes motorok 8,68 gigabájt másodpercenkénti olvasási sebességet értek el.