Az LLM-ek egyetértése félrevezető lehet, ha ugyanazt a hibát követik el
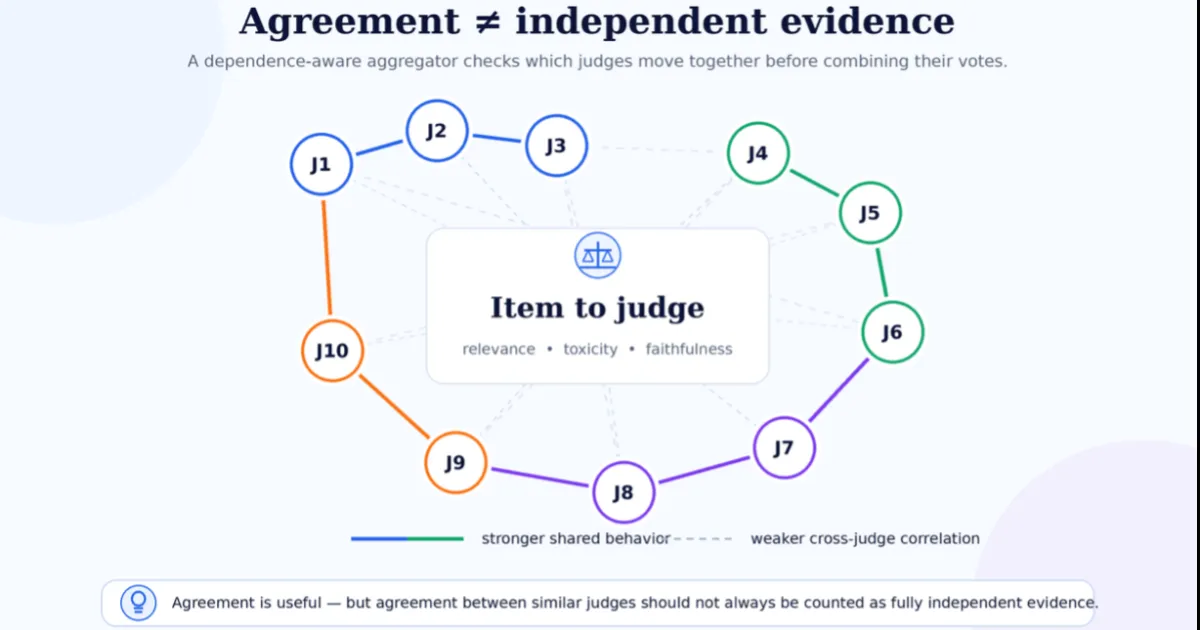
Az Amazon kutatói szerint tíz LLM-bíró egybehangzó döntése sem feltétlenül jelent tíz független bizonyítékot. Ising-modellekre épülő módszerük a bírók közötti hasonlóságokat is figyelembe veszi, és a tesztekben 9, illetve 14 százalékpont közötti pontosságjavulást ért el.
- Az LLM-bírók egyetértése közös hibából is fakadhat.
- Az Amazon módszere a bírók megbízhatóságát és egymáshoz való hasonlóságát is modellezi.
- A tesztekben három bináris feladaton javult a pontosság.
- A tíz korreláló szavazat nem feltétlenül ér annyit, mint tíz független döntés.
A többségi szavazás elrejtheti a közös hibákat
Az LLM-as-a-judge rendszerekben több modell értékelheti ugyanazt a választ vagy dokumentumot. Például egy visszakeresésre épülő generatív rendszer esetében a bírók arról dönthetnek, hogy a lekért szövegrész releváns-e. Ha tíz bíróból nyolc relevánsnak, kettő pedig irrelevánsnak ítéli, a többségi döntés első látásra meggyőzőnek tűnik.
Az Amazon Science cikke szerint azonban az egyetértő bírók nem feltétlenül szolgáltatnak nyolc különálló bizonyítékot. Ha azonos promptot, hasonló modellcsaládot vagy közös tanítási hátteret használnak, ugyanazt a hibát is elkövethetik. A modellek egy közös vakfoltot örökölhetnek, ezért a szavazatok száma erősebbnek mutathatja a bizonyítékot a valóságosnál.
A hagyományos többségi szavazás minden bírónak azonos súlyt ad. A súlyozott változat nagyobb befolyást biztosít a korábban pontosabbnak bizonyult bíróknak, de mindkét módszer abból indul ki, hogy a hibák nagyjából függetlenül keletkeznek. Az Amazon kutatói szerint ez az LLM-alapú értékeléseknél gyakran túl optimista feltételezés.
A bírókat hálózatként modellezték
Krishna Balasubramanian és Sasha Podkopaev, Shiva Kasiviswanathan társszerzőségével, a „Dependence-aware label aggregation for LLM-as-a-judge via Ising models” című tanulmányban olyan aggregálási módszert mutat be, amely az egyes bírók megbízhatósága mellett a bírók páronkénti függőségét is tanulja. A tanulmányt az idei International Conference on Machine Learning konferencián mutatták be.
A módszer a bírói panelt hálózatként kezeli. Egyes bírók az egyéni megbízhatóságuk alapján kapnak súlyt, miközben a rendszer azt is vizsgálja, hogy bizonyos párok a vártnál gyakrabban értenek-e egyet, akár közös hibák esetén is. A kapcsolatokat Ising-modellel írják le, amely bináris változók közötti páronkénti függőségek modellezésére alkalmas.
A megközelítés felügyelet nélküli beállításban működik, vagyis a tanuláshoz nem használ emberi referencia-címkéket. A rendszer az értékelt elemek valódi címkéit rejtett változóként becsüli, majd felváltva frissíti ezeket a becsléseket, valamint a bírók megbízhatóságára és függőségére vonatkozó paramétereket.
A kutatók kétféle függőségmodellezést ismertetnek. Az egyszerűbb változat a címkétől nagyjából független kapcsolatokat feltételez, így a döntés továbbra is súlyozott szavazásként értelmezhető, csak a redundáns egyetértést csökkentett súllyal kezeli. A részletesebb, osztályfüggő modell megengedi, hogy a bírók kapcsolatai a címkétől függően változzanak. Ez több adatot igényel a megbízható becsléshez.
Három feladaton javult a pontosság
A módszert három bináris feladaton tesztelték: a visszakeresett információ relevanciájának osztályozásán, a káros tartalom felismerésén és az összefoglalók értékelésén. A panel tíz bírói modellből állt, amelyeket nulla hőmérsékleten futtattak, így ugyanarra a bemenetre mindig ugyanazt a kimenetet adták.
A teljes, tízmodellből álló panellel és az egyes feladatokhoz rendelkezésre álló legnagyobb tanítási adathalmazzal a legerősebb függőségérzékeny modell 0,912-es pontosságot ért el a relevanciaosztályozásban. A súlyozott többségi szavazás 0,820-at, az egyenletes többségi szavazás 0,804-et ért el.
A káros tartalom felismerésénél az eredmények 0,792, 0,694 és 0,695 voltak ebben a sorrendben. Az összefoglalók értékelésénél a függőségérzékeny módszer 0,806-os pontosságot ért el, szemben a súlyozott többségi szavazás 0,737-es, valamint az egyenletes változat 0,561-es eredményével.
A felhasználóknak a bírói panelt is vizsgálniuk kell
Az Amazon kutatói szerint az LLM-alapú értékelési rendszereket működtető csapatoknak nem elég az egyes bírók pontosságát mérniük. A panel egészét is vizsgálni kell, mert több erős modell is redundáns lehet, ha ugyanúgy hibázik.
A modellcsaládok vagy architektúrák keverése csak akkor növeli a változatosságot, ha a bírók hibamintái ténylegesen eltérnek. Az egyetértési klaszterek vizsgálata feltárhatja a közös értékelési szabályokat, a hasonló modellviselkedést vagy az adott feladathoz kapcsolódó kétértelműséget.
A kutatók ezért azt javasolják, hogy a bizonytalanságot a bírók közötti függőséget figyelembe véve jelentsék. Tíz egymással korreláló szavazat nem feltétlenül jelent akkora bizonyosságot, mint tíz független döntés. Az értékelési naplókban található egyetértési és eltérési minták azt is megmutathatják, hogy egy új bíró valóban új bizonyítékot ad-e, vagy csak egy meglévő torzítást erősít.
Amazon Science: When LLM judges agree, should we believe them?