multimodális AI
Jelnyelvről szövegre fordító modellt mutatott be a Google DeepMind
A Google DeepMind 2026. augusztus 12-én bemutatta SL2T nevű jelnyelvről szövegre fordító modelljét. A technológia elsőként az amerikai jelnyelv, ASL angol szöveggé…
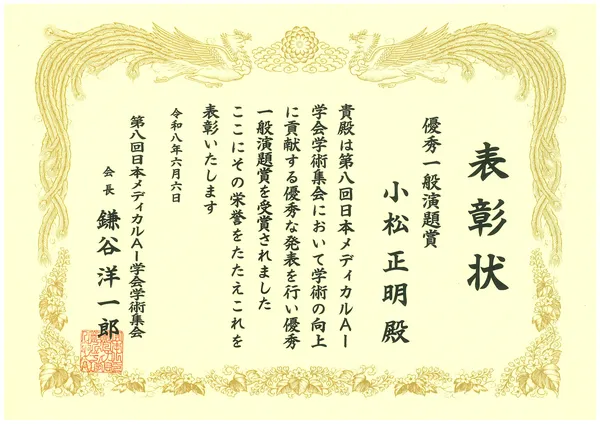
Díjat kapott a RIKEN kutatócsoportja a hasnyálmirigydaganatok AI-modelljéért
Kiváló általános előadásért járó díjat kapott Masaaki Komatsu, a RIKEN AI Medical Engineering Team helyettes csapatvezetője és kutatócsoportja. A kitüntetett előadás egy…
Az Liquid AI új, gyors látónyelvi modellje telefonon is fut
Az Liquid AI kiadta az LFM2.5-VL-3B nevű, 3,1 milliárd paraméteres látónyelvi modellt, amelyet gyors, helyi futtatásra terveztek. A vállalat szerint a modell több, nála…
A Vercel AI Gatewayre is megérkezett a Grok 4.6
A SpaceXAI Grok 4.6 modellje elérhetővé vált a Vercel AI Gateway szolgáltatásán keresztül. A rendszer szöveges és képi bemeneteket fogad, 500 ezer tokenes…
A Resemble AI fizikai világot modellező deepfake-detektort mutatott be
A Resemble AI bemutatta a DETECT-World deepfake-detektort, amely a manipulációk felismeréséhez a tartalom fizikai koherenciáját is vizsgálja. A vállalat szerint a modell…
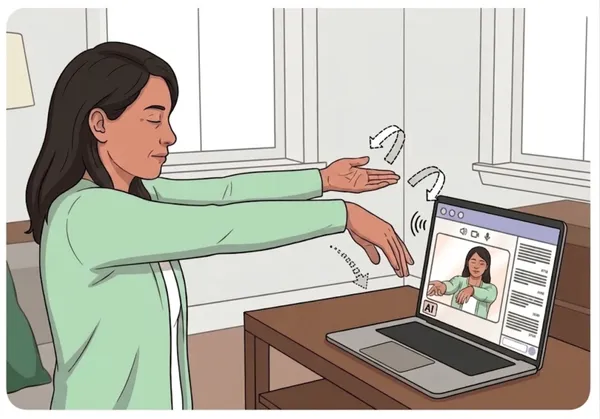
Videós orvosi konzultációkban tesztelte AMIE rendszerét a Google Research
A Google Research 2026. augusztus 11-én bemutatta az AMIE kutatási orvosi AI-rendszer videós változatát. A cég szerint az AMIE (Video) valós idejű, szimulált klinikai…
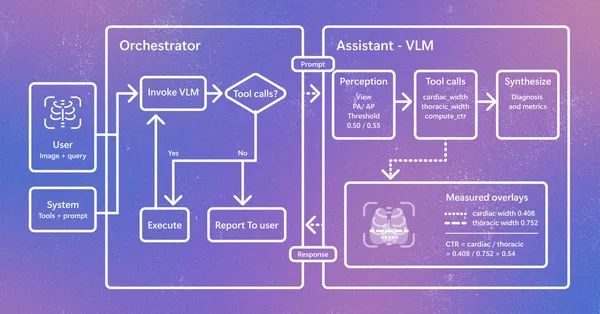
A Microsoft Research bemutatta a CARE-X radiológiai kutatási modellt
A Microsoft Research 2026. augusztus 11-én mutatta be a CARE-X nevű radiológiai látás-nyelvi kutatási modellt. A rendszer mellkasröntgenek többféle értelmezési feladatát…
Seedance 2.5: több referencia, hosszabb videók és beépített hang
A ByteDance Seedance 2.5 videógeneráló modellje a Krea felületén szövegből, képből és referenciák alapján is készít videót, opcionálisan hanggal együtt. A rendszer akár…
A mesterséges intelligencia jobban olvas, mint hallgat, állítja egy USC-kutatás
A hangalapú mesterséges intelligencia jól átírja, amit mondunk, de gyakran félreérti, hogyan mondjuk. A USC kutatói szerint az audio nagy nyelvi modellek a szöveget…
NVIDIA Magpie TTS: nyílt súlyok többnyelvű hangügynökökhöz
A Hugging Face 2026. augusztus 10-én közölt bejegyzést az NVIDIA Magpie TTS-ről. A cím szerint a technológia alacsony késleltetésű, többnyelvű hangügynökök építését…
Meta Muse Glimmer: 30B nyílt modell helyi agentikus AI-feladatokra
A Hugging Face augusztus 10-én közölt bejegyzése szerint a Meta visszatért a nyílt forrású ökoszisztémába a Muse Glimmer modellel. Az NVIDIA fejlesztői blogja alapján a…
Elérhető a Meta Superintelligence Labs első nyílt modellje, a Muse Glimmer
Az Ollama elérhetővé tette a Meta Superintelligence Labs első kiadott modelljét, a Muse Glimmert. A 30 milliárd paraméteres, multimodális modell helyi ügynökalapú…
A Meta Muse Glimmer modellje hosszú, önálló ügynöki munkára készült
A Fireworks AI elérhetővé tette a Meta Muse Glimmer modelljét, amelyet folyamatosan működő AI-ügynökökhöz, hosszú eszközhasználathoz és többfordulós feladatokhoz…
A Picsartban is elérhető a ByteDance hosszú, hangos videómodellje
A Picsart integrálta a ByteDance Seedance 2.5 videómodelljét, amely a cég leírása szerint 30 másodperces, egyetlen folyamatos felvételben generált jeleneteket készít. A…
Az Apple CAR-Flow módszere javítja a flow matching képminőségét
Az Apple kutatói olyan, feltételérzékeny újraparaméterezési módszert mutattak be, amely a flow matching modellek tanulási folyamatát rövidíti. Az ImageNet-256…
A Roboflow szerint a Qwen3.8-Max vezeti a vizuális teszteket
A Qwen3.8-Max a Roboflow tesztjeiben a legerősebb vizuális nyelvi modellnek bizonyult objektumfelismerésben. A 2,4 billió paraméteres modell már elérhető az Alibaba…
Megjelent a Seedance 2.5, hanggal és régiószintű videójavítással
A Higgsfield elindította a ByteDance Seedance 2.5 videómodelljét, amely akár 30 másodperces klipeket készít, a hangot a képpel egy menetben generálja, és kisebb…
ModellekA Seedance 2.5 már 30 másodperces jeleneteket is készít
A Seedance 2.5 egyetlen generálásban akár 30 másodperces, folyamatos videójelenetet készít, és a Picsart AI Playgroundban már elérhető. A modell a Seedance 2.0 alapjaira…
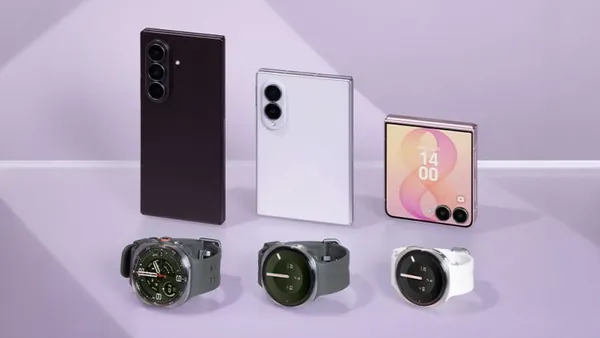
Elindult a Samsung új hajlítható mobiljainak és óráinak globális bevezetése
A Samsung Electronics 2026. augusztus 6-án bejelentette, hogy világszerte megkezdi új Galaxy Z sorozatának és Galaxy Watch termékeinek bevezetését. A Galaxy Z Fold8…
KutatásAz OpenAI országonként mutatja meg, mire használják a ChatGPT-t
Az OpenAI 2026. augusztus 6-án először tett közzé országonkénti adatokat arról, hogyan használják az emberek a ChatGPT-t világszerte. A vállalat szerint a használat…
A MiniMax H3 videót és hozzá illesztett hangot készít a Luma Agentsben
A MiniMax H3 már elérhető a Luma Agentsben, és egyetlen generálási menetben készít videót a hozzá időzített hanggal együtt. A rendszer szöveges, képi, videós és…
A llamafile már a Ternary Bonsai 27B és a Laguna-S-2.1 modellt is futtatja
Megjelent a llamafile v0.10.5, amely a frissebb llama.cpp révén támogatja a Ternary Bonsai 27B és a Poolside Laguna-S-2.1 modelleket. A kiadás dokumentációs javításokat…
 Fontos hír
Az Alibaba megnyitotta a Qwen3.8 modellek súlyait
Az Alibaba bemutatta a Qwen3.8-27B nyílt súlyú multimodális modellt, és közzétette a Qwen3.8-2.4T-A95B zászlóshajó súlyait is. A vállalat szerint az új modellek…
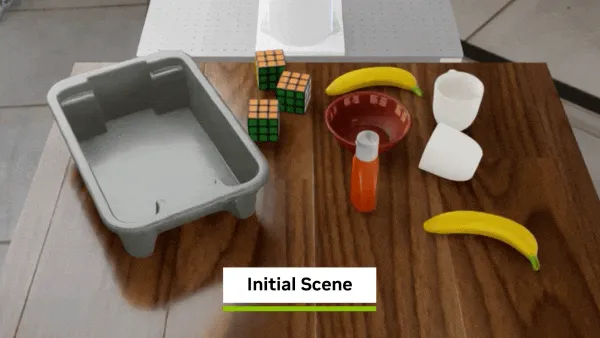
Az NVIDIA szerint a világ-akciómodellek javíthatják a robotok alkalmazkodását
Az NVIDIA Developer 2026. augusztus 4-én ismertette, hogyan alakíthatók a videós világmodellekre épülő world action modellek robotmanipulációs irányelvekké. A cég…