Snorkel AI
MedPAIR azt vizsgálja, ugyanazt tartja-e fontosnak az orvos és az AI
A MedPAIR adatbázis azt méri, hogy az orvosok és a nagy nyelvi modellek ugyanazokat a mondatokat tartják-e fontosnak egy klinikai kérdés megválaszolásához. A kutatásban…
A Snorkel szerint az Opus 5.5 vezet a kódolási tesztben
Az Opus 5.5 érte el a legmagasabb összesített sikerarányt a Snorkel AI szakértők által összeállított kódolási feladatsorán. A modell 68 százalékos eredményt ért el…
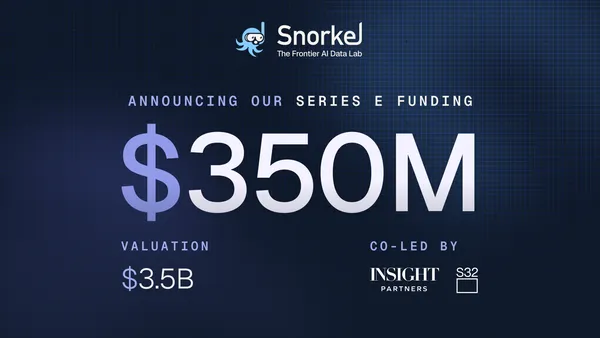
350 millió dollárt vont be az AI-adatokra építő Snorkel AI
A Snorkel AI 350 millió dolláros Series E finanszírozást vont be 3,5 milliárd dolláros értékelés mellett. A vállalat kutatási laboratóriumot építene az AI-rendszerek…
A Grok 4.7 olcsóbban hozza az Opus 4.8 szintjét kódolásban
A Grok 4.7 a Senior SWE-Bench teszten 40,0 százalékos tasteful pass@3 eredményt ért el, ezzel holtversenyben hatodik lett. Az eredmény megegyezik az Opus 4.8…
A Fable 5.1 gyorsabb és takarékosabb, de az Opus 5 megbízhatóbb
A Fable 5.1 a sikeres futások során 58 százalékkal kevesebb kimeneti tokent használt, és 36 százalékkal gyorsabban végzett, mint az Opus 5. A Snorkel AI értékelése…
A Terminal-Bench 4.0 folyamatos ellenőrzéssel tartaná értékét
Megjelent a Terminal-Bench 4.0, amely a feladatok szigorúbb ellenőrzésére, a reprodukálhatóságra és a benchmark folyamatos karbantartására épít. A Snorkel AI szerint a…
Miért buknak el a frontier AI-ügynökök a valódi mérnöki munkán?
A Terminal-Bench 3.0 legjobb modellje, Claude Opus 5 is csak 43,5 százalékos eredményt ér el az új teszten. A Snorkel AI két feladaton keresztül mutatja be, miért nehéz…
Új benchmark méri, valóban tanulnak-e az AI-rendszerek a tapasztalatból
A Continual Learning Bench azt méri, hogy az LLM-alapú rendszerek valóban javulnak-e a egymást követő feladatok során szerzett tapasztalatoktól. A Berkeley kutatója…
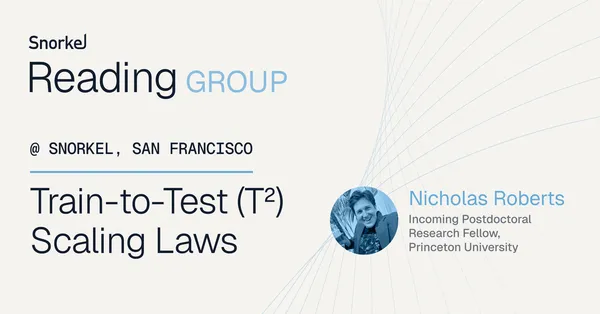
A gondolkodó AI-modelleket érdemes lehet jóval tovább tanítani
A tesztidős következtetés (test-time reasoning) alapjaiban módosíthatja, hogyan érdemes nyelvi modelleket tanítani. A Snorkel AI kutatói szerint a számítási szempontból…
Az AI-ügynökök értékelését részfeladatokra bontaná a Snorkel AI
A hosszú, több eszközön és állapoton átívelő AI-feladatoknál félrevezető lehet az egyszerű siker vagy kudarc jelölés. A Snorkel AI mérföldkőalapú értékelést javasol…
A Snorkel AI vállalati környezetekben tanítaná az AI-ügynököket
A vállalati AI-ügynökök teljesítményét nem lehet megbízhatóan a végső válasz alapján megítélni, állítja a Snorkel AI. A kutatócsoport olyan szimulált vállalati…