Terminal-Bench
A Replit Agent maga dönti el, mikor és melyik modellt használja
A Replit Agent új megközelítése nagyobb döntési szabadságot ad a fő modellnek: maga határozza meg, mennyire gondolkodjon, mikor adjon át egy feladatot, és melyik…
A Replit Agent maga dönti el, mikor és melyik modellt használja
A Replit Agent új vezérlési rendszere a fő modellre bízza, mennyire gondolja végig a feladatot, mikor delegál részfeladatot, és melyik almodellt választja hozzá. A…
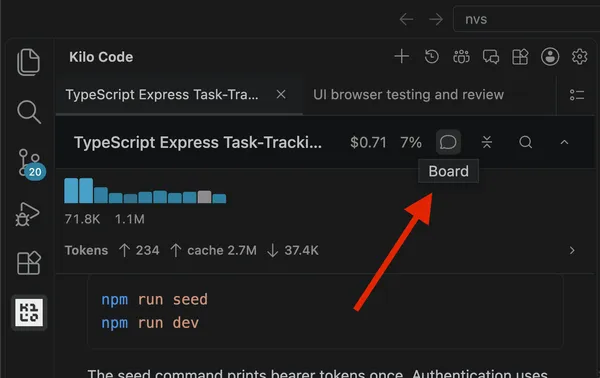
A Kilo Swarm 39 százalékkal csökkentette a költséget egy célfeladaton
A Kilo Swarm egy összetett, több ügynökkel végzett fejlesztési feladaton 39,2 százalékkal csökkentette a költséget, miközben a teszt mind a tíz futása sikeres lett. A…
A teljes sandboxmentés segíthet a kódolóügynököknek, de nem mindig
A Daytona azt vizsgálta, hogy a kódolóügynökök korábbi munkakörnyezeteinek teljes mentése javítja-e a sikertelen próbálkozások folytatásának esélyét. A Terminal-Bench…
A Vercel Sandboxban is futtathatók a Harbor értékelései
A Vercel Sandbox támogatja a Harbor nyílt forráskódú értékelési keretrendszerét, így a Terminal-Bench és több más benchmark is futtatható a Vercel infrastruktúráján. Az…
A Terminal-Bench 4.0 folyamatos ellenőrzéssel tartaná értékét
Megjelent a Terminal-Bench 4.0, amely a feladatok szigorúbb ellenőrzésére, a reprodukálhatóságra és a benchmark folyamatos karbantartására épít. A Snorkel AI szerint a…
Új benchmark méri, valóban tanulnak-e az AI-rendszerek a tapasztalatból
A Continual Learning Bench azt méri, hogy az LLM-alapú rendszerek valóban javulnak-e a egymást követő feladatok során szerzett tapasztalatoktól. A Berkeley kutatója…
A Cline nyílttá teszi az open-weight ügynökök értékelési adatait
A Cline nyílttá teszi az open-weight modellekkel működő kódoló ügynökök értékeléséhez használt módszereit, eredményeit és nyomvonalait. A vállalat szerint a cél annak…