A CoreWeave szerint 6,5-szer gyorsabb a DeepSeek R1 a GB300-on
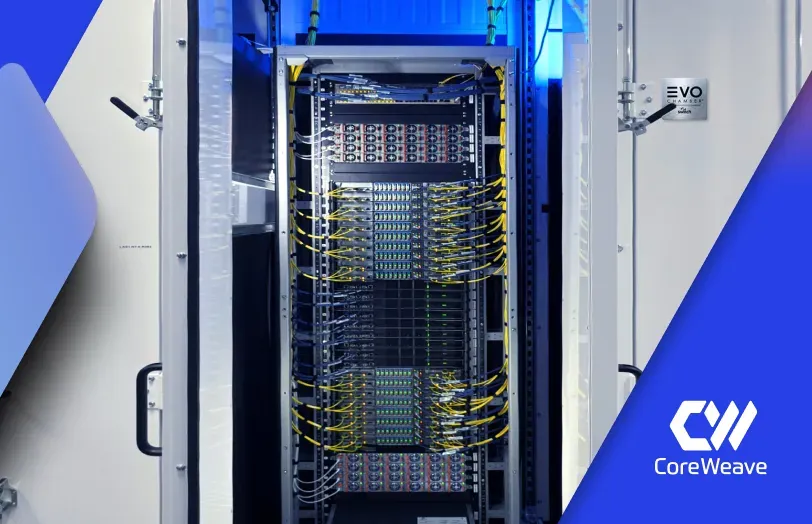
A CoreWeave szerint új NVIDIA GB300 NVL72 infrastruktúráján 6,5-szer nagyobb következtetési teljesítményt ért el a DeepSeek R1 modellen, mint a vállalat korábbi összehasonlításában. A tesztben négy GB300 GPU teljesítményét vetették össze egy 16 GPU-s NVIDIA H100 rendszerével.
- A CoreWeave 6,5-szeres következtetési teljesítményjavulást mért a DeepSeek R1 modellen.
- A tesztben négy GB300 GPU teljesített egy 16 GPU-s NVIDIA H100 rendszerrel szemben.
- A GB300 NVL72 37 TB memóriát és 130 TB/s NVIDIA NVLink sávszélességet kínál.
- A rendszer 72 NVIDIA Blackwell Ultra GPU-t kapcsol össze.
- A CoreWeave topológiatudatos ütemezéssel és Grafana-monitorozással egészíti ki az infrastruktúrát.
Kevesebb GPU-val is nagyobb áteresztőképesség
A CoreWeave 2026. október 22-i közlése szerint a DeepSeek R1 következtetési tesztjében a GB300 NVL72 több mint hatszor nagyobb nyers, GPU-nkénti áteresztőképességet biztosított. A vállalat összesített eredménye 6,5-szeres teljesítményjavulás volt a modellen.
Az összehasonlításban egy 16 GPU-s NVIDIA H100 rendszert állítottak szembe a GB300 NVL72 infrastruktúráján használt négy GPU-val. A GB300 nagyobb memória- és összekapcsolási sávszélessége lehetővé tette, hogy a DeepSeek R1-et négyutas tenzoros párhuzamosítással, TP4-gyel futtassák. A H100 rendszerén ehhez 16 utas párhuzamosításra, TP16-ra volt szükség.
A CoreWeave szerint a különbség mérsékelte a GPU-k közötti kommunikációból származó többletterhelést. Ez a tokenek gyorsabb generálását eredményezi, ami különösen fontos a következtetési modelleknél. A DeepSeek R1 összetett, több lépésből álló feladatokat és adatelemzést végezhet, az ilyen folyamatok pedig több egymást követő számítási lépést igényelnek.
A GB300 NVL72 felépítése
Az NVIDIA GB300 NVL72 egy rackszintű rendszer, amelyet a CoreWeave a nagy méretű, fejlett AI-modellek futtatására használ. A rendszer összesen 37 TB memóriával rendelkezik, így a vállalat szerint nagyobb és összetettebb modellek futtatását teszi lehetővé alacsonyabb késleltetés mellett.
A rendszer 72, NVIDIA Blackwell Ultra GPU-t kapcsol össze ötödik generációs NVIDIA NVLink technológiával. A közlés szerint az összeköttetés 130 TB/s sávszélességet biztosít. Ez a nagy léptékű tanítási feladatoknál csökkenti a kommunikációs többletterhelést, és segít abban, hogy a GPU-k folyamatosan hozzáférjenek a szükséges adatokhoz.
A GB300 NVL72 az NVIDIA Quantum-X800 InfiniBand skálázott számítási hálózatával együtt működik a CoreWeave AI Cloudban. A vállalat szerint ez az egész fürtön hatékonyabb adatáramlást tesz lehetővé, és csökkenti az árucikként elérhető felhőkörnyezetekben tapasztalható szűk keresztmetszeteket.
A CoreWeave teljes felhős környezetbe integrálta a rendszert
A CoreWeave közlése szerint a hardver önmagában nem elég a stabil és kiszámítható AI-teljesítményhez. A vállalat saját Rack LifeCycle Controller rendszere automatizálja az állapotellenőrzést, a firmware telepítését és a rendszerlemezkép előkészítését. A folyamat a számítási tálcákat és az NVLink-kapcsolókat is ellenőrzi.
A platform Kubernetes, vagyis CKS, valamint Slurm on Kubernetes, vagyis SUNK környezetekkel is integrálható. A CoreWeave topológiatudatos ütemezője az NVLink-címkék és egy egyedi blokkbővítmény segítségével igyekszik ugyanazon NVL72-tartományon belül tartani a munkafolyamatokat. Ez megakadályozza, hogy a feladatok több rack között szóródjanak szét, ami a vállalat szerint csökkentené az NVLink skálázási előnyeit.
A kezelt Grafana-irányítópultok valós időben mutatják a GPU-k kihasználtságát, az NVLink-forgalmat és a rackek rendelkezésre állását. A CoreWeave ezt a megfigyelhetőséget a teljesítményhangolás és a kritikus AI-alkalmazások megbízható működésének eszközeként mutatja be.
Mit jelenthet ez az AI-feladatok számára?
A CoreWeave szerint a mérési eredmény a következtetési teljesítmény javulását, gyorsabb token-generálást és alacsonyabb kommunikációs többletterhelést jelenthet a reasoning modellek esetében. A vállalat úgy látja, hogy ez alkalmassá teheti az infrastruktúrát valós idejű AI-ügynökök és összetett következtetési alkalmazások futtatására.
A cég további előnyként említi a nagyobb és összetettebb modellek gyorsabb tanítását, a költségkeretre jutó nagyobb következtetési áteresztőképességet, valamint a nagy léptékű AI-feladatokra optimalizált, vállalati használatra szánt környezetet. A közlemény a trillion paraméteres modellek és a valós idejű, összetett AI-feladatok terjedését olyan kihívásként írja le, amelyben a memória, az áteresztőképesség és a késleltetés egyaránt meghatározó.