A CoreWeave szerint az AI-gyárakat élesben is bizonyítani kell
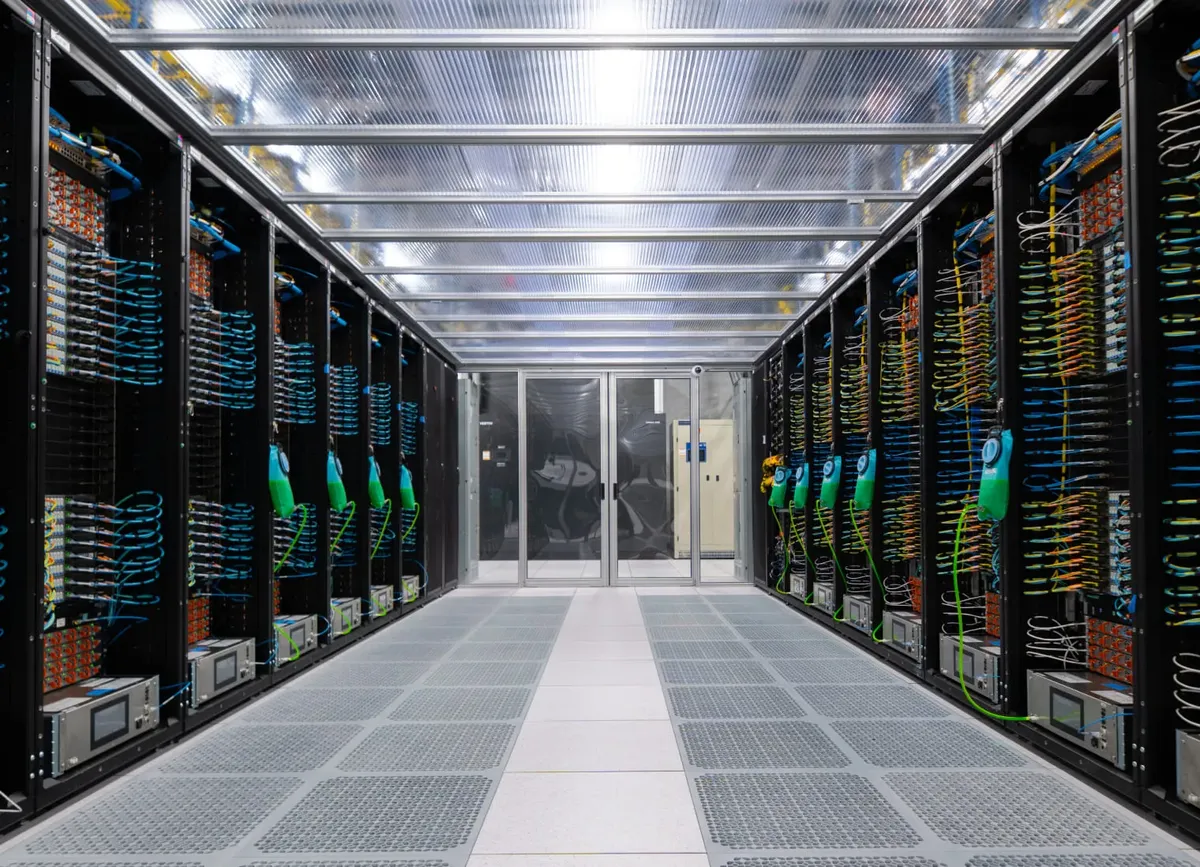
A GPU-k önmagukban már nem bizonyítják, hogy egy AI-infrastruktúra készen áll a termelésre. A CoreWeave és az NVIDIA a számítási kapacitást, a hálózatot, a tárhelyet, az ütemezést és a helyreállítást együtt tervezi és validálja.
- A CoreWeave szerint az AI-gyárak teljes infrastruktúráját kell éles terhelés mellett igazolni.
- A CoreWeave és az NVIDIA 2026 januárja óta a Vera Rubin platform telepítésén is együtt dolgozik.
- A Vera Rubin NVL72 a közölt mérésben megaw wattonként 10-szer több tokent generált, mint a GB200 NVL72.
- A CoreWeave ARENA valós tanítási, inference- és ügynöki munkafolyamatok validálására szolgál.
- A DeepSeek-V3 671B MLPerf-mérését 2,02 perc alatt teljesítették 8192 Blackwell Ultra GPU-n.
A zöld műszerfal már nem elég
A CoreWeave október 2-án közzétett bejegyzése szerint az AI-munkafolyamatok ma már azt követelik meg, hogy az infrastruktúra minden fontos rétege akár két héten át, megakadások nélkül működjön együtt. A számítási kapacitás mellett a hálózatnak, a tárhelynek, az ütemezésnek és a helyreállításnak is összehangoltan kell működnie.
Az úgynevezett AI-gyárak célja, hogy a rendelkezésre álló energiát tokenekké alakítsák, a tanítási futásidőt napokról órákra csökkentsék, és növeljék a tokenkibocsátást. A CoreWeave szerint az ügynöki, több lépésből álló munkafolyamatok miatt a terhelés bármikor megugorhat. Egy leállt feladat GPU-erőforrásokat köthet le, egy elveszett ellenőrzési pont pedig korábban elvégzett munkát tehet szükségessé újra.
Közös tervezés az NVIDIA-val
A NVIDIA és a CoreWeave teljes infrastruktúra-verem közös megtervezésén dolgozik modellfejlesztők, vállalatok és AI-központú cégek számára. Az NVIDIA a gyorsított számítási platformot, a CoreWeave pedig az AI-ra szabott felhőszoftvert és az üzemeltetési réteget biztosítja. A közös cél, hogy a rendszer éles környezetben ugyanúgy viselkedjen, mint a validálás során.
Az együttműködés 2026 januárjában bővült a Vera Rubin platform CoreWeave-en történő telepítésével, az NVIDIA DSX platform használatával. A DSX az NVIDIA referencia- és tervezési rendszere arra, hogyan kell az AI-gyárakat megtervezni, felépíteni és üzemeltetni. A CoreWeave által közölt korai mérés szerint a Vera Rubin NVL72 ugyanazon a DeepSeek R1 munkaterhelésen, megawattonként 10-szer több tokent generált másodpercenként, mint az NVIDIA GB200 NVL72.
Valós munkaterhelésekkel tesztelik a rendszert
A CoreWeave szerint a teljesítményt nem lehet kizárólag a PFLOPS-érték alapján megítélni. A GPU-kat, CPU-kat, hálózatokat és tárhelyet együtt kell megtervezni. A vállalat az NVIDIA Exemplar Cloud validációjában is részt vesz. A GB200 NVL72-re épülő, 576 Blackwell GPU-t, NVIDIA Quantum-2 InfiniBand hálózatot és CoreWeave Mission Controlt használó konfiguráció teljesítette az NVIDIA nagyméretű tanításra vonatkozó referenciaértékeit.
Az inference, vagyis a modellfuttatás oldalán a CoreWeave DeepSeek-R1, Llama 3.3 és GPT-OSS munkaterheléseken ért el Exemplar Cloud-validációt. A tesztekhez NVIDIA TRT-LLM és SGLang háttérrendszereket, valamint az NVIDIA Dynamo több csomópontos kiszolgálását használták.
A CoreWeave ARENA nevű, termelési méretű validációs laborjában az ügyfelek tanítási, inference- és ügynöki munkafolyamatokat futtathatnak termelési szintű infrastruktúrán. A környezet a vállalat szerint ugyanazokat az elemeket használja, mint az éles rendszer, köztük a GPU-kat, a CoreWeave Kubernetes Service-t, a Slurmot, a SUNK-ot, az AI Object Storage with LOTA tárhelyet, a hálózatot és a Mission Controlt.
A teljesítmény mellett a hálózat és a tárhely is számít
A CoreWeave NVIDIA Spectrum-X Ethernet és NVIDIA Quantum InfiniBand hálózatot használ az alacsony késleltetésű kommunikációhoz, valamint AI Object Storage with LOTA rendszert az adatok nagy sebességű továbbításához. A vállalat szerint ezeknek a rétegeknek kell biztosítaniuk, hogy a sok rackre kiterjedő munkafolyamatokban a GPU-k ne várjanak hálózati vagy tárhelyoldali okokból.
A CoreWeave az MLPerf Training v6.0 mérésében a DeepSeek-V3 671B tanítási feladatát 2,02 perc alatt teljesítette 8192 Blackwell Ultra GPU-n. A vállalat közlése szerint ez volt a forduló legnagyobb GB300 NVL72 fürtje. Az előző, MLPerf Training v5.0 fordulóban a CoreWeave, az NVIDIA és az IBM egy 405 milliárd paraméteres Llama 3.1 feladatot 27,3 perc alatt teljesített egy NVIDIA GB200 NVL72 fürtön.
A bejelentés alapján a felhasználók számára a validáció azt jelentheti, hogy a modellek éles telepítése előtt valós konfigurációkon vizsgálható a teljesítmény, a skálázódás és a költségviselkedés. A CoreWeave ezt a teljes infrastruktúra előzetes bizonyításával kapcsolja össze, a számítási rétegtől a hálózaton és a tárhelyen át az üzemeltetésig.
CoreWeave: Why AI Factories Need Proof Before Production