A CoreWeave tárhelye 2,3 GiB/s adatátvitelt ért el GPU-nként
A CoreWeave benchmarkja szerint az AI Object Storage szolgáltatás 2,3 GiB/s olvasási teljesítményt ért el GPU-nként, amikor 20 csomóponton összesen 160 NVIDIA H200 GPU dolgozott. A vállalat szerint a Local Object Transport Accelerator helyi NVMe-tárolón gyorsította fel az ismételt olvasásokat.
- A CAIOS 368 GiB/s összesített olvasási sebességet ért el.
- A mérés 20 NVIDIA H200 GPU-csomóponton zajlott.
- A teljesítmény 2,3 GiB/s volt GPU-nként.
- A LOTA a helyi NVMe-tárolón gyorsítótárazta az adatokat.
- A következő teszt az írási teljesítményt vizsgálja.
Helyi gyorsítótárral gyorsítja az AI-munkafolyamatokat
A CoreWeave október 22-én részletes benchmarkot közölt a CoreWeave AI Object Storage, röviden CAIOS teljesítményéről. A szolgáltatás exabájtos méretre skálázható, S3-kompatibilis felügyelt felhőtárhely, amelyet a vállalat GPU-intenzív AI-modelltréninghez tervezett.
A CAIOS a CoreWeave NVIDIA GPU-fürtjeivel integrálódik. Központi eleme a Local Object Transport Accelerator, vagyis a LOTA, amely a gyakran használt vagy előre betöltött adatokat a GPU-csomópontok helyi NVMe-lemezein gyorsítótárazza. A CoreWeave szerint így csökkenthető a hálózati késleltetés, és gyorsíthatók az olyan munkafolyamatok, amelyek nagy adatkészleteket olvasnak ismételten.
A meglévő S3-kompatibilis alkalmazások a vállalat szerint a cwlota.com végponton keresztül, további kódolás nélkül használhatják a LOTA gyorsítótárát.
20 NVIDIA H200 csomóponton futott a teszt
A mérést a CoreWeave US-WEST-04A rendelkezésreállási zónájában végezték, 20 GPU-csomópont bevonásával. Minden csomópont nyolc NVIDIA H200 GPU-t, egy NVIDIA BlueField-3 DPU-t, valamint két, egyenként 100 gigabites redundáns hálózati kapcsolatot használt a tárhely eléréséhez. A konfigurációban nyolc NVIDIA ConnectX-7 InfiniBand-adapter szolgált a GPU-k közötti kommunikációra.
A csomópontok egyenként 1 TiB helyi gyorsítótárat kaptak, így a fürt teljes gyorsítótár-kapacitása 20 TiB volt. A tesztelőalkalmazás a nyílt forráskódú Warp S3 benchmarking eszközt használta. Minden csomópont 10 000, egyenként 50 MiB méretű objektumot írt ki, 10 MiB-os részekben, 100 párhuzamos szállal. Ezt követően a rendszer 10 percen át véletlenszerű olvasási műveleteket végzett.
A teszt CPU-alapú I/O-t használt, közvetlen GPU-s tárhelyolvasást nem. A hardverkörnyezetet azért választották, hogy a mérés közelebb legyen a CoreWeave éles gyártási környezetéhez.
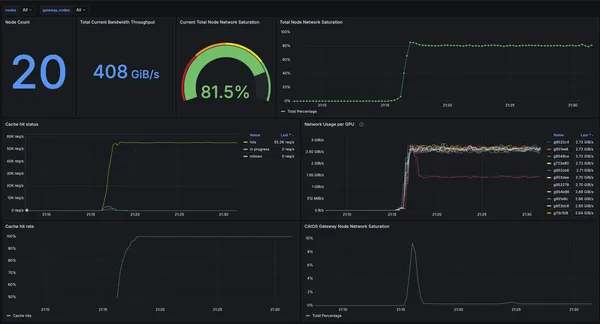
A gyorsítótár feltöltése után 368 GiB/s lett az összteljesítmény
Az első percben, amikor a LOTA gyorsítótára még feltöltés alatt állt, a mért összesített olvasási sebesség körülbelül 24 GiB/s volt. Ez csomópontonként 1,2 GiB/s értéket jelentett.
Egy újabb perc elteltével a gyorsítótár elérte teljes kapacitását, és a további olvasások már a helyi NVMe-tárolóról történtek. Ekkor az összteljesítmény 368 GiB/s-ra nőtt, ami átlagosan 18,4 GiB/s csomópontonként, illetve 2,3 GiB/s GPU-nként. A CoreWeave szerint ez meghaladja a GPU-nkénti 2 GiB/s olvasási teljesítményt.
A vállalat azt állítja, hogy a gyorsítótárazott vagy előre betöltött adatok sebességét a GPU-csomópontok helyi tárolója határozza meg. Emiatt várakozásuk szerint a teljesítmény tetszőleges számú GPU-csomópontra és GPU-ra is skálázható. A közlemény szerint ezt több, több ezer GPU-csomóponton működő CAIOS-ügyfél tapasztalatai is alátámasztják.
Videós tréninghez és ellenőrzőpontokhoz is használható
A CoreWeave szerint a LOTA különösen azokban az AI-munkafolyamatokban lehet hasznos, amelyek nagy médiafájlokat kezelnek. Ha egy objektum bármely szegmenséhez hozzáférnek, a rendszer a teljes objektumot gyorsítótárazza a későbbi olvasásokhoz. Ez olyan feladatoknál számíthat, mint az önvezető járművek videóinak tréningje vagy az ellenőrzőpontok visszaállítása.
A felhasználók adatkészleteket előre is betölthetnek a gyorsítótárba. A vállalat ezt nagyméretű multimédiás fájlokhoz, következtetési alkalmazásokhoz és konténerregisztrációs lemezképekhez ajánlja. A CoreWeave szerint a megoldás csökkentheti a GPU-k adatokra várakozását, gyorsíthatja a tréningciklusokat és a következtetési válaszokat.
A mostani mérés az olvasási teljesítményre koncentrált. A CoreWeave következő benchmarkjaiban az írási sebességet, ezen belül az ellenőrzőpontok mentését vizsgálja majd. A vállalat a horizontálisan skálázható felépítés alapján hasonlóan erős írási teljesítményre számít, ez azonban a mostani tesztben még nem szerepelt.
CoreWeave: Benchmark Results: CoreWeave AI Object Storage Delivers 2+ GB/s per GPU Throughput Across any Number of GPUs