A CoreWeave elsőként telepít NVIDIA H200 GPU-kat felhőben
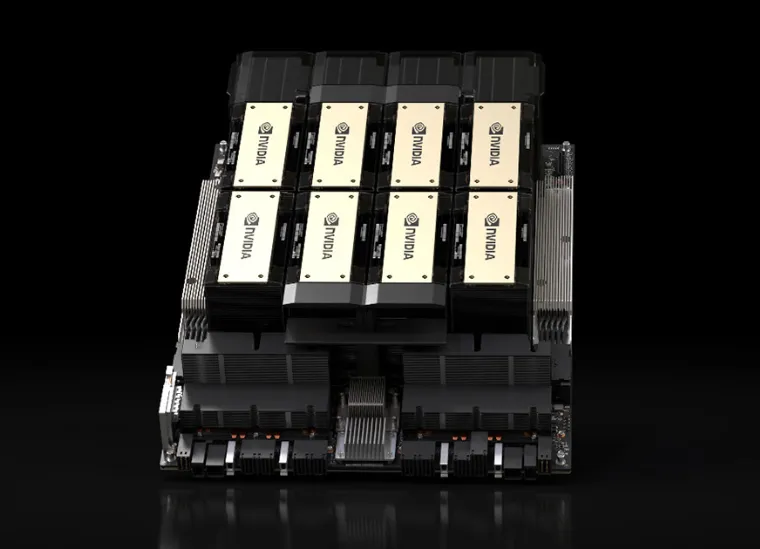
A CoreWeave közlése szerint első felhőszolgáltatóként telepítette piacra az NVIDIA H200 Tensor Core GPU-kat. Az új példányok generatív AI-modellek betanítását, nagyléptékű következtetést és nagy teljesítményű számítási feladatokat céloznak.
- A CoreWeave szerint első felhőszolgáltatóként telepítette az NVIDIA H200 GPU-kat.
- A H200 4,8 TB/s memória-sávszélességet és 141 GB HBM3e memóriát kínál.
- A példányok akár 42 000 GPU-t tartalmazó klaszterekben működhetnek.
- A Mission Control a hardverek állapotát és életciklusát kezeli.
- A CKS, a SUNK és az Observability Services az üzemeltetést támogatja.
H200 GPU-k akár 42 000 gyorsítós klaszterekben
A CoreWeave H200-példányai az NVIDIA H200 Tensor Core GPU-kat ötödik generációs Intel Xeon CPU-kkal, NVIDIA BlueField-3 DPU-kkal és 3200 Gbps sebességű NVIDIA Quantum-2 InfiniBand hálózattal kombinálják. A vállalat szerint a rendszerek legfeljebb 42 000 GPU-t tartalmazó klaszterekben működnek.
Az NVIDIA H200 4,8 TB/s memória-sávszélességet és 141 GB HBM3e GPU-memóriát kínál. A CoreWeave az NVIDIA adataira hivatkozva azt írja, hogy ez akár 1,9-szer nagyobb teljesítményt biztosíthat a H100 GPU-khoz képest. A konfigurációt nagyméretű generatív AI-modellek tanítására, valós idejű következtetésre és nagy teljesítményű számítási feladatokra szánják.
A Mission Control a klaszterek állapotát felügyeli
A nagy GPU-klaszterek teljesítménye mellett a megbízhatóság kezelése is központi szerepet kap a CoreWeave szolgáltatásában. A Mission Control ellenőrzi, hogy a hardverelemek megfelelően csatlakoznak-e, naprakészek-e, és átestek-e a teljesítményhez szükséges teszteken.
A rendszer automatikus állapotfelmérést végez az üresen álló csomópontokon, és a CoreWeave szerint a hibás elemeket még a meghibásodás előtt egészséges csomópontokra cserélheti. A kiterjedt megfigyelés gyorsabban azonosítja a hardverhibákat, így rövidülhet a betanítási feladatok újraindításához szükséges hibakeresés és a kiesés időtartama.
A Fleet LifeCycle Controller és a Node LifeCycle Controller együtt kezeli a flották, illetve az egyes csomópontok életciklusát. A vállalat ezt az infrastruktúra megbízhatóságának és ellenálló képességének javítására használja.
Kubernetes, Slurm és részletes megfigyelési adatok
Az ügyfelek a CoreWeave Kubernetes Service, röviden CKS segítségével indíthatnak GPU-klasztereket. A felügyelt Kubernetes-szolgáltatás bare-metal csomópontokra épül, hipervizor nélkül, a BlueField DPU-alapú architektúra pedig a vállalat szerint elkülönítést és gyorsítást biztosít klaszterprivát VPC-kben.
A CKS része a Slurm on Kubernetes, vagyis SUNK integráció is. Ez lehetővé teszi, hogy a Slurm-feladatok Kubernetesen belül fussanak, miközben a fejlesztők ugyanazt a számítási infrastruktúrát Kubernetes- és Slurm-oldalról is használhatják. A megoldás támogatja a kötegelt és az időszakosan megnövelt terhelésű feladatokat ugyanazon a platformon.
A CoreWeave Observability Services csomópont- és rendszerszintű mérőszámokat, riasztásokat és irányítópultokat kínál. Ezek segítségével az ügyfelek a teljes klasztert vagy egyes feladatokat is követhetnek, és a vállalat szerint percek alatt azonosíthatják a hibák kiváltó okát, legyen szó hibás memóriabeállításról, szoftverfrissítésről, szerverkomponensről vagy a csomópontok közötti hálózatról.
A bejelentés a felhasználók számára azt jelenti, hogy a CoreWeave egyetlen, H200 GPU-kra épülő felhős környezetben kínál gyorsítást, klaszterkezelést, Kubernetes- és Slurm-támogatást, valamint infrastruktúra-szintű megfigyelést. A vállalat közlése szerint a következő lépés az NVIDIA Blackwell platform piacra vitele lesz.