Így állítja munkába a CoreWeave a több rackből álló Vera Rubin klasztert
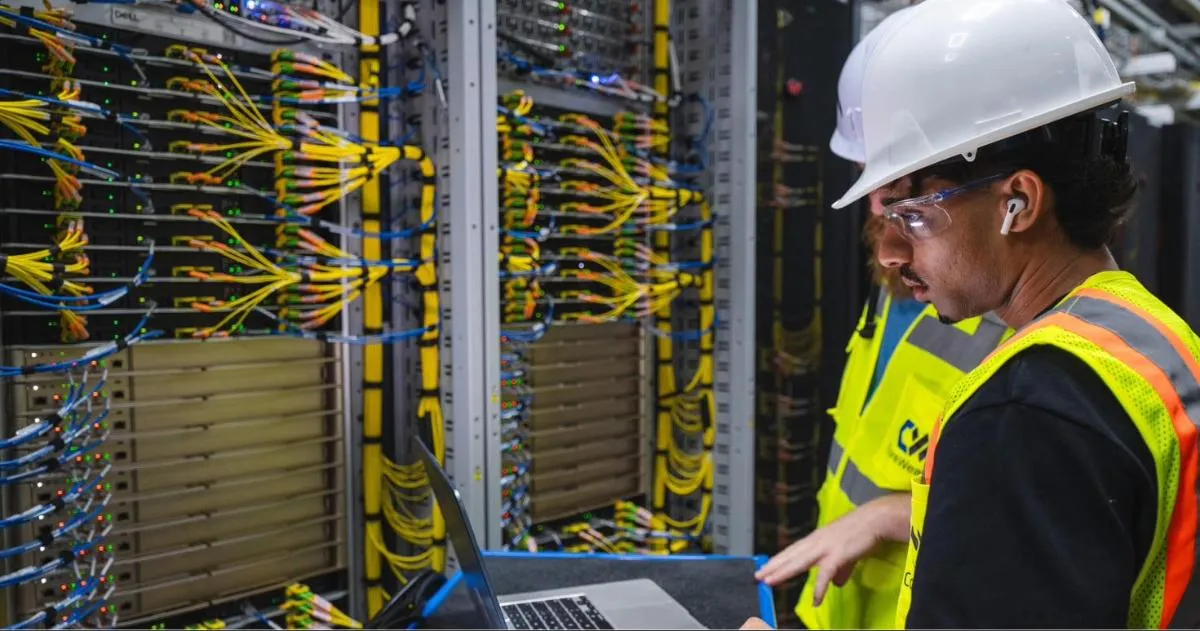
A CoreWeave bemutatta, milyen mérnöki és tesztelési folyamat kell egy több rackből álló NVIDIA Vera Rubin NVL72 klaszter üzembe állításához. A vállalat szerint a cél, hogy a számítás, a hálózat, a tápellátás és a folyadékhűtés egyetlen összehangolt rendszerként működjön.
- Egy Vera Rubin NVL72 rack 72 GPU-t és 36 CPU-t tartalmaz.
- A CoreWeave automatizálja a hardver, firmware, hűtés és tápellátás életciklusát.
- A rendszereket csomóponti, rack-, hálózati és klaszterszinten is tesztelik.
- A RoCE-fabric GPU-nként legfeljebb 1,6 Tb/s háttérhálózati kapcsolatot kínál.
- A vállalat szerint a hálózati kialakítás megközelítőleg 128 000 GPU-ig bővíthető.
Egy rack is összetett rendszer
A CoreWeave 2026. október 2-án közzétett leírása szerint egyetlen NVIDIA Vera Rubin NVL72 rack 72 NVIDIA Rubin GPU-t, 36 Vera CPU-t, NVIDIA NVLink 6 összeköttetést, ConnectX-9 SuperNIC-eket, BlueField-4 DPU-kat, nagy sebességű tárolót, valamint 45 Celsius-fokos folyadékhűtést foglal magában.
Több rack összekapcsolásakor a rendszer elosztott mesterségesintelligencia-infrastruktúrává válik. Több száz GPU, több NVLink-tartomány, több ezer nagy sebességű hálózati kapcsolat, a hűtés, a tápellátás, a firmware és a szoftver működését kell összehangolni. A CoreWeave szerint egy lassabb GPU, egy problémás hálózati kapcsolat vagy egy hűtési rendellenesség az egész klaszter teljesítményére hatással lehet.
A rackek életciklusát szoftver vezérli
A vállalat automatizált folyamatot használ az új infrastruktúra üzembe állítására. A hardver csatlakoztatása és a folyadékhűtési kör kialakítása után a rendszer automatikusan felismeri az alaplapok vezérlőit, ellenőrzi a sorozatszámokat, beállítja a hitelesítő adatokat, majd átmeneti környezetbe helyezi a csomópontokat.
Ezután ellenőrzik a fizikai hardvert, frissítik a firmware-t, alkalmazzák a szükséges metaadatokat, és validálják a rendszereket, mielőtt azok éles környezetbe kerülhetnének. A CoreWeave a Mission Control platformot a Racky rackkezelési réteggel és a Valvey programozható folyadékhűtési vezérléssel egészítette ki. Ezek a Rack LifeCycle Controller mellett a számítási kapacitás életciklusához kapcsolják a tápellátást, a hűtési kört és a környezeti érzékelést.
A teljesítmény minden szintjét ellenőrzik
A CoreWeave először csomóponti szinten teszteli a rendszereket. Órákon át ismételt GPU-diagnosztikát futtat, méri a CPU és a GPU közötti adatátvitelt, ellenőrzi a GPU-k közötti nagy sebességű kapcsolatokat, valamint hőterhelés mellett is vizsgálja a kártyák működését. Valósághű tanítási feladatokkal azt is figyeli, hogy a GPU-k milyen sebességgel dolgoznak és megfelelően tanulnak-e.
Rack-szinten mind a 72 GPU-t egyszerre terhelik összehangolt feladatokkal. A tesztek az NVIDIA NVLinken keresztüli kommunikációt, az inferencia- és tanítási munkaterheléseket, valamint szabványos és egyedi teljesítményméréseket is lefedik. A vártnál gyengébben teljesítő rendszer nem kerülhet gyártásba, hanem hibakeresésre irányítják.
A rackek között a CoreWeave két szintű, nem blokkoló, több sínes és több hálózati síkot használó RoCE-fabricet alakított ki. A vállalat szerint minden Rubin GPU-hoz két ConnectX-9 SuperNIC tartozik, amelyek GPU-nként legfeljebb 1,6 Tb/s háttérhálózati kapcsolatot biztosítanak. A jelenlegi moduláris kialakítás megközelítőleg 128 000 GPU-ig bővíthető két hálózati szinttel.
A klaszterszintű teszteken kikapcsolják a gyors GPU-GPU kapcsolatokat, és a forgalmat a háttérhálózatra terelik. Így az átviteli sebességet, a késleltetést, a hibákat, a túlmelegedést, az egyenetlen forgalmat és a kábelezést is ellenőrzik. A folyamatba olyan terhelési mintákat is bevonnak, amelyek az ügynöki alkalmazásokra jellemző hirtelen igény- és kommunikációs csúcsokat utánozzák.