A d-Matrix Raptor gyorsítói Nvidia NVLink-alapú rackekbe kerülnek
A d-Matrix Nvidia technológiájával épít rackméretű infrastruktúrát Raptor gyorsítóihoz, amely a vállalat szerint ultraalacsony késleltetésű következtetést tesz lehetővé nagyméretű AI-modelleken. A rendszer egy rackben akár 144 Raptor gyorsítót és körülbelül 2,3 terabájt memóriát kezelhet.
- A d-Matrix Raptor gyorsítóit Nvidia NVLink és NVFusion technológiával kapcsolja össze.
- Egy rack 144 Raptor gyorsítót és körülbelül 2,3 TB memóriát kezelhet.
- A rendszer egyetlen rackben legfeljebb 3 billió paraméteres modelleket támogathat.
- A Raptor rack GPU-rackekhez is kapcsolódhat különféle következtetési feladatok szétválasztásához.
- A tervezett négy rackes konfiguráció 576 Raptor gyorsítót és akár 10 billió paramétert céloz.
Nvidia-alapokra épül a Raptor rack
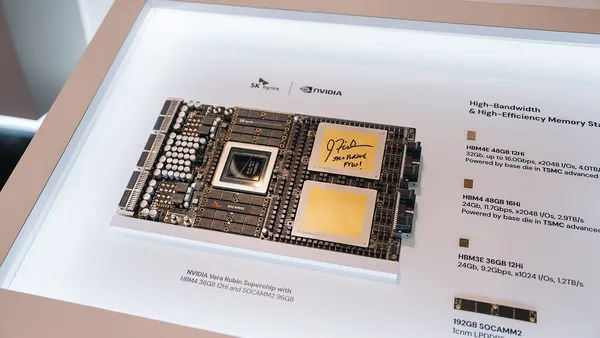
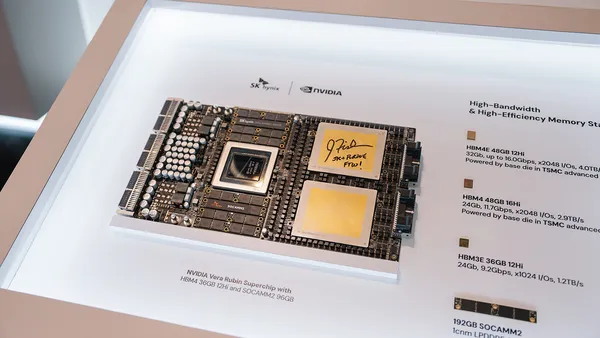
A d-Matrix szeptember 17-i bejelentése szerint együttműködik az Nvidiával annak érdekében, hogy 3D-DRAM memóriával felszerelt Raptor gyorsítóit az Nvidia NVLink skálázási hálózatával kapcsolja össze. A megoldás ugyanarra az infrastruktúrára épül, amelyet az Nvidia Vera Rubin rackméretű rendszereihez használ.
A vállalat szerint ez felgyorsíthatja a piacra kerülést, miközben a Raptor nagy memória-sávszélességét és alacsony késleltetését az Nvidia skálázási technológiájával kombinálja. Az NVLink segítségével egy rackben nagyszámú Raptor gyorsító kapcsolható össze. A rendszer Raptor-exkluzív feladatokat és heterogén, többféle gyorsítót használó konfigurációkat is támogathat.
A rackméretű kialakítás összesen 18 gyorsító tálcát és kilenc skálázási kapcsolótálcát tartalmaz. Minden tálcán két kártya van, kártyánként négy Raptor R4 gyorsítóval. Így egy rackben 144 gyorsító és nagyjából 2,3 terabájt összesített memória állhat rendelkezésre. Egy tálca 128 gigabájt 3D-DRAM-ot tartalmaz.
A memória-sávszélesség a szűk keresztmetszet
A d-Matrix szerint a modern, nagy teljesítményű modellek több százmilliárd vagy akár több billió paramétert tartalmazhatnak, és gyakran mixture of experts, vagyis szakértőkeverékes felépítésűek. Ezeknél a következtetés során egyszerre csak a paraméterek egy része aktív, ezért a számítási teljesítmény helyett sokszor az adatok mozgatása és a memória-sávszélesség korlátozza a sebességet.
A vállalat példaként a Kimi K3 modellt említi, amely összesen 2,8 billió paramétert tartalmaz. A modell 18 szakértőt és két közös szakértőt aktivál, összesen 102 milliárd aktív paraméterrel. Ez a d-Matrix számítása szerint a teljes, sűrű modellhez szükséges számítási terhelés körülbelül 3,6 százalékát jelenti, így az adatoknak a szakértőkhöz és onnan történő továbbítása válik meghatározó akadállyá.
A Raptor ezt a problémát a vállalat szerint a GPU-kénál nagyobb memória-sávszélességre építve kezeli. A gyorsítók az aktív szakértők kisebb részhalmazát futtatják, miközben kisebb modelleket is képesek önállóan tárolni, elegendő tartalékkal a hosszabb kontextusokhoz szükséges KV-cache számára.
Akár 3 billió paraméter egyetlen rackben
A d-Matrix rackméretű Raptor rendszere legfeljebb 3 billió paraméteres modelleket támogathat egyetlen rackben. A vállalat szerint az 1 billió paraméter alatti modellek, például a GLM 5.3 és a DeepSeek V4.1, hosszabb kontextusablakokkal is kezelhetők. A nagyjából 20 milliárd paraméternél kisebb munkafolyamatok egyetlen Raptor kártyán is elférhetnek.
A Raptor tálcákat tálcánként négy Nvidia ConnectX-9 hálózati kártya egészíti ki. Ezek 3,2 Tb/s skálázási sávszélességet biztosítanak, rackenként legfeljebb 57,6 Tb/s értékkel. Így a Raptor rackek Nvidia GPU-rackekhez, Vera-only rackekhez és tárolórackekhez is kapcsolódhatnak.
Ez lehetővé teszi a feladatok szétválasztását. A d-Matrix leírása szerint a GPU kezelheti az aktivációkat és a növekvő KV-cache-t, miközben a Raptor rack a feed-forward hálózat súlyait, a szakértők aktiválását és az eredmények előállítását végzi. A rendszer támogatja a spekulatív dekódolást, a prefill és decode szétválasztását, valamint az attention és FFN szétválasztását.
Nagyobb rendszer több rack összekapcsolásával
Az NVLink skálázási topológiájának fejlesztései a tervek szerint négy Raptor rack összekapcsolását is lehetővé teszik. Ez összesen 576 Raptor gyorsítót jelentene, és a d-Matrix szerint akár 10 billió paraméteres modellek támogatását célozná.
A vállalat közlése szerint egy Raptor rack összesített memória-sávszélessége 7,2 PB/s. A Kimi K3 modell 1 millió tokenes kontextus mellett a d-Matrix mérési állítása szerint felhasználónként csaknem 1000 tokent tud másodpercenként kiszolgálni. A cég a plug-and-play kialakítást azzal indokolja, hogy a Raptor előnyeit meglévő és új Nvidia-alapú adatközponti infrastruktúrákba is be lehessen illeszteni.