Az Everpure adatközpontú architektúrával készítené fel a vállalatokat az AI-ra
Az Everpure szerint a vállalati AI-projektek egyik fő akadálya, hogy az adatok feletti irányítás továbbra is az alkalmazásoknál marad. A cég új fejlesztései az adatközpontú infrastruktúrát, a hatékonyabb AI-inferenciát és az adatszuverenitást célozzák.
- Az Everpure az alkalmazások helyett az adatokat tenné az infrastruktúra középpontjába.
- A Purity DeepReduce az Everpure szerint medián 2:1 adatcsökkentést kínálhat egyes FlashBlade rendszereken.
- Az Evergreen//One késleltetésérzékeny szintjeinek minimális teljesítménye megduplázódik.
- A Pure KVA akár 20-szor gyorsabb elsőtoken-időt ígér RAG- és társalgási AI-munkaterheléseknél.
- Az AI Factory három validált referenciaarchitektúrát kínál tanításhoz és inferenciához.
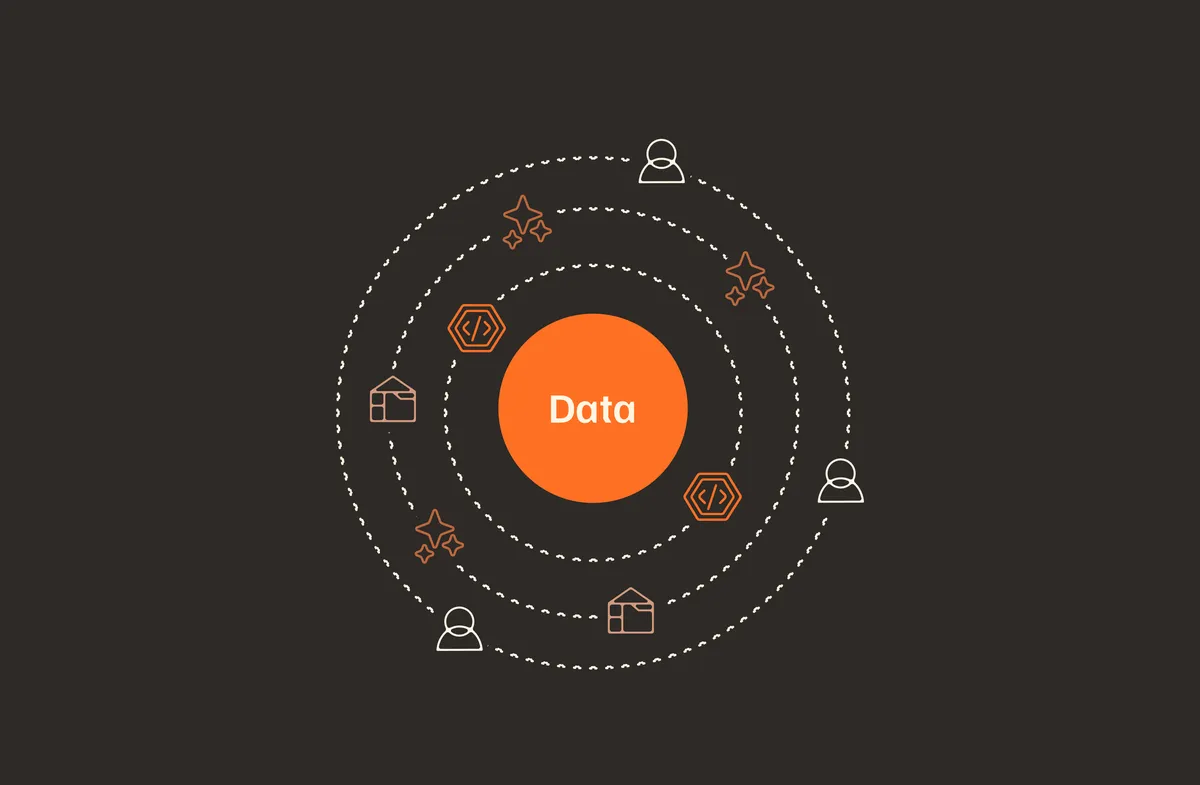
Az alkalmazások helyett az adat kerülne középre
A Pure Storage forrásaként megjelölt Everpure Blog szeptember 30-i bejegyzése szerint az elmúlt két évtizedben az alkalmazások számítottak a vállalati informatikai környezet központjának. Ezek határozták meg, hol találhatók az adatok, és ki férhet hozzájuk. Az ETL, az MDM és a BI eszközkategóriái részben az ebből fakadó töredezettséget próbálták kezelni.
Az Everpure állítása szerint az AI láthatóvá tette ennek a modellnek a költségeit. A modellek ugyanis a jelentésüket adó kontextus nélkül gyakran hiányos vagy hibás válaszokat adnak. A vállalat ezt a szemléletváltást data primacy, vagyis adatelsőség néven írja le. Ennek lényege, hogy az irányítás az alkalmazásoktól magukhoz az adatokhoz kerül.
Az Everpure ennek infrastruktúraszintű megvalósítására kínálja az Enterprise Data Cloudot, amely a vállalat architekturális és működési modellje. A hozzá kapcsolódó univerzális adatinformációs réteg az Everpure és a más gyártóktól származó környezetekben is felderíti, osztályozza és feltérképezi az adatokat. A cég szerint az Everpure Platform erre építve segít egységesíteni, szabályozni és értelmezni a teljes adatállományt.
Nagyobb kapacitás és gyorsabb AI-inferencia
Az új Unified Data Plane célja, hogy ugyanaz az adat-alapú réteg különböző munkaterheléseket, az archiválástól az AI-ig, kezeljen. A Purity DeepReduce a hagyományos deduplikációval szemben nem csak azonos blokkokat keres, hanem a blokkokon belüli hasonlóságokat is. Az Everpure szerint ez a már tömörített adatoknál is eredményes lehet.
A DeepReduce folyamatosan működik a FlashBlade rendszereken, ütemezés és írási késleltetés nélkül. A vállalat mediánértékként 2:1 arányú globális adatcsökkentést ad meg a FlashBlade//E és FlashBlade//S rendszereknél, a FlashBlade által biztosított tömörítésen felül.
Az Evergreen//One késleltetésérzékeny szolgáltatási szintjein megduplázták a minimális teljesítményt. Az UBF Performance 1 GB/s-ról 2 GB/s-ra, a Premium 2 GB/s-ról 4 GB/s-ra, az Ultra pedig 3 GB/s-ról 6 GB/s-ra emelkedik. A közlemény szerint a meglévő ügyfelek az új minimumot azonnal megkapják, megújítás nélkül.
A Pure Key-Value Accelerator háromszintű memóriamodellt használ, és az Everpure szerint akár húszszorosára gyorsíthatja a válasz első tokenjének megérkezését RAG- és társalgási AI-munkaterheléseknél. A fejlesztés támogatja a konténeres végrehajtást, az NVIDIA Dynamo környezetet és a vállalati több-bérlős működést.
Hibrid AI, virtualizáció és vállalati fájlok
Az Everpure az Intelligent Token Optimization nevű referenciaarchitektúrát az olcsóbb hibrid inferencia eszközeként mutatja be. A megközelítés nyílt forráskódú modelleket használhat helyszíni infrastruktúrán, miközben a felhőalapú AI-szolgáltatások akkor maradnak bevonhatók, amikor azok indokoltak. A cél a munkaterhelések tudatos elhelyezése, az adatok vállalati környezethez közeli tartása és az adatmozgatás mérséklése.
A Red Hat OpenShift Virtualization Microsoft Azure-on, az Everpure Clouddal, ugyanazon környezetben futtat virtuális gépeket és konténeres munkaterheléseket. Az Everpure szerint a tárolás és a számítás szétválasztása, valamint a vékony kiosztás, a deduplikáció és a tömörítés akár 40 százalékkal is csökkentheti a felhős tárolási költségeket.
A Portworx lehetővé teszi, hogy a GPU- és AI-munkaterhelések helyi NVMe-meghajtókat és felhős meghajtókat használjanak ugyanazon csomóponton és fürtön belül. Az AI Factory with Red Hat AI három validált referenciaarchitektúrát kínál: tanítást, hibrid inferenciát, valamint a Pure KVA-val párosított inferenciát. A tanítási változat már elérhető, a másik kettőt a bejegyzés szerint októberre tervezik.
A fejlesztések a vállalati fájlok kezelésére is kiterjednek. A FlashBlade realms fájlrendszer- és objektumtárolási több-bérlős működést biztosít, míg a File QoS korlátozza a teljesítményt az egyes környezeteken belül. Az Everpure szerint így a fájladatok elkülönítése, kezelése és helyreállítása nagy léptékben is megoldható.
A felhasználók számára a bejelentés fő üzenete, hogy az AI-infrastruktúra kialakítását az adatok elhelyezéséhez, kezeléséhez és védelméhez igazítanák. A vállalat a meglévő infrastruktúra jobb kihasználását, a felhős rugalmasság megtartását és a kísérleti AI-projektek gyártási környezetbe vezetésének kisebb kockázatát ígéri.
Pure Storage: Stronger Sovereignty, Better AI: It Starts with Controlling Your Data