A Fireworks AI elindította a valós munkát mérő modellindexet
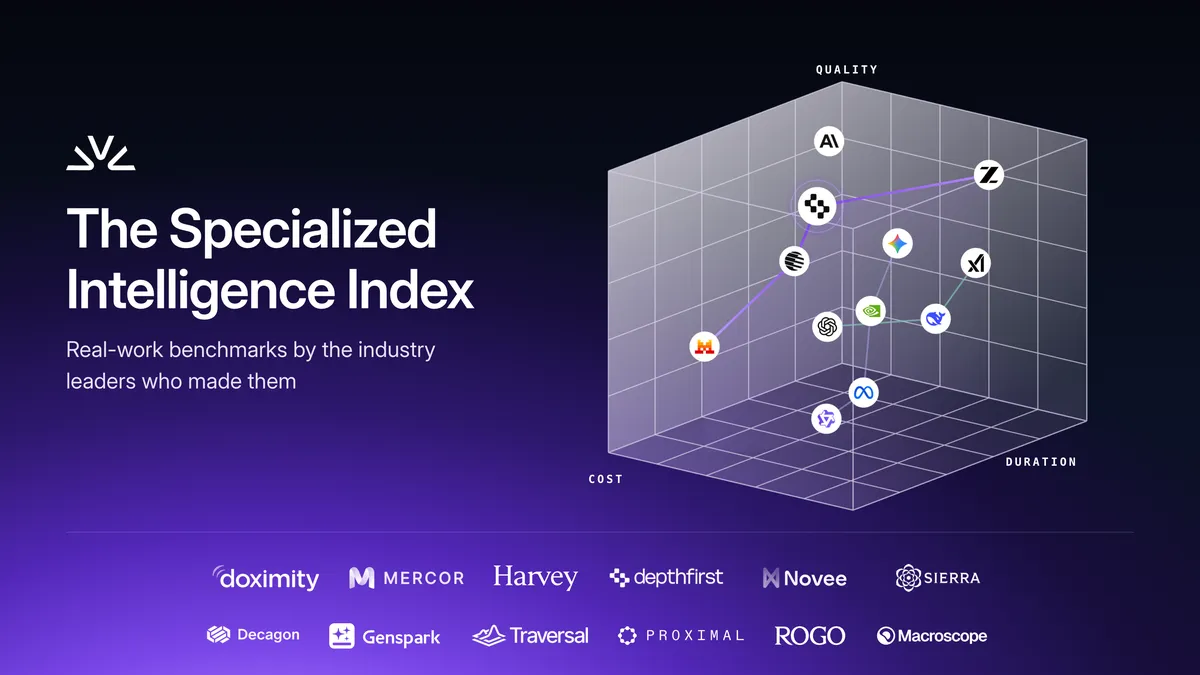
A Fireworks AI elindította a Specialized Intelligence Indexet, amely iparág-specifikus, gyakorlati feladatokon méri a nyílt, zárt és specializált AI-modellek teljesítményét. Az index kezdetben hét terület benchmarkjait gyűjti össze: az egészségügyet, a jogot, a kiberbiztonságot, a pénzügyet, az ügyfélszolgálatot, a produktivitást és a szoftverfejlesztést.
- A Specialized Intelligence Index hét kezdeti terület benchmarkjait gyűjti össze.
- Az index nyílt, zárt és specializált modelleket hasonlít össze.
- A teszteket valós munkafolyamatokhoz és szakmai elfogadási feltételekhez igazítják.
- A Fireworks AI szerint a benchmarkpontszám önmagában nem bizonyít üzleti hasznot.
- Az indexbe további benchmarkok és területek kerülhetnek be.
A szabványos teszteknél több kell a valós munkához
A Fireworks AI szeptember 22-én mutatta be a Specialized Intelligence Indexet, röviden SII-t. A vállalat szerint a nyilvános benchmarkok hasznos közös viszonyítási pontot adnak, de önmagukban nem feltétlenül mutatják meg, hogy egy modell képes-e valódi emberi feladatok automatizálására.
A valós munka gyakran hiányos információból, változó hatókörből, üzleti korlátokból, összetett döntési helyzetekből, több lépésből álló munkafolyamatokból és együttműködésből épül fel. Ezzel szemben a hagyományos értékelések jellemzően rögzített adathalmazokra, behatárolt feladatokra és szabványosított pontozásra támaszkodnak.
A Fireworks AI a METR korábbi eredményeit is idézi. Négy karbantartó 296, AI által létrehozott pull requestet vizsgált három SWE-bench Verified-repozitóriumban, és az emberi elfogadási pontszámok átlagosan 24,2 százalékponttal maradtak el az automatizált benchmarkpontszámoktól. A METR megfogalmazása szerint „sok, a SWE-bench tesztjén átmenő pull requestet nem olvasztanának be a main ágba”.
Gyakorlati szakemberek alakítják a teszteket
Az SII megközelítése szerint egy benchmark eredménye önmagában csak egy meghatározott feladatsoron, rögzített protokoll mellett mért teljesítmény. Ahhoz, hogy ebből képességre vonatkozó állítás szülessen, azt is igazolni kell, hogy a rendszer ismeretlen esetekben, megbízhatóan el tudja végezni az adott munkatípust. Az üzleti eredményhez további bizonyíték kell arról, hogy a teljesítmény elfogadható minőség és költség mellett hasznos eredményt hoz.
A benchmarkok kialakítását a Fireworks AI szerint az adott terület gyakorlati szakembereinek kell segíteniük. Meg kell határozni a feladatot, a felhasználókat, az emberi felügyelet szintjét, a minőségi küszöböket, valamint az idő- és költségkorlátokat. A teszteknek rutinfeladatokat és nehéz eseteket is tartalmazniuk kell, továbbá a munkához használt információkat, eszközöket, jogosultságokat és szabályokat is tükrözniük kell.
Az elfogadási feltételeket szakmai rubrikákban kell rögzíteni, különbséget téve a kisebb hibák és az elfogadhatatlan eredmények között. Az automatikus értékelést szakértői felülvizsgálattal is össze kell vetni, hogy feltárhatók legyenek a téves elfogadások, a téves elutasítások és az értékelők közötti eltérések. A Fireworks AI szerint a megbízhatóság vizsgálatához az ismételt futtatásokat, a bizonytalanságot, a feladattípusonkénti teljesítményt és a kritikus hibák arányát is jelenteni kell.
Hét terület benchmarkjai kerültek az induló indexbe
Az egészségügyi kategóriában szerepel többek között a Doximity BedsideBench v0.2.0, amely 500, orvosok által validált klinikai esetben vizsgálja az orvosi gondolkodást, a számításokat, a gyógyszerbiztonságot, az irányelvek követését, a hallucinációkat, a diagnosztikai biztonságot és a kezeléstervezést. A Mercor APEX-1: General Practitioner (MD) Benchmarkja az alapellátás diagnosztikai, kivizsgálási és biztonságos továbbirányítási feladatait méri.
A jogi benchmarkok között található a Harvey Legal Agent Benchmarkja, amely 24 jogterületen vizsgálja a fájlok kezelését és szakmai munkatermékek elkészítését. A pénzügyi kategóriában a Rogo Big Finance Bench olyan feladatokat fed le, mint az értékelési modellek, a pénzügyi kimutatások elemzése és az előrejelzés.
A kiberbiztonsági tesztek között a depthfirst dfbench v1 a sérülékenységek felismerését, validálását és összehasonlító elemzését vizsgálja. Az ügyfélszolgálati kategóriában a Decagon DuetBench-Diagnosis valós ügyféltámogatási vizsgálatokat játszik újra, és az eredményt, a vizsgálatot, az eszközhasználatot, valamint a kommunikációt értékeli. A Sierra τ-Banking benchmarkja egy 698 dokumentumból álló tudásbázis használatát és több lépésből álló eszközhívásokat tesztel 21 termékkategóriában.
A produktivitási területen a Genspark Slides Benchmark deidentifikált, valós felhasználói feladatokon értékeli az AI által készített prezentációkat. A pontozás a feladat teljesítésére, a tartalom minőségére, a vizuális kialakításra és a folyamat minőségére is kiterjed. A Fireworks AI szerint további területek és benchmarkok érkeznek az indexbe, amelyhez a szervezetektől benchmarkok és modellek beküldését is várják.
Fireworks AI: Introducing The Specialized Intelligence Index