A Google Research szerint korlátos a genetikai kockázatbecslés átvitele népességek között
A Google Research 2026. szeptember 3-án ismertetett kutatása azt vizsgálta, hogyan javítható a genetikai kockázatbecslés alulreprezentált népességekben. Az eredmények szerint az európai kohorszokból származó transzfer tanulás kis célpopulációknál segíthet, nagyobb célmintáknál viszont ronthatja a pontosságot.
- A Google Research UK Biobank és Biobank Japan adatokon vizsgálta a PRS-ek populációk közötti átvitelét.
- Nyolc klinikailag releváns tulajdonságot elemeztek, köztük BMI-t, vérnyomást, HDL-t, LDL-t és vércukorszintet.
- Az európai adatok kis célmintáknál segítettek, de 15 ezer vagy több BBJ-mintánál a célpopulációs modellek jobban teljesítettek.
- Konzerváltabb tulajdonságoknál az európai adatok haszna 25 ezer és 40 ezer vagy több célmintáig is megmaradhatott.
- A metaanalízis főként populációspecifikusabb tulajdonságoknál, például HDL és LDL esetén javított.
Miért gond a jelenlegi genetikai kockázatbecslés?
A poligénes kockázati pontszámok, vagyis a PRS-ek genetikai variánsok alapján becsülik meg a betegségek kockázatát. A Google Research bejegyzése szerint ezek a pontszámok jellemzően több száz vagy akár több millió genetikai variáns hatását foglalják össze.
A klinikai döntéshozatalban mégis alacsony az elfogadottságuk. Ennek egyik oka, hogy a történeti genomasszociációs vizsgálatok, vagyis GWAS-ok túlnyomórészt európai kohorszokra épültek. A Google Research szerint emiatt súlyos pontosságcsökkenés jelentkezik, amikor az így készült modelleket nem európai populációkra alkalmazzák.
A kutatók a pontossági különbségeket több tényezővel magyarázzák: eltérő genetikai architektúrákkal, populációs szerkezettel és variáns allélgyakoriságokkal. A probléma gyakorlati oldala is jelentős, mert több százezer főre kiterjedő új GWAS-vizsgálatok elvégzése a legtöbb egészségügyi rendszer számára költségkorlátokba ütközik.
UK Biobank és Biobank Japan adatokon tesztelték a módszereket
A Google Research célja az volt, hogy empirikus iránymutatást adjon arra, miként érdemes több népességből származó GWAS-adatokat és PRS-modelleket használni, ha a cél egy adott populációban a prediktív teljesítmény javítása.
A vizsgálatban az európai minták a UK Biobankból, a japán minták a Biobank Japanból származtak. A forrás szerint a Biobank Japan közel 200 ezer japán résztvevőt tartalmazó, részletesen fenotipizált kohorsz. A kutatók azt nézték meg, hogyan vihetők át a több százezer európai személyből származó UK Biobank PRS-ek a Biobank Japan mintáira.
Nyolc klinikailag releváns, mindkét populációban mért tulajdonságot vontak be: testtömegindex, szisztolés vérnyomás, diasztolés vérnyomás, vörösvértestszám, fehérvérsejtszám, HDL-koleszterin, LDL-koleszterin és vércukorszint. A UK Biobankban a mért genetikai variánsok által magyarázott tulajdonságvariancia becsült aránya 0,07 és 0,28 között mozgott.
Három megközelítést értékeltek. Az elsőben UK Biobank GWAS alapján azonosított variánsokat használtak, majd elastic net modelleket tanítottak különböző Biobank Japan és UK Biobank mintaméret-kombinációkon. Tulajdonságonként 12 vagy 13 BBJ-mintaméretet párosítottak hét UKB-mintamérettel, ami 96 vagy 104 PRS-modellt adott tulajdonságonként. A második módszer metaanalízissel kombinálta a teljes UKB GWAS-t és a mintázott BBJ GWAS-t. A harmadik a PRS-CSx modellt alkalmazta, amelyet a populációk közötti kapcsoltsági egyensúlyhiánybeli különbségek kezelésére terveztek. Az összes kísérletben ugyanazon félretett BBJ-mintákon értékelték a modelleket.
A több külső adat nem mindig javítja a becslést
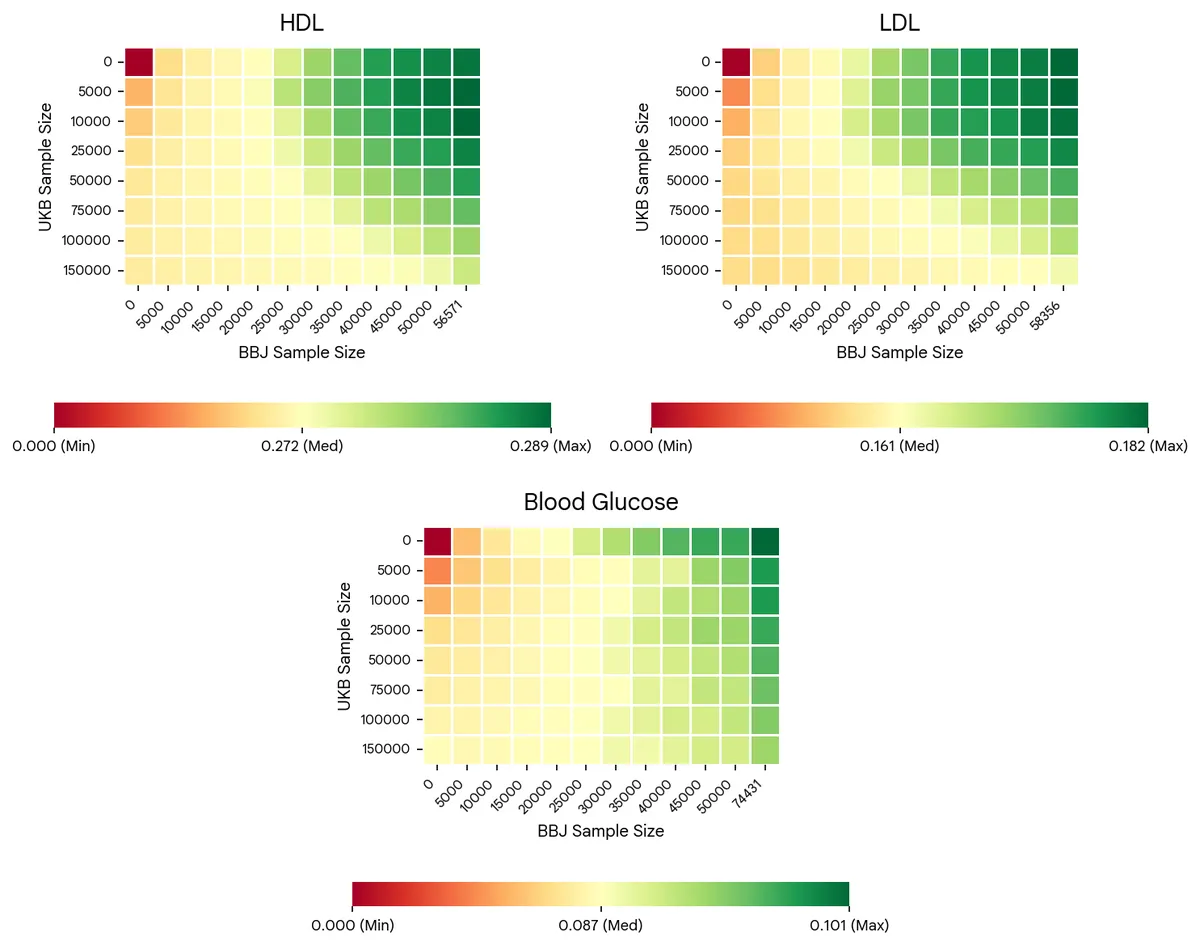
A modellek teljesítményét Pearson-korrelációval mérték. A Google Research szerint az európai felfedező adatok hasznos kiindulási alapot adnak, ha kevés vagy egyáltalán nincs célpopulációs adat. Amikor azonban a célpopulációs minta mérete eléri vagy meghaladja a 15 ezret, a célpopulációra épülő modellek jobban teljesítenek.
A HDL-koleszterin példáján a kutatók azt találták, hogy a 15 ezer BBJ-mintán túli tartományban több mint 5 ezer UKB-minta bevonása csökkentette a prediktív teljesítményt ahhoz képest, mintha csak célpopulációs adaton tanítottak volna. A forrás szerint ez a megfigyelés minden vizsgált fenotípusnál fennállt.
Nagyon kis célminta esetén, például 5 ezer mintánál, az európai UKB-adatok bevonása statisztikai előnyt adott. Ahogy nőtt a PRS-modell tanításához használt célpopulációs minta, a külső populációból származó adatok haszna csökkent.
A határ nem minden tulajdonságnál ugyanott jelent meg. A Google Research a populációk közötti azonos tulajdonságra számolt genetikai korrelációval jellemezte a „közös genetika” mértékét. Azoknál a konzerváltabb tulajdonságoknál, amelyeknél magasabb volt a két populáció közötti genetikai korreláció, az UKB európai tanítóadatok előnye nagyobb BBJ-mintaméretig, 25 ezer és 40 ezer vagy több mintáig megmaradhatott. A lipidértékeknél, vagyis HDL és LDL esetén, valamint a vércukorszintnél viszont kisebb BBJ-mintaméret után csökkent az optimális UKB-mintaméret, mert ezek a tulajdonságok a forrás szerint populációspecifikusabb genetikai architektúrát mutattak.
Mit adott hozzá a metaanalízis és a PRS-CSx?
Az első kísérletsorozat csak a UKB európai populációjában felfedezett variánsokra korlátozta a PRS-modellek bemenetét. Ez kizárta azokat a tulajdonsághoz kapcsolódó variánsokat, amelyek egyediek lehetnek a BBJ-mintákban. Ennek kezelésére két további predikciós módszert hoztak létre.
Az egyik módszer minden BBJ-mintaméretre GWAS-t futtatott, majd a teljes UKB GWAS-t és az adott méretű BBJ GWAS-t metaanalízissel kombinálta a jelölt variánsok kiválasztásához. Ezután elastic net modellt illesztettek ezekre a variánsokra. A másik módszer a PRS-CSx-et használta a két GWAS-összegző statisztika kombinálására.
A Google Research szerint a metaanalízis hatása a konzervált tulajdonságoknál alacsony volt, főként a jóval kisebb BBJ GWAS-mintaméretek csökkent statisztikai ereje miatt. Populációspecifikusabb tulajdonságoknál, például HDL és LDL esetén, valamint kisebb mértékben a vércukorszintnél a metaanalízis jelentősen felülmúlta az egyetlen populációra épülő felfedezést.
A nyereség főként abból származott, hogy módosult az elastic net modellbe kerülő variánskészlet. A UKB európai minták tanításba vonása enyhén javította a predikciót akkor, ha 10 ezer vagy annál kevesebb BBJ-minta állt rendelkezésre. Nagyobb BBJ-mintáknál ez a javulás nem jelent meg.
Mit jelent ez a felhasználóknak és a piacnak?
A kutatás üzenete az, hogy a genetikai kockázatbecslésben a nagy európai adatkészletek használata csak bizonyos helyzetekben előnyös. Kis alulreprezentált célpopulációs mintáknál javíthatják a becslést, de a célpopulációs adatok növekedésével korlátozhatják a pontosság további javulását.
Ez különösen fontos azoknak a kutatócsoportoknak és egészségügyi szereplőknek, amelyek nem európai populációkban szeretnének PRS-modelleket használni. A Google Research eredményei alapján a modellépítésnél figyelembe kell venni a célpopuláció mintaméretét és az adott tulajdonság populációk közötti genetikai hasonlóságát. A forrásból az következik, hogy nincs minden tulajdonságra és minden populációra azonos adatkeverési stratégia.
Google Research: Transfer learning for genomic prediction in underrepresented populations