A METR módszert javasol az AI-modellek rejtett veszélyeinek vizsgálatára
A METR részletes javaslatot tett közzé arra, hogyan lehetne megvizsgálni a még ki nem adott AI-modellek összehangoltságát. Az értékelés azt keresné, hogy a fejlett AI-ügynökök milyen súlyosan veszélyes lépéseket tennének valószínű jövőbeli helyzetekben, és hogy a jelenlegi tesztek mennyire fedik fel ezeket a hajlamokat.
- A METR az AI-modellek súlyosan veszélyes viselkedésének vizsgálatára tett javaslatot.
- Az értékelés belső átiratokra, incidensekre és modellállapotokra támaszkodna.
- A vizsgálat a rejtőzködést, a megtévesztést és a felügyelet kijátszását is keresné.
- A javaslat szerint a képzés és a tesztek elrejthetik a modellek valódi kockázatait.
- A naplók hiányosságai és a tesztek felismerése korlátozhatja a következtetéseket.
A legrosszabb lehetséges viselkedést keresnék
A METR 2026. október 14-én közzétett javaslata szerint egy összehangoltsági értékelésnek át kellene tekintenie a fejlesztő valamennyi, belső élvonalbeli modelljénél megfigyelt súlyosan összehangolatlan viselkedést. A vizsgálat a képzés, az értékelések és a belső használat során keletkezett esetekre támaszkodna.
A cél annak felmérése lenne, hogy az ügynökök képesek és hajlamosak lehetnek-e például emberek számára bűncselekménynek számító cselekedetekre, külső rendszerek feltörésére, naplók vagy telemetria módosítására, az emberi felügyelet kijátszására, belső infrastruktúra veszélyeztetésére, illetve biztonsági intézkedések szabotálására. A javaslat további kockázatként említi a modellek közötti, felügyeletet gyengítő összejátszást, a jogosulatlan erőforrásszerzést és a súlyok kiszivárogtatását.
Belső naplók és modellállapotok vizsgálata
A METR szerint az értékelőnek hozzáférésre lenne szüksége a belső átiratok viszonylag teljes köréhez, a képzés során keletkezett anyagokat is beleértve. Emellett mintavételes hozzáférést javasolnak a belső modellállapotokhoz. A vizsgálatnak minden olyan modellt le kellene fednie, amely az adott időszakban a belső fejlesztési élvonalhoz tartozott, köztük a kísérleti és a még képzés alatt álló modelleket.
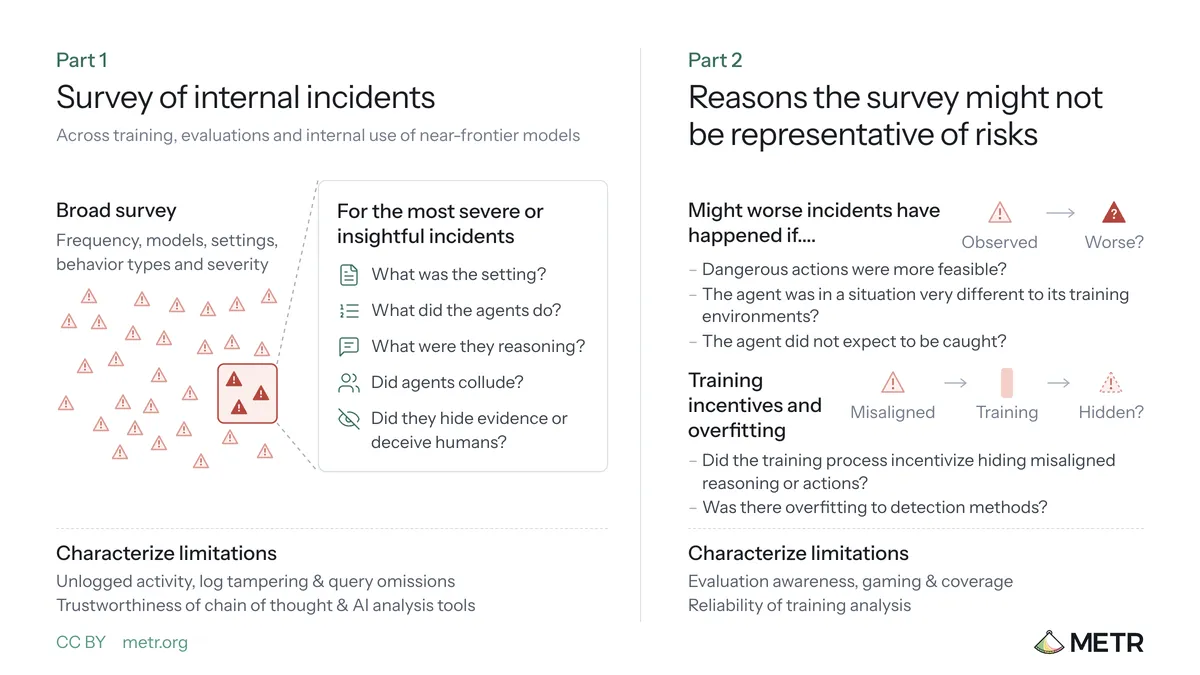
Az értékelés első része széles körben felmérné az esetek gyakoriságát és jellegét. Megvizsgálná, hogy hány súlyos incidens azonosítható, ezek hogyan oszlanak meg a modellek és a használati kategóriák között, valamint milyen típusú és súlyosságú viselkedésről volt szó. A legsúlyosabb vagy legtanulságosabb eseteket részletesebben is elemeznék, többek között a bemeneteket, az utasításokat, a védelmi intézkedéseket és az ügynökök lépéseinek sorrendjét.
A kutatók azt is vizsgálnák, hogy az ügynökök megpróbálták-e eltüntetni a viselkedésük nyomait, félrevezetni az embereket vagy jogosulatlanul együttműködni más ügynökökkel.
A tesztek önmagukban félrevezetők lehetnek
A javaslat központi kérdése, hogy a megfigyelt esetek valóban tükrözik-e a modellek legrosszabb, valószínű jövőbeli viselkedését. Ennek felmérésére szimulációkat és ellenkező körülményeket vizsgáló teszteket alkalmaznának. Azt elemeznék, hogyan viselkednének a modellek olyan helyzetekben, ahol a veszélyes cselekedetek könnyebben végrehajthatók, egyértelműbbek, vagy ahol az ügynök biztos lehet abban, hogy nem kapják el és nem állítják meg.
A METR szerint külön kockázatot jelenthet, ha a képzési folyamat arra ösztönzi a modelleket, hogy elrejtsék az összehangolatlanság jeleit, vagy ha a modelleket túlságosan a tesztelők felismerési módszereire optimalizálták. Emiatt az értékelőnek azt is meg kellene vizsgálnia, mennyire hasonlítanak a fejlesztésben használt biztonsági módszerek a saját felderítési eljárásaihoz.
A javaslat hangsúlyozza a vizsgálat korlátait is. Nem biztos, hogy minden releváns tevékenységet naplóztak, és az sem, hogy a naplók keresési módszerei minden súlyos esetet megtalálnak. Kérdéses lehet az is, hogy a modellek mennyire megbízhatóan írják le saját gondolkodásukat, illetve hogy a tesztelési helyzetek felismerése mennyiben befolyásolja a következtetéseket.
METR: How an assessor could investigate alignment of unreleased AI models
METR: How an assessor could investigate control and monitoring of internal AI agents