Az MLCommons az AIRIS projektben méri majd az orvosi AI megbízhatóságát
Az MLCommons csatlakozott az uniós finanszírozású AIRIS kutatási projekthez, amely biológiai ismereteket és klinikai adatokat integráló generatív AI-modelleket fejleszt. A szervezet független értékelési rendszert és benchmarkokat készít a platform pontosságának, robusztusságának, méltányosságának, értelmezhetőségének és használhatóságának mérésére.
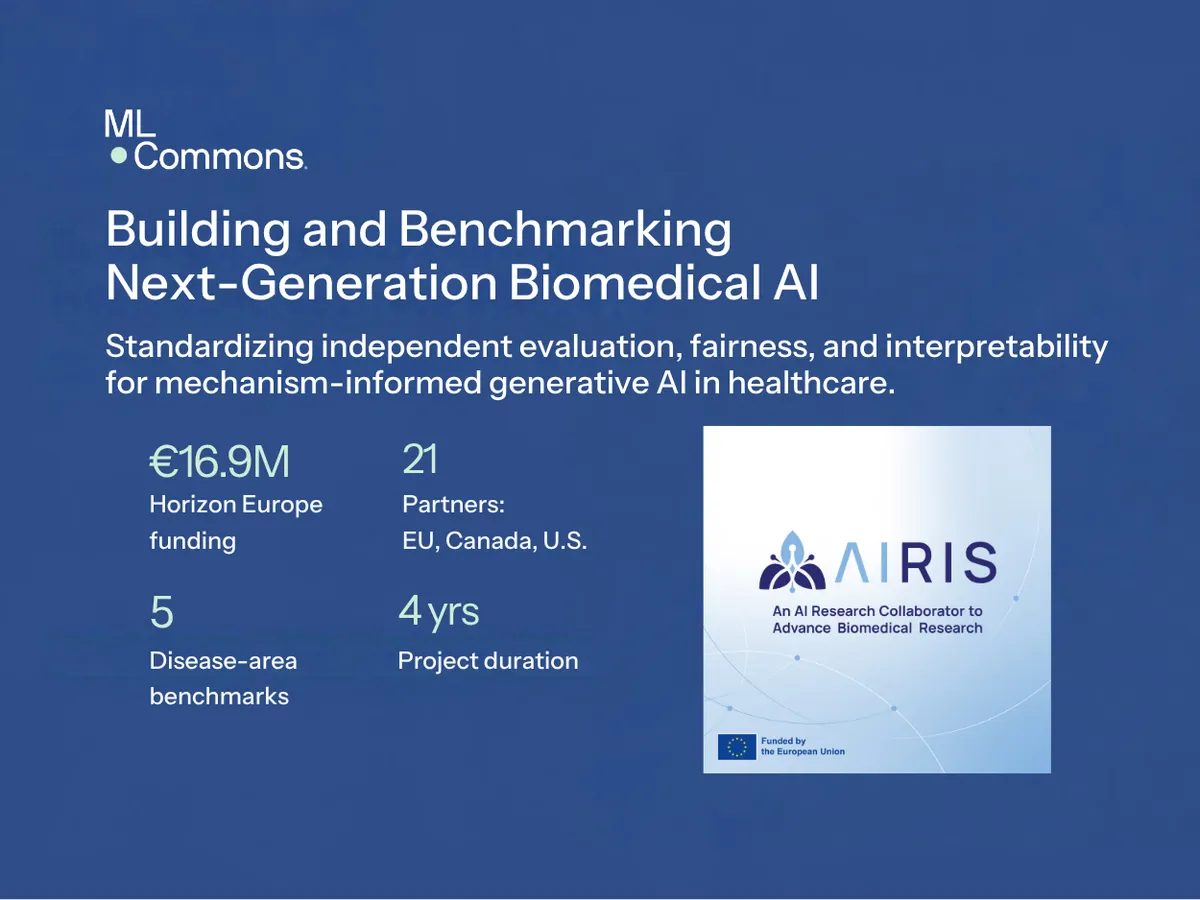
- Az AIRIS 21 európai, kanadai és amerikai partner közös projektje.
- A Horizon Europe program négy évre 16,9 millió eurót biztosít.
- Az MLCommons független értékelési keretrendszert és benchmarkokat fejleszt.
- A tesztek a pontosságot, robusztusságot, méltányosságot, értelmezhetőséget és használhatóságot mérik.
- A benchmarkokat külső kutatók saját adatokkal is használhatják.
21 partner dolgozik a biomedicinai AI-rendszeren
Az AIRIS, vagyis a Mechanism-Informed Multimodal Generative AI for Causal and Dynamical Modeling in Biomedical Research projekt az Európai Unió Horizon Europe programjának támogatásával valósul meg. A kezdeményezésben 21 európai, kanadai és amerikai partner vesz részt.
A konzorcium a következő négy évben 16,9 millió eurós finanszírozásból fejleszt generatív AI-platformot. A cél egy olyan AI-alapú kutatási munkatárs létrehozása, amely segít jobban megérteni a betegségek előrehaladását, és támogatja a személyre szabott orvoslás fejlődését.
Az AIRIS olyan modelleket kíván építeni, amelyek a biológiai tudást és a klinikai adatokat együtt kezelik. A platform a betegségek mechanisztikus modelljeit építi fel és ezekkel következtet, így a projekt célja szerint nem kizárólag statisztikai mintázatokra támaszkodik. A kutatók ettől korábban ismeretlen betegségi útvonalak azonosítását és új tudományos hipotézisek kidolgozását várják.
Öt betegségterületre készülnek benchmarkok
Az MLCommons a mesterségesintelligencia-rendszerek teljesítményének összehasonlítására szolgáló benchmarkok fejlesztésében szerzett tapasztalatára építve kap központi szerepet az AIRIS értékelésében. A szervezet egy átfogó értékelési keretrendszert és integrált benchmarkcsomagot vezet fejlesztésre.
A mérési rendszer öt szempontot vizsgál: a pontosságot, a robusztusságot, a méltányosságot, az értelmezhetőséget és a használhatóságot. Külön benchmark készül mind az öt betegségterülethez, valamint a betegek alcsoportjai közötti torzítások felismerésére. Az értékelés olyan szempontokat is figyelembe vesz, mint a nem, az etnikum és az életkor.
„A szigorú, független értékelés alakítja át az ígéretes AI-rendszert olyanná, amelyben a kutatók valóban megbízhatnak”, mondta Alexandros Karargyris, az MLCommons Medical munkacsoportjának vezetője. Hozzátette, hogy nyílt benchmarkokkal szeretnék vizsgálni a pontosság mellett a méltányosságot, a robusztusságot és az értelmezhetőséget is valós betegségi környezetekben.
Külső kutatók is tesztelhetik majd a rendszert
Az MLCommons az értékelési fordulókat is koordinálja. A szervezet a platform egymást követő verzióinak fejlődését követi, a benchmarkokat pedig megnyitja külső kutatók előtt. Így a tudományos közösség saját adatokon is tesztelheti az AIRIS-t.
A projekt célja, hogy a platform a multimodális, mechanisztikus modellekre épülő biomedicinai generatív AI egyik referenciaértékelésévé váljon. A forrás szerint ez átlátható mércét adhat a kutatóknak, miközben az AIRIS megbízhatóbbá teheti a komplex betegségek vizsgálatát.
Az MLCommons hosszabb távon olyan AI-kutatási együttműködést szeretne támogatni, amely a kutatási folyamat minden szakaszában segíti a tudósokat. A projekt az úgynevezett feketedobozos előrejelzéseken túl a biológiai tudásra alapozná a következtetéseit. A nyílt benchmarkok és a több szempontú értékelés a felhasználók számára azt jelentheti, hogy az AIRIS teljesítménye nem egyetlen pontossági mutató alapján, hanem több, a klinikai kutatás szempontjából fontos tényező szerint is vizsgálható lesz.