Gyorsabb párhuzamos adatbetöltést javasol a Neo4j új módszere
A Neo4j olyan adatbetöltési eljárást ismertetett, amely a szerver rendelkezésére álló munkások számához igazítja a partíciókat. A módszer külön kezeli az egymástól független, illetve az azonos csomópontkészletből származó kapcsolatok importját.
- A partíciók számát a betöltéshez rendelt munkások száma határozza meg.
- A csomópontok partícióit hashfüggvénnyel számítják ki.
- Diszjunkt csomópontkészleteknél ciklikus átlók szervezik kötegekbe a kapcsolatokat.
- Azonos csomópontkészletnél körkörös párosítás és k-1 színezés kezeli a kötegeket.
- A Neo4j későbbi cikkben ígéri a gyakorlati példát és a forráskódot.
A korábbi megközelítés korlátai
A Neo4j szeptember 23-án közzétett cikke egy korábbi, Eric MONK által bemutatott technikát általánosít. Az eredeti megoldás a forrás- és célcsomópont-azonosítók utolsó számjegyeiből hozott létre egymást nem átfedő partíciókat, majd a partíciópárokat ciklikus átlók mentén kötegekbe rendezte.
Így több köteg párhuzamosan tölthető be anélkül, hogy ugyanazokat a csomópontkészleteket egy időben érnék el a folyamatok. A Neo4j szerint azonban ennek két fontos korlátja van. A partíciók száma nem igazodik a rendelkezésre álló munkásokhoz, és az átlós kötegezés nem biztonságos akkor, ha a forrás- és célcsomópontok ugyanahhoz a készlethez tartoznak, például Person csomópontok közötti kapcsolatok létrehozásakor.
A partíciók számát a munkásokhoz igazítják
Az új javaslatban a partíciók meghatározása hashfüggvénnyel történik. Optimális import esetén a partition_count értéke megegyezik az adatbetöltéshez rendelt szerver munkásainak számával. Ez elegendő, egymástól független feladatot biztosít a munkakészlet számára, miközben a partícióhatárokat nem kell előre rögzíteni a forrásadatokban.
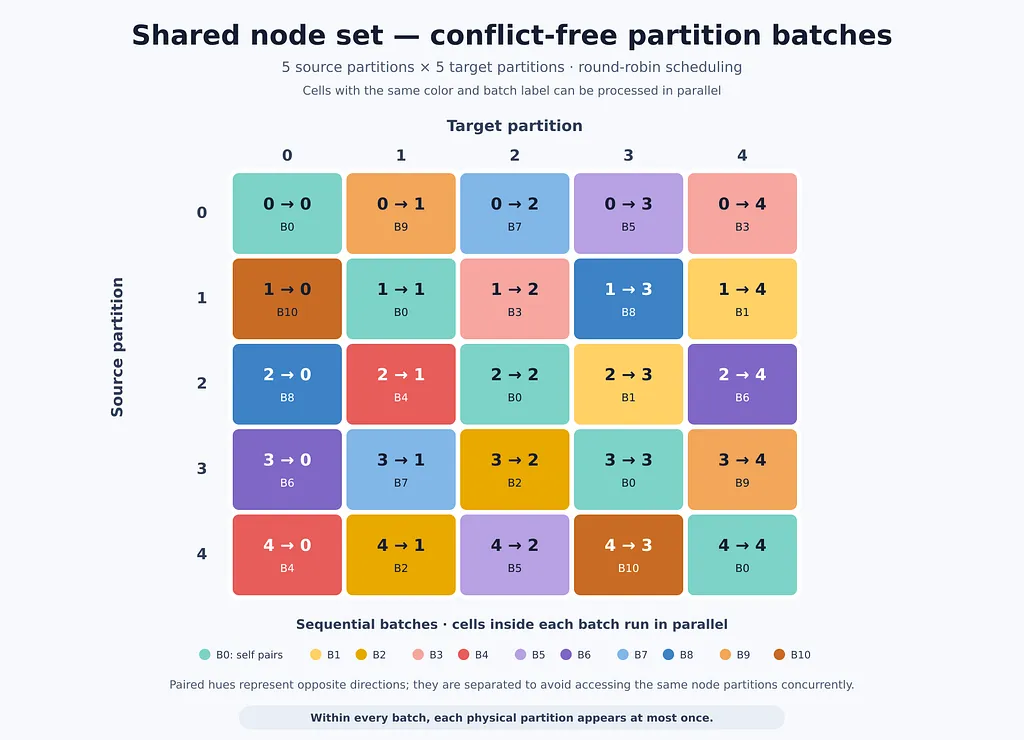
A csomóponttáblákban az export_part értéke a csomópont azonosítójának hash-értéke, modulo a partíciók számával. Ha a partíciók száma 5, akkor legfeljebb öt érték jöhet létre, 0-tól 4-ig. A kapcsolattáblákban külön számítják ki a forrás- és célpartíciót, majd ezekből áll össze az exportpartíció. Öt partíció esetén így legfeljebb 5², vagyis 25 partíciópár keletkezik, 0 - 0 és 4 - 4 között.
A Neo4j szerint az eljárás determinisztikus, és garantálja az egymástól független partíciókat. A partíciók mérete azonban nem feltétlenül lesz azonos, mert ez az adatok szerkezetétől függ.
Eltérő algoritmus kell az azonos csomópontkészlethez
A csomópontok importja egyszerűbb: minden munkás egy partíciót tölt be, így az összes partíció egy időben importálható. A kapcsolatoknál viszont a forrás- és célcsomópontok viszonya határozza meg, milyen kötegek dolgozhatók fel párhuzamosan.
Ha a két csomópontkészlet diszjunkt, a négyzetes partíciómátrix ciklikus átlói használhatók. Minden átló olyan partíciópárokat tartalmaz, amelyekben egy forrás- és egy célpartíció csak egyszer szerepel, így a köteg párhuzamosan feldolgozható holtpont és zárolási ütközés nélkül.
Azonos csomópontkészlet esetén a Neo4j a k-1 színezési algoritmust és körkörös, round-robin párosítást javasol. Az egyes kötegekben szereplő párok nem osztoznak partíción. Az önmagukra hivatkozó párok együtt feldolgozhatók, a forward és reverse párokat viszont külön kötegbe kell helyezni, mivel ugyanazokat a fizikai partíciókat használják. A Neo4j szerint ez az eljárás kevesebb partíciót tartalmaz kötegenként, ezért kevesebb feldolgozási lépést igényel az átlós módszernél.
A mostani írás az elméleti alapokat és az ötleteket ismerteti. A vállalat közlése szerint egy következő cikkben mutatják be a gyakorlati alkalmazást és a forráskódot tartalmazó tárolót.