Az NVIDIA BioIR rendszere felgyorsítja a biomolekulák szerkezetjóslását
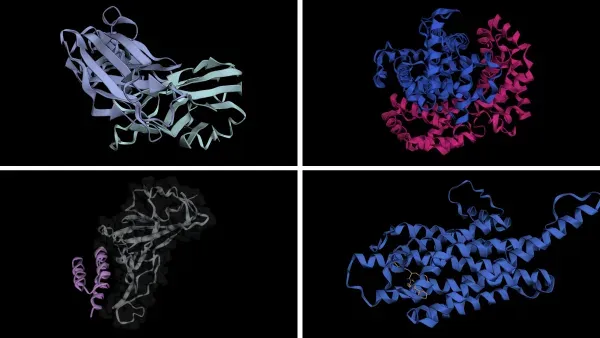
Az NVIDIA BioNeMo Inference Runtime a vállalat szerint felgyorsítja a támogatott biomolekuláris szerkezetjósló modellek futtatását NVIDIA GPU-kon. A rendszer a PyTorch-alapú munkafolyamatot megtartva a bemenet feldolgozásától a PDB vagy mmCIF kimenet előállításáig kezeli a folyamatot.
- A BioIR támogatott biomolekuláris szerkezetjósló modelleket gyorsít NVIDIA GPU-kon.
- Az end-to-end processzor a bemenettől a PDB vagy mmCIF kimenetig kezeli a folyamatot.
- A 8 H100 GPU-s tesztben 2,90-szeres normalizált áteresztőképességet mértek.
- Az NVIDIA becslése szerint egymillió célpont hajtogatása 11 MWh energiát igényelt a BioIR-rel.
- A rendszert 4777 proteom és körülbelül 31 millió jelölt komplex feldolgozásánál is használták.
Nagy munkalisták feldolgozására készült
A biomolekuláris szerkezetjóslást egyre gyakrabban proteomszinten végzik, vagyis teljes munkalistákat kell hatékonyan végigfuttatni a rendszeren. Az NVIDIA szeptember 10-én bemutatott BioNeMo Inference Runtime, röviden BioIR, ehhez kínál futtatási környezetet a támogatott modellekhez.
A BioIR optimalizált kerneleket használ, és ahol alkalmazható, CUDA Graphs technológiával gyorsítja a modell végrehajtását. A rendszer kétféleképpen használható. Az end-to-end processzor az InputRequest objektumot a feldolgozás minden fő lépésén végigviszi: a beolvasáson, a tokenizáláson, a jellemzők előállításán, a GPU-s következtetésen, majd a PDB vagy mmCIF formátumú íráson.
A másik lehetőség a közvetlen PyTorch-integráció. Ezzel támogatott modellt, illetve kiválasztott modulokat lehet egyedi kódban felhasználni. A BioIR végrehajtási rétege a megszokott PyTorch-munkafolyamatot igyekszik megőrizni.
A Ray több GPU-n párhuzamosítja a munkát
Független bemenetek nagyobb halmazánál a BioIR Ray végrehajtót használhat. Ennek alapértelmezett működése szerint egyetlen csomópont minden látható GPU-jára egy teljes modellreplika kerül. A CPU-s feldolgozási lépések így párhuzamosan futhatnak a GPU-s szerkezetjóslással.
Az end-to-end folyamat öt szakaszból áll: parser, tokenizer, feature generator, folding engine és writer. A Ray-konfigurációban ezek külön beállíthatók, így a feldolgozási kapacitás az adott munkalista és a rendelkezésre álló GPU-k szerint hangolható. Az NVIDIA példája négy GPU-s, egyetlen csomóponton működő konfigurációt mutat be. Több csomópontos telepítést a bemutató nem tárgyal.
A használathoz Python 3.12 vagy újabb verzió, kompatibilis NVIDIA GPU és illesztőprogram, valamint egy előkészített modell-ellenőrzőpont szükséges. A bemutatott példa a Boltz-2 modellt használja. A fehérjeláncokhoz A3M formátumú többszörös szekvenciaillesztés, vagyis MSA szükséges. Több, nem azonos fehérjeláncot tartalmazó bemenetnél párosított és nem párosított MSA is elfogadható.
A BioIR kernelei előre lefordított CUBIN-fájlokat tartalmaznak, ezért a futtatáshoz a forrás szerint nincs szükség nvcc-re, CUDA-forráskódra, CMake-re vagy a CUDA eszközkészletre.
A tesztben 2,90-szer nagyobb volt a normalizált áteresztőképesség
Az NVIDIA egy 1000 humán dimer célpontot tartalmazó összehasonlításban mérte a teljesítményt 8 darab H100 GPU-n. A BioIR-rel gyorsított Boltz-2 egy kiosztott GPU-órára vetítve 58,5 ezer sikeresen hajtogatott aminosavat ért el, míg egy torch.compile-lel fordított, nyílt forráskódú megvalósítás 20,2 ezret.
Az NVIDIA által közölt, maradékszámra normalizált áteresztőképesség így 2,90-szeres javulást jelentett. A vállalat energiafelhasználásra is becslést adott: egymillió, összehasonlítható célpont szerkezetének kiszámításához a BioIR esetében 11 MWh, a nyilvános megvalósításnál 35 MWh adódott, 8 GPU névleges teljesítményének megfelelő értékekkel számolva.
A BioIR optimalizációja három szinten működik. A kernelválasztás az alacsonyabb szintű műveleteket célozza, a moduloptimalizálás CUDA Graphs rögzítést is alkalmazhat, a Ray-replikák pedig a teljes feldolgozási folyamat skálázását szolgálják. Ezek különböző szűk keresztmetszetek enyhítésére készültek.
Proteomszintű alkalmazás és felhasználói lehetőségek
A BioIR-t az NVIDIA szerint valós proteomszintű munkában is használták. Az AlphaFold Database legutóbbi bővítésénél 4777 proteomon keresztül gyorsította a fehérjekomplexek szerkezetének előállítását. A teljes munkában körülbelül 31 millió jelölt komplex szerepelt, amelyek közül 1,81 milliót nagy megbízhatóságú előrejelzésként tettek közzé.
A bemutató szerint a rendszer támogatja a ligandumok szerkezetjóslását, a ligandumaffinitás előrejelzését viszont nem. Az NVIDIA a BioNeMo Inference Runtime tárházát javasolja a nagy léptékű szerkezetjósló munkafolyamatok integrálásához. A legfrissebb gyorsítási adatokat az API-referencia és a támogatási mátrix tartalmazza.
A felhasználóknak a közölt eredmények elsősorban azt jelentik, hogy több független szerkezetjósló feladatot lehet egyetlen GPU-s csomóponton párhuzamosan futtatni, miközben a modell végrehajtása és a teljes adatfeldolgozási lánc is konfigurálható. A tényleges áteresztőképesség az NVIDIA szerint a bemenetek eloszlásától, a szakaszok egyensúlyától, a tárhelytől, az ütemezéstől és az esetleges hibáktól is függ, ezért a környezetben külön mérésre van szükség.
NVIDIA Developer: High-Throughput Structure Prediction with BioNeMo Inference Runtime