C++-os mintákkal gyorsítaná a helyi AI-futtatást az NVIDIA
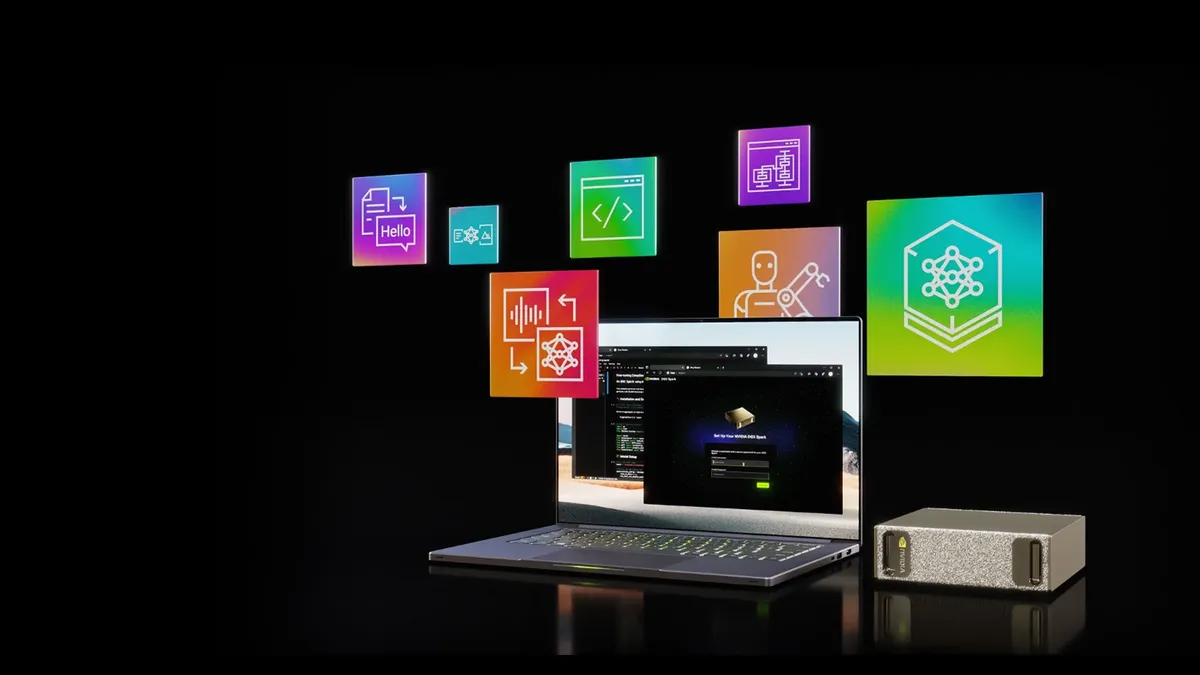
Az NVIDIA nyílt forráskódú C++-mintákat tett közzé helyi AI-alkalmazások fejlesztéséhez. A DIN Deploy az ONNX Runtime-ot és a TensorRT RTX végrehajtási szolgáltatót kapcsolja össze Windows és Linux alatt.
- A DIN Deploy ONNX Runtime és TensorRT RTX használatával kínál C++-os mintákat.
- A minták Windows és Linux alatt, x86-64 és Arm64 platformokon használhatók.
- A támogatott feladatok között beszédfelismerés, képszegmentálás és képgenerálás szerepel.
- A DGX Spark mérésén a Parakeet TDT GPU-val 206,41-szeres valós idejű értéket ért el.
- A kvantált ONNX-modell az NVIDIA szerint alkalmazáskód-módosítás nélkül behelyettesíthető.
A modellkonverziót és az alkalmazást különválasztják
Az NVIDIA Developer október 1-jén mutatta be a Do Inference Now, vagyis DIN Deploy mintagyűjteményt. A cél, hogy a fejlesztők egy modell-ellenőrzőpontból helyi, natív és hardveresen gyorsított alkalmazásig juthassanak el.
Minden minta egy Python-alapú exportálóval indul. Ez a Hugging Face-ről letöltött modell-ellenőrzőpontot ONNX-formátumú modellé alakítja. A futtatási oldal egy natív C++ parancssori alkalmazás, amely az ONNX Runtime munkamenet- és tenzorkezelő API-jaira épül.
Ez a felépítés külön kezeli a modell átalakítását és a telepítési logikát. Az NVIDIA szerint így az exportált modell helyi alkalmazásba vihető anélkül, hogy modell-specifikus futtatókörnyezetre lenne szükség. A közös kódban a gyártóspecifikus megoldások, például a CUDA API-k és kernelek, csak az opcionális gyorsítási útvonalakon jelennek meg.
Beszédfelismerés, szegmentálás és képgenerálás
A DIN Deploy többféle AI-feladathoz kínál mintát. Automatikus beszédfelismeréshez az OpenAI Whisper offline átírást biztosít különböző modellméretekben. Az NVIDIA Parakeet TDT és az NVIDIA Nemotron ASR Streaming streaming feldolgozási folyamatokat szemléltet.
A Meta SAM 2.1-re épülő minták képek és videók interaktív maszkolását támogatják. A modell kimenetei olyan szegmentációs maszkokká alakíthatók, amelyeket natív alkalmazások kijelöléshez, követéshez és más számítógépes látási feladatokhoz használhatnak.
A FLUX.2-klein-4B minta szöveges utasításokra épülő képgenerálást mutat be. A Vulkan és DirectX grafikus API-kkal kialakított együttműködés lehetővé teszi a GPU-n tárolt erőforrások integrálását egy több gyártó megoldásaival használható shaderfelületen keresztül. A DirectX-es támogatás csak Windows alatt érhető el.
A DGX Spark mérési eredményei
Az NVIDIA a kiválasztott munkafolyamatokat DGX Spark rendszeren mérte meg. A hangfeldolgozási eredményeket a valós idő többszöröseként közölték, ahol a magasabb érték gyorsabb feldolgozást jelent.
- OpenAI Whisper large-v3-turbo: 58,5-szeres teljesítmény GPU-val és 3,8-szoros CPU-val.
- NVIDIA Nemotron ASR Streaming 0.6B: 39,01-szeres GPU-s és 3,24-szeres CPU-s érték.
- NVIDIA Parakeet TDT 0.6B v3: 206,41-szeres GPU-s és 14,44-szeres CPU-s érték.
- Meta SAM 2.1 Hiera Base Plus: 38,3 képkocka másodpercenként GPU-val, szemben a CPU-n mért 0,5 képkockával.
Ezeket az adatokat az NVIDIA a DIN Deploy kiválasztott terheléseinek DGX Sparkon végzett méréseként közli.
Kvantálás és fejlesztői indulás
A FLUX.2-minta a tanítás utáni kvantálást is bemutatja az NVIDIA Model Optimizer használatával. Az így létrehozott kvantált ONNX-modell az NVIDIA szerint közvetlenül behelyettesíthető, mivel az ONNX-interfészek változatlanok maradnak, ezért az alkalmazás kódján nem kell módosítani. A kvantálás hardverfüggő.
A tárház Windows és Linux rendszerekhez, x86-64 és Arm64 platformokra is tartalmaz CMake-előbeállításokat. A projekt összeállítása után a fejlesztők ONNX-formátumba exportálhatják a modellt, majd TensorRT RTX használatával futtathatják a C++ parancssori alkalmazást. A CMake alapértelmezés szerint letölti az ONNX Runtime-ot és a TensorRT RTX-et.
A mintakódok a fejlesztők saját alkalmazásaiba is átemelhetők. Az NVIDIA a DIN Deploy mellett a TensorRT for RTX dokumentációját, az NVIDIA Local AI anyagait és a modellkvantálásról szóló blogbejegyzéseit ajánlja a további munkához.
NVIDIA Developer: Build Local AI Apps with C++ and NVIDIA TensorRT RTX Samples