Az NVIDIA szerint 40 százalékkal több GPU férhet el ugyanakkora keretben
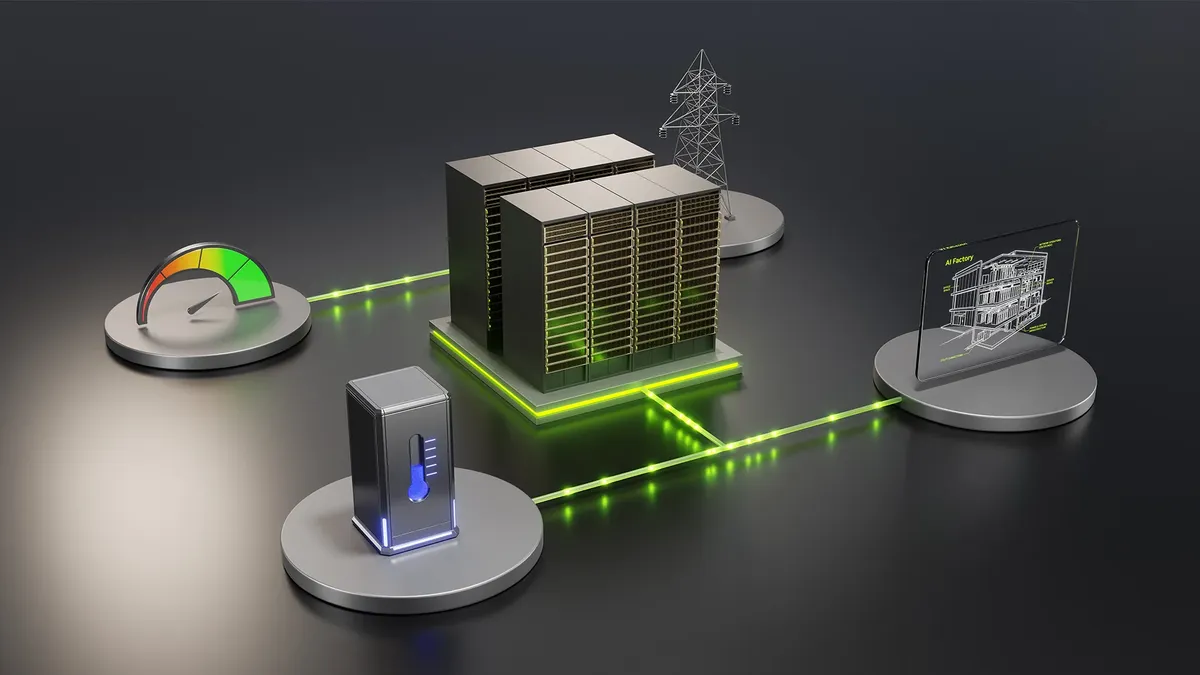
Az NVIDIA DSX MaxLPS szoftvere dinamikusan osztja újra a rendelkezésre álló teljesítményt az AI-infrastruktúra erőforrásai között. Egy NVIDIA és Nscale által végzett tesztben 140 helyett 192 GPU működött ugyanazon 264,4 kilowattos kereten, miközben az összesített áteresztőképesség 49,2 százalékkal nőtt.
- A DSX MaxLPS az NVIDIA szerint akár 40 százalékkal több GPU-t engedhet ugyanazon teljesítménykeretben.
- Az Nscale tesztjében 140-ről 192-re nőtt a kezelt GPU-k száma.
- Az összesített áteresztőképesség 49,2 százalékkal javult.
- A teszt ugyanazon 264,4 kilowattos jóváhagyott keretet használta.
- A P99-es elsőtoken-idő 17 százalékkal emelkedett.
A kihasználatlan teljesítményre épít a rendszer
Az AI-üzemek energiaellátását jellemzően úgy méretezik, hogy minden GPU és csomópont egyszerre is elérhesse a megadott csúcsteljesítményt. Ez biztonsági tartalékot jelent, a tényleges fogyasztás azonban a munkaterheléstől függően változik. A tanítási feladatok például számítási, kommunikációs, szinkronizációs és ellenőrzőpont-készítési szakaszokon haladnak át, míg a következtetési feladatoknál a bemeneti feldolgozás, a dekódolás, a memória- és hálózati műveletek, valamint az üresjárat váltakozik.
A statikus, csomópontonként rögzített tartalékok mellett az egyik erőforrásnál felszabaduló teljesítmény nem használható fel egy másiknál. Az NVIDIA szerint a DSX MaxLPS figyeli a tényleges fogyasztást, majd a kezelési határok és a meghatározott szabályok megtartásával újraosztja a rendelkezésre álló teljesítményt. A vállalat állítása szerint így ugyanazon jóváhagyott teljesítménykereten belül akár 40 százalékkal több GPU is telepíthető.
Öt elemből áll a vezérlési folyamat
A DSX MaxLPS a lapka-, rendszer-, hőmérsékleti és szoftveres technológiákat hangolja össze az úgynevezett land, power and shell, vagyis LPS-korlátok között. A vezérlési rétegben a Dynamic Power Software kap szerepet.
- Topológia és erőforráscsoportok: az üzemeltető feltérképezi az infrastruktúrát, és közös teljesítménykeretbe rendezi a csomópontokat.
- Telemetria: a rendszer a GPU-k, csomópontok, rackek és csoportok fogyasztását figyeli.
- Szabályzat: az üzemeltető határozza meg a csomópont- és csoportszinteket, az elosztási prioritásokat, a tartalékokat, valamint a karbantartási és vészhelyzeti reakciókat.
- Elosztás és vezérlés: az alacsonyabb fogyasztású erőforrásoktól felszabaduló keretet más GPU-k használhatják fel.
- Ellenőrzés és végrehajtás: a szoftver összeveti a mért fogyasztást a jóváhagyott csoportkerettel, és szükség esetén módosítja a kiosztást.
Ez a folyamat nem növeli a telephely áramellátását, hanem ugyanazon kezelt kereten belül teszi lehetővé több hasznos munka elvégzését.
Az Nscale tesztjének eredményei
Az értékelést az Nscale Keflavíkban található Verne campusán végezték, teljes egészében megújuló energiával működő adatközpontban. Az Nscale telepítette a MaxLPS szoftvert és gyűjtötte a telemetriai adatokat, a munkaterheléseket pedig az NVIDIA futtatta. A teszt NVIDIA Blackwell Ultra GPU-kat, FP4-ben futó Kimi K2.5-öt, NVIDIA Dynamo és NVIDIA TensorRT LLM technológiát, 8K-s bemeneti és 1K-s kimeneti sorozathosszt használt.
A statikus alapkonfiguráció 35 darab, egyenként négy GPU-t tartalmazó csomópontból, összesen 140 GPU-ból állt. Ebben két, egyenként 52 GPU-s nagy áteresztőképességű és egy 36 GPU-s, alacsony késleltetésre hangolt példány futott. A DSX MaxLPS konfiguráció 48 négy GPU-s csomópontot, vagyis 192 GPU-t használt, és egy harmadik, 52 GPU-s nagy áteresztőképességű példánnyal bővült. Mindkét beállítás ugyanahhoz a 264,4 kilowattos jóváhagyott kerethez tartozott.
Az összesített áteresztőképesség 1 084 503 tokenről 1 618 443 tokenre nőtt másodpercenként, ami 49,2 százalékos javulás. A provisionált wattonkénti áteresztőképesség 4,10-ről 6,12 token/másodpercre emelkedett. A nagy áteresztőképességű példányok egyenkénti eredménye 59 153-ról 59 220 tokenre változott másodpercenként, az alacsony késleltetésű példányé pedig 2265 token/másodperc maradt. A P75 és a medián késleltetés az alapérték 5 százalékán belül maradt, a P99-es, vagyis a leglassabb kéréseket is jobban megmutató elsőtoken-idő azonban 17 százalékkal nőtt a 15,7 másodperces alapértékhez képest.
A nagyobb kapacitás mellett a késleltetési szélsőértékeket is mérni kell
Az eredmények az NVIDIA és az Nscale értékelése szerint azt mutatják, hogy a nagyobb kezelt GPU-flotta növelheti az összesített teljesítményt anélkül, hogy érdemben visszafogná a meglévő nagy áteresztőképességű vagy alacsony késleltetésű példányokat. A teszt ugyanakkor a farok-késleltetés vizsgálatának fontosságát is kiemeli, mivel a P99-es elsőtoken-idő romlott.
Az NVIDIA öt lépést javasol a bevezetés előtti ellenőrzéshez: meg kell határozni a kezelt határt, reprezentatív alapmérést kell készíteni, óvatosan kell bevezetni a szabályokat, fokozatosan kell növelni a kapacitást minden szakasz tesztelésével, majd csak akkor kell rögzíteni az éles üzem korlátait, ha minden cél teljesül.
NVIDIA Developer: How NVIDIA DSX MaxLPS Maximizes AI Factory Throughput and Efficiency