Az NVIDIA Groq 3 LPX kiszámíthatóbbá teszi az AI-gyorsítók energiaigényét
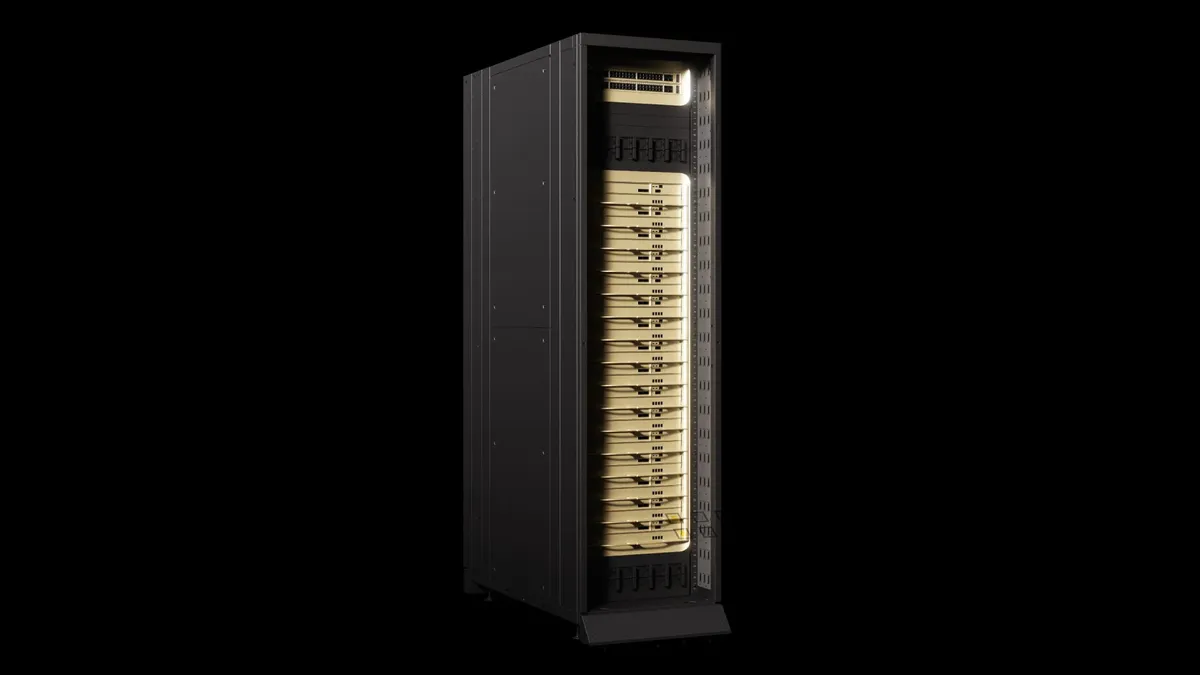
Az NVIDIA szerint a Groq 3 LPX determinisztikus végrehajtási modellje lehetővé teszi, hogy az AI-munkaterhelések energiaigényét ciklusról ciklusra előre jelezzék. A technológia a Vera Rubin NVL72 platformon a nagy interaktivitású, hosszú kontextusú feladatok energiahatékony kiszolgálását célozza.
- A Groq 3 LPX végrehajtása órajelciklusra pontosan ütemezhető.
- A rendszer 256 LPU-chip működését hangolja össze a rackben.
- A PEP és CPS technológiák több mint 60 százalékkal mérsékelhetik a feszültségesést.
- Az NVIDIA szerint ugyanazon munkaterhelésnél alacsony, kétszámjegyű százalékos fogyasztáscsökkenés érhető el.
- A Groq 3 LPX és a Vera Rubin NVL72 akár 35-ször nagyobb áteresztést kínálhat megawattonként a GB200 NVL72-höz képest.
A teljesítmény helyett a wattokra jutó teljesítmény kerül előtérbe
Az NVIDIA Developer szeptember 15-én közzétett bejegyzése szerint az AI-gyárak egyik meghatározó korlátja az energiaellátás. A vállalat ezért a nyers, normalizálatlan átviteli sebesség helyett a wattokra jutó teljesítményt tekinti az AI-platformok értékének fontos mérőszámának.
Az NVIDIA Vera Rubin platformját úgy tervezték, hogy különböző AI-feladatok mellett is energiahatékonyan működjön. A platform központi eleme a Vera Rubin NVL72, amelyet a cég szerint nagy kötegméretű, áteresztésre optimalizált feladatokra és kis kötegméretű, nagy interaktivitást igénylő munkaterhelésekre is szánnak, nyílt és zárt modellek esetében.
A gyártóüzemi szinten működő NVIDIA DSX MaxLPS szoftver a terhelés változásai szerint képes átcsoportosítani az energiát a rackek között. Az NVIDIA állítása szerint így ugyanazon telephelyi teljesítménykereten belül akár 40 százalékkal több GPU telepíthető, miközben a tokenenkénti áteresztés 35 százalékkal nőhet.
A Groq 3 LPX ciklusra pontosan megtervezi a végrehajtást
A nagy interaktivitást igénylő feladatokhoz a Vera Rubin platform NVIDIA Groq 3 LPX alacsony késleltetésű gyorsítót is használ. A determinisztikus végrehajtási modellben a fordító előre meghatározza, hogy egy adott adat mikor és melyik számítási egységhez kerül, valamint azt is, hogy az adott művelet mikor fut le. A beosztás egészen az órajelciklus szintjéig pontos, és a rack mind a 256 LPU-chipjére kiterjed.
Az egyes LPU-gyorsítók néhány, jól meghatározható hardverelemmel végzik a gyakori műveleteket. Az MXM a mátrixszorzásért, a VXM a vektorműveletekért, az SXM pedig a transzponálásért és az átalakításokért felel. A chipek hierarchiamentes, beépített SRAM-bankokat használnak, az LPU-k pedig közvetlenül kapcsolódnak egymáshoz.
Az NVIDIA szerint ezek a megoldások kiszámíthatóvá teszik a számítások, a memóriaműveletek és a chipek közötti kommunikáció időzítését. A fordító előre feloldhat olyan erőforrásütközéseket is, mint amikor két hardverelem ugyanabba a memóriabankba próbál írni.
A kiszámítható áramigény csökkentheti a biztonsági tartalékot
Az AI-chipekben a mátrix- és vektorműveletek rövid idő alatt nagyszámú tranzisztor kapcsolását igénylik. Ez nanomásodperces skálán hirtelen megemelheti az áramigényt. Ilyenkor a chiphez közeli leválasztó kondenzátorok biztosítják a szükséges többletet, ami átmenetileg csökkenti a feszültséget. A feszültségszabályozó később helyreállítja az értéket, mivel az induktivitás miatt nem tud azonnal reagálni.
Az ilyen átmeneti feszültségeséseket voltage droopnak nevezik. Ha a feszültség a chip minimális működési szintje alá esik, hibás eredmény születhet, ezért a rendszereket általában feszültségtartalékkal, úgynevezett voltage guardbanddel működtetik. Ez a tartalék rendszerint többletenergiát igényel. Az NVIDIA példája szerint a 10 százalékkal magasabb folyamatos feszültség 21 százalékkal több energiát jelent, mivel a fogyasztás a feszültség négyzetével arányos.
A Groq 3 LPX előre elkészített végrehajtási ütemezése alapján a rendszer ciklusonként jelezni tudja a várható áramfelvételt. Erre épül a Preemptive Power, röviden PEP, amely előkészíti az energiaellátást a változásokra, valamint a Clock Period Synthesis, röviden CPS, amely az igény emelkedésének és csökkenésének hirtelenségét alakítja.
A Vera Rubin platformon az energiahatékony inferencia a cél
Az NVIDIA szerint a PEP és a CPS együtt több mint 60 százalékkal csökkenti a feszültségesést, és mérsékli a szükséges feszültségtartalékot. A vállalat alacsony, kétszámjegyű százalékos fogyasztáscsökkenést vár ugyanazon munkaterhelés mellett.
A rack szintjén kondenzátorok és töltöttségi állapotot figyelembe vevő Intelligent Power Smoothing szoftver kezeli a betanítási és inferenciafeladatok hirtelen teljesítményigényét. Az NVIDIA szerint ez lehetővé teszi, hogy az AI-gyárakat a tartós, jellemző terhelésre, ne a legrosszabb esetben fellépő csúcsokra méretezzék.
Az NVIDIA állítása alapján a Groq 3 LPX és a Vera Rubin NVL72 párosa a korábbi generációs GB200 NVL72-höz képest akár 35-ször nagyobb megawattonkénti áteresztést érhet el 2 ezermilliárdnál több paraméteres modelleknél, hosszú kontextus és nagy interaktivitás mellett. A bejelentés a felhasználók számára elsősorban azt jelenti, hogy az NVIDIA a gyors válaszidőt és az energiafelhasználást közös platformszintű optimalizálással kezeli.