Az NVIDIA felgyorsítaná a fehérjeszerkezetek AI-alapú előrejelzését
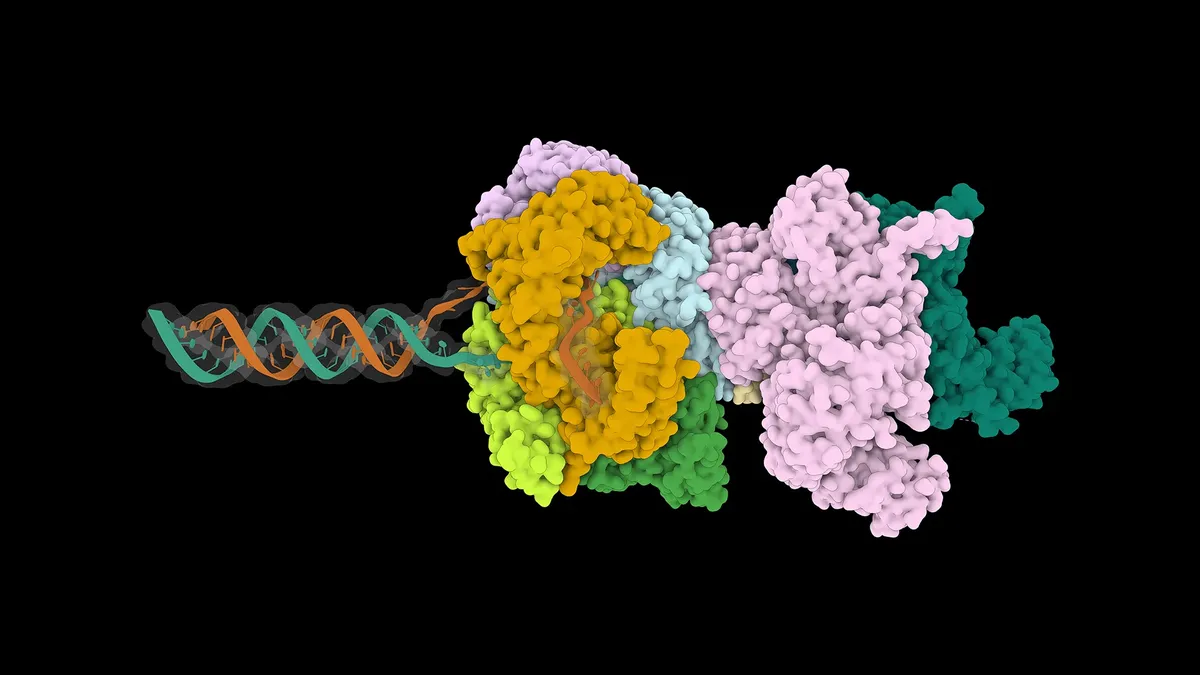
Az NVIDIA olyan eszközöket mutatott be, amelyek a fehérjeszerkezetek és molekuláris komplexek AI-alapú előrejelzésének több lépését is felgyorsítják. A vállalat szerint a megoldások a gyógyszerkutatásban használt virtuális szűrést és a nagy biomolekuláris rendszerek modellezését is könnyebbé tehetik.
- Az MMseqs2-GPU az MSA-keresést NVIDIA GPU-kra helyezi át.
- Az NVIDIA szerint az MSA Search NIM akár 177-szer gyorsabb lehet a CPU-s JackHMMER-nél.
- A cuEquivariance OpenFold3-mérésekben akár 3,1-szeres gyorsulást hozott.
- Az OpenFold3 NIM egyetlen B300 GPU-n körülbelül 6400 tokenig támogat szekvenciákat.
- A Fold-CP és 64 B300 GPU a Boltz-2 modellel 32 ezer tokenes komplexeket céloz.
A teljes munkafolyamatot gyorsítanák
Az NVIDIA július 10-én közzétett fejlesztői bejegyzésében a BioNeMo Agent Toolkit szerepét mutatta be a biomolekuláris szerkezet-előrejelzésben. A rendszerhez olyan eszközök kapcsolódnak, amelyek a több szekvencia igazítását, vagyis az MSA létrehozását, a ko-folding modellek futtatását, a következtetést és a több GPU-ra történő skálázást támogatják.
A vállalat szerint a munkafolyamat bármelyik lassú lépése visszafoghatja a teljes teljesítményt. Ez különösen fontos a virtuális szűrésben, ahol akár több millió vagy milliárd vegyületet vizsgálnak egy vagy néhány fehérjecélponttal szemben. Az NVIDIA úgy látja, hogy a ko-folding modellek által adott szerkezet-előrejelzések javíthatják ezt a folyamatot, futtatásuk költsége azonban korábban korlátozta a széles körű használatot.
Az MSA-keresést GPU-ra helyezték
A ko-folding modellek előtti MSA-generálás hagyományosan CPU-alapú feladat volt, és jelentős részét adhatta a teljes futási időnek. Az NVIDIA által bemutatott MMseqs2-GPU a homológiai keresést NVIDIA GPU-kon végzi. A vállalat közlése szerint a Nature Methods folyóiratban ismertetett eredmények alapján egyetlen L40S GPU-n akár 177-szer gyorsabb igazítást tesz lehetővé a CPU-n futó JackHMMER-hez képest.
Az NVIDIA saját méréseiben az MSA Search NIM H100 és B300 GPU-kon több mint 10 ezer tokenig közel lineárisan skálázódott. A bejegyzés példája szerint nagyjából 10 ezer tokennél a késleltetés 429 másodperc volt H100-on és 463 másodperc B300-on. Az MSA Search NIM közvetlenül, saját infrastruktúrán vagy ügynöki munkafolyamat részeként is használható.
A fejlesztések között Hopper- és Blackwell-architektúrákra szabott optimalizációk is szerepelnek. Az NVIDIA szerint a GPU-s változtatásokat visszaillesztették az MMseqs2 fő kódtárába, így azok a teljes fejlesztői közösség számára elérhetők.
Gyorsabb OpenFold3, hosszabb szekvenciák
Az NVIDIA cuEquivariance nevű CUDA-X könyvtára geometriai tanulási alapműveleteket tartalmaz. A cég szerint a Triangle Attention, a Triangle Multiplication és az Attention Pair Bias műveletek gyorsított változatai a ko-folding modellek meghatározó részeinek késleltetését csökkentik.
A közzétett mérésben az OpenFold3 forward passának ideje 2048 tokennél B300 GPU-n 300,1 másodpercről 97,6 másodpercre csökkent, ami 3,1-szeres gyorsulás. 1536 tokennél 149,0 másodperc helyett 56,2 másodpercet mértek. A cuEquivariance az OpenFold3 mellett az OpenFold2, a RosettaFold3, a Protenix és a Boltz modellben is használható.
Az NVIDIA szerint a megoldás a PyTorchhoz képest a maximális szekvenciahosszt is kiterjeszti. Míg a PyTorch nagyjából 1500 és 2500 token között kifuthat a memóriából, a cuEquivariance használatával körülbelül 5900 tokenig lehet eljutni. Az OpenFold3 NIM további következtetési optimalizációkat alkalmaz, így egyetlen B300 GPU-n akár körülbelül 6400 token hosszúságú szekvenciák feldolgozását támogatja, és a vállalat mérése szerint több mint négyszeres gyorsulást ér el.
Több GPU-val nagyobb komplexumokat céloznak
A nagy, több fehérjéből és több ezer aminosavból álló molekuláris komplexek modellezését a futási idő mellett a memóriaigény is korlátozza. Az NVIDIA szerint a Fold-CP nevű párhuzamosítási technika a készülékenként szükséges memóriát O(N²/P) szerint skálázza, ahol N a tokenek száma, P pedig a GPU-k száma.
A bejegyzésben szereplő példában a Boltz-2 modell 64 B300 GPU használatával 32 ezer tokenes komplexek feldolgozására képes. Az NVIDIA ezt a vállalat által megadott egyetlen GPU-s határhoz képest nagyjából 12-szeres növekedésként írja le. A BioNeMo Agent Toolkit ezeket az eszközöket ügynöki munkafolyamatban kapcsolhatja össze, így az MSA-keresés, a szerkezet-előrejelzés és a több GPU-s futtatás egyetlen folyamat része lehet.
A fejlesztések a forrás szerint olyan alkalmazások előtt nyithatnak utat, amelyek egyetlen GPU korlátai mellett nem voltak megvalósíthatók. Ide tartozik a nagy vegyületkönyvtárak virtuális szűrése, valamint a nagy biomolekuláris összeállítások, köztük a riboszóma ko-folding modellekkel történő vizsgálata.
NVIDIA Developer: Accelerating End-to-End Co-Folding Performance with NVIDIA BioNeMo Agent Toolkit