Az NVIDIA ModelExpress felgyorsítja a nagy AI-modellek betöltését
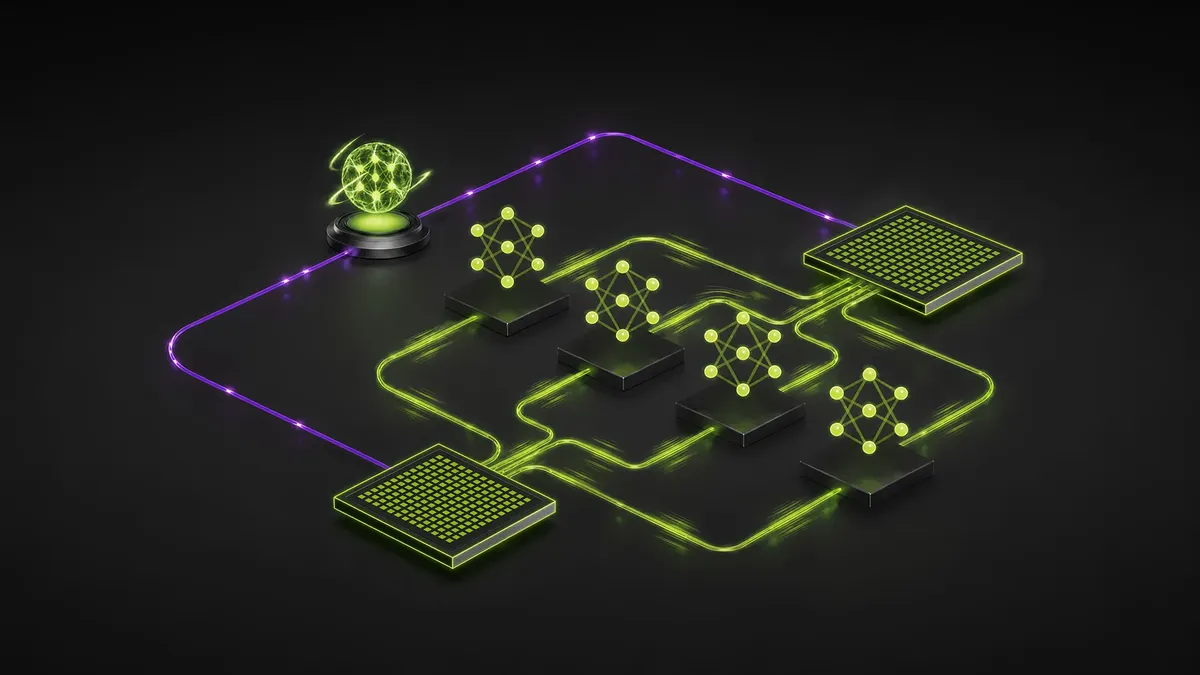
Az NVIDIA ModelExpress a modell súlyainak mozgatását gyorsítaná azzal, hogy mindig a leggyorsabb elérhető forrást választja. A rendszer a már működő példányok GPU-memóriájából közvetlenül továbbíthatja a súlyokat az új példányokba.
- A ModelExpress a leggyorsabb elérhető súlyforrást választja.
- Kompatibilis példányok között közvetlen GPU-GPU átvitelre képes.
- A közös gyorsítótárba történő letöltést egyetlen koordinált műveletre csökkentheti.
- Az NVIDIA mérése szerint a DeepSeek-V4 Pro indulása 8 percről 1 perc 44 másodpercre rövidült.
- A rendszer több hálózati átviteli hátteret támogat a NIXL-en keresztül.
A tároló helyett először a működő példányt keresi
Az NVIDIA Developer július 24-i bejegyzése szerint a nagy nyelvi modellek ellenőrzőpontjai (checkpointjai) akár több száz gigabájtosak vagy egy terabájtosak is lehetnek. A súlyok mozgatása több gyakori munkafolyamatban is időt igényel: ilyen a hideg indítás, az automatikus skálázás, a gördülő frissítés, valamint a megerősítéses tanulással végzett utólagos tanítás.
A ModelExpress, röviden MX, betöltés előtt megvizsgálja, hogy hol található már kompatibilis másolat a modell súlyaiból. Ha egy kiszolgáló példány már a GPU memóriájában tartja a súlyokat, az MX közvetlenül GPU-ról GPU-ra továbbítja azokat P2P RDMA segítségével, az NVIDIA Inference Xfer Library, vagyis a NIXL használatával. Így elkerülhető az objektumtárból, a helyi lemezről és a gazdagép memóriájából történő ismételt betöltés.
Az első példány indításakor a rendszer még távoli vagy helyi tárolóból dolgozik. Ezután az elkészült példány maga válik forrássá a kompatibilis új példányok számára. Az újonnan elindított példány később szintén bekerül a források közé, így a telepítés bővülésével egyre több GPU szolgálhat súlyforrásként.
Tárolóból közvetlenül a GPU memóriájába
Felhőalapú objektumtár használatakor a ModelExpress a Model Streamer segítségével tölti a safetensors formátumú adatokat. A rendszer újrafelhasználható CPU-pufferen keresztül továbbítja a tenzorokat a GPU-ra, miközben az ellenőrzőpont nem kerül helyi lemezre. A több szálon működő tenzortöltő párhuzamosan olvassa a tenzortartományokat a checkpoint különböző darabjaiból, a már beérkezett adatokat pedig továbbítja a következtetési motornak.
Tensorpárhuzamos telepítéseknél a résztvevő rangok megosztják egymás között a távoli olvasásokat, jellemzően NCCL-en keresztül. Így nem minden rangnak kell külön letöltenie a teljes ellenőrzőpontot.
Ha a fürt közös lemezes gyorsítótárat használ, az MX Model Cache Service koordinálja a letöltést. Az NVIDIA példája szerint ha tíz példány egyszerre akarja letölteni a 806 GiB-os DeepSeek-V4 Pro modellt, az nagyjából 8 TiB azonos adat hálózati átvitelét jelentené. A szolgáltatás ehelyett egy letöltőt választ ki, a többi példány pedig követi annak előrehaladását és újrahasznosítja a gyorsítótárban lévő másolatot.
Helyi tároló használatakor a GPUDirect Storage támogatása esetén az MX a NIXL többszálú háttérprogramján keresztül közvetlenül a GPU memóriájába olvassa a fájlokat, megkerülve a gazdagép memóriáját. Ha ez a lehetőség nem érhető el, a rendszer automatikusan más betöltési stratégiára vált.
A bemutatott mérés szerint jelentősen rövidülhet az indulás
Az NVIDIA közlése szerint a ModelExpress a DeepSeek-V4 Pro súlyait és a JIT kernelgyorsítótár elemeit egy működő példányból egy új példányba tíz másodpercnél rövidebb idő alatt továbbította. A teljes indulási idő így 8 percről 1 perc 44 másodpercre csökkent.
A megoldás vezérlési síkja felderíti a kompatibilis társakat, átadja az átvitelhez szükséges metaadatokat, és figyeli a források állapotát, a súlyok bájtjait azonban nem kezeli. Az adatátviteli síkon alapértelmezés szerint a NIXL dolgozik, amely többféle hálózati háttérprogramot támogat, köztük az InfiniBandet, a RoCE-t, az NVLinket és az EFA-t.
Az MX az átvitel előtt a modell és a futtatási beállítások alapján azonosítót számít a forrás kiválasztásához. Csak az azonos azonosítóval rendelkező példányokat tekinti kompatibilisnek. A társak felderítését többek között Redis, Kubernetes CRD-k vagy Kubernetes-szolgáltatás metaadatai segíthetik.
A felhasználók számára kevesebb ismételt betöltést jelenthet
Az NVIDIA leírása alapján a ModelExpress elsősorban azoknál a telepítéseknél lehet hasznos, ahol ugyanazt a modellt több példányban kell elindítani vagy gyakran kell bővíteni a kiszolgálófürtöt. Az első példány tárolóból történő betöltése után a további példányok a már GPU-memóriában lévő, előfeldolgozott súlyokat használhatják.
A megközelítés a fürt külső letöltési költségét is egyetlen koordinált letöltésre csökkentheti közös lemezes gyorsítótár esetén. Az NVIDIA szerint ezzel a fejlesztők a modell súlyainak ismételt mozgatása helyett gyorsabban juthatnak el a tényleges kiszolgálásig. A ModelExpress a vállalat közlése szerint a kernelfordítási gyorsítótárak és a megerősítéses tanulás során frissített súlyok továbbítását is támogatja.
NVIDIA Developer: ModelExpress: Distributing Model Artifacts at the Speed of Light