Az NVIDIA szerint a wattok döntik el az AI-infrastruktúra versenyét
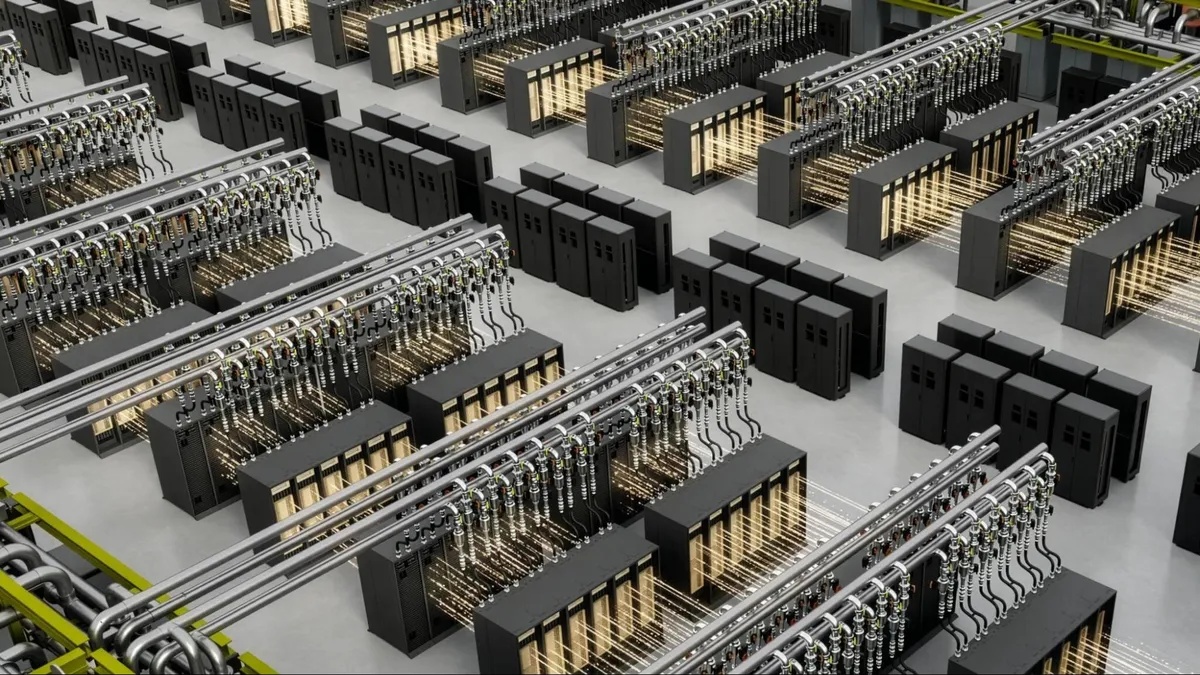
Az AI-infrastruktúrában a teljesítmény wattonként határozza meg, hogy egy adott energiafelhasználás mellett mennyi token állítható elő, és mekkora bevétel érhető el. Az NVIDIA szerint a Blackwell GB300 NVL72 bizonyos modelleknél akár 25-ször jobb teljesítményt nyújt wattonként, mint a Hopper generáció.
- Az NVIDIA szerint a teljesítmény wattonként az AI-infrastruktúra alapvető mércéje.
- A GB300 NVL72 a Hopperhez képest akár 25-ször jobb lehet wattonként DeepSeek V4 Pro mellett.
- A DSX MaxLPS az NVIDIA szerint akár 40 százalékkal több GPU-t tesz lehetővé azonos energiafelhasználási keretben.
- Az Anthropic, az OpenAI és a SpaceXAI Blackwell NVL72 rendszereket használ következtetésre.
A teljesítmény és az energiafelhasználás kapcsolata
Az NVIDIA július 14-i bejegyzése szerint az energia az AI-infrastruktúra megkerülhetetlen korlátja. Az AI-gyárak számára ezért alapvető kérdés, hogy rögzített energiafelhasználási keret mellett hány tokent tudnak előállítani. Ez közvetlenül hat a bevételre és a nyereségességre is.
A vállalat úgy véli, hogy a teljesítmény wattonként olyan mérőszám, amelyet valós eredményekkel kell elérni. Az ügynökalapú AI terjedése növeli a tokenek iránti keresletet, így a mai infrastruktúra-döntések befolyásolják, mely szervezetek tudnak tovább növekedni az energia által korlátozott környezetben.
A nagyobb GPU-tartomány előnyei
Az NVIDIA szerint a vezető AI-modellek csaknem mindegyike szakértőkeverékes, vagyis mixture-of-experts, MoE-architektúrát használ. Ezek hatékony kiszolgálásánál fontos a GPU-tartomány mérete, vagyis az ultranagy sebességű, skálázási kapcsolat által összekötött GPU-k száma.
A Hopper generáció nyolc GPU-s tartományt állított fel mérceként, a vállalat szerint azonban a jelenlegi csúcskategóriás modellek ezt már meghaladták. A 72 GPU-s tartomány használata teljes rendszerre kiterjedő közös tervezést és nagyüzemi üzemeltetési tapasztalatot igényel. Az NVIDIA állítása szerint a Blackwell NVL72 platform ezt az alapot már biztosítja, a Vera Rubin platform pedig erre építve növeli tovább a rack-szintű energiahatékonyságot.
A SemiAnalysis InferenceX adatai alapján a GB300 NVL72 a Hopperhez képest akár 25-ször jobb teljesítményt wattonként ér el a DeepSeek V4 Pro esetében. GLM5.1-nél ez az érték akár 20-szoros, a hosszú, ügynökalapú feladatokra tervezett Kimi K2.6-nál pedig akár 10-szeres.
A szoftver és a rack kialakítása is számít
Az NVIDIA a javulást a rack teljes rendszerére kiterjedő közös tervezésnek tulajdonítja, amely a szilíciumtól a szoftverig minden réteget érint. Az NVLink Switch például kifejezetten a nagy GPU-tartományokhoz készült. A Vera Rubin platformmal ennek hatodik generációja érkezik, olyan funkciókkal, mint a SHARP, amely a hálózati kapcsolóban végez számításokat, így tehermentesíti a GPU-kat.
Az NVIDIA következtetési szoftvercsomagja, köztük a Dynamo és a TensorRT LLM, valamint az SGLang és a vLLM olyan megoldásokat támogat, mint az NVFP4 kvantálás, a szétválasztott kiszolgálás, a nagyméretű szakértőpárhuzamosság, a KV-tudatos útválasztás és a KV-gyorsítótár tehermentesítése. A vállalat szerint a DeepSeek V4 esetében a teljesítmény wattonként egyetlen hónap alatt akár ötszörösére javult.
Az NVIDIA szerint a hűtés és a rackszintű veszteségek miatt a hálózatból felvett áramnak csak körülbelül 60 százaléka alakul hasznos AI-munkává. A DSX MaxLPS valós időben osztja át az energiát a GPU-k és a rackek között, támogatja a melegvizes folyadékhűtést, és akár 40 százalékkal több GPU üzemeltetését teheti lehetővé azonos energiafelhasználási keretben.
A termelési környezetben dől el a hatékonyság
Az NVIDIA szerint a rack-szintű megbízhatóságot nagyüzemi környezetben nehéz elérni, mert az ilyen rendszerek olyan hibalehetőségeket is tartalmaznak, amelyek az egyetlen csomópontos telepítéseknél nem jelennek meg. A vállalat közlése szerint az Anthropic, az OpenAI és a SpaceXAI Blackwell NVL72 rendszereket használ következtetésre.
A CoreWeave a Kimi K2.6-ot GB300 NVL72 rendszeren telepítette, NVFP4 kvantálással és EAGLE3 spekulatív dekódolással. A Perplexity Qwen3 235B-t és az utólag betanított Qwen3.5-397B-A17B modellt futtatja GB200 NVL72 rendszeren, AI-ügynökplatformján naponta több millió lekérdezést kiszolgálva. A Fireworks AI GLM 5.2-t telepít Blackwell-platformon, többek között a Cursor és a Factory AI ügyfelei számára.
Az NVIDIA szerint a több modellgeneráción és éles telepítésen felhalmozott tapasztalat ad előnyt a Vera Rubin platformnak. A felhasználók számára ez azt jelentheti, hogy az energiahatékonyságot nem egyetlen tesztérték, hanem a késleltetés, az áteresztőképesség, a költség és a folyamatos üzemi megbízhatóság együttese alapján kell vizsgálni.