Az NVIDIA szerint percekre rövidülhet a nagy léptékű UMAP több GPU-val
Az NVIDIA Developer 2026. augusztus 18-án ismertette, hogy a cuML és a cuVS 25.06 több GPU-s támogatást kapott az UMAP egyik legköltségesebb lépéséhez. A cég szerint egy 106 millió vektorból álló MIRACL adathalmazon nyolc NVIDIA H100 GPU-val 8 perc alatt futott le a feladat.
- A cuML és a cuVS 25.06 több GPU-ra osztja az UMAP all-neighbors kNN-gráfépítését.
- A módszer kiegyensúlyozott klasztereket és átfedő vektorhozzárendelést használ.
- A knn_n_clusters és a knn_overlap_factor szabályozza a memória, idő és minőség közti kompromisszumot.
- Az NVIDIA szerint 106 millió MIRACL vektoron, nyolc NVIDIA H100 GPU-val 8 perces futást értek el.
- A beágyazás minőségét trustworthiness pontszámokkal összevethetőnek találták a GPU-konfigurációk között.
A korábbi korlátot a kNN-gráfépítésnél oldják fel
Az UMAP, teljes nevén Uniform Manifold Approximation and Projection, dimenziócsökkentési eljárás, amelyet az NVIDIA bejegyzése szerint vizualizációra és jellemzőkinyerésre használnak. A példák között szerepel a feltáró adatelemzés, a témamodellezés és az egysejtes elemzés. Ezekben a munkafolyamatokban gyakori az ismételt futtatás, mert a felhasználók elemzés közben paramétereket hangolnak vagy újra és újra ellenőrzik az adatokat.
A módszer egyik kritikus része az all-neighbors kNN-gráf elkészítése. Ez azt jelenti, hogy a rendszer minden vektorhoz megkeresi a k legközelebbi szomszédot az adathalmazban. Az NVIDIA szerint ez a lépés különösen költségessé válik, amikor az adatok tízmilliós vagy százmilliós vektorszámra nőnek.
A cég korábbi GPU-s UMAP-megoldása már alkalmazott out-of-core megközelítést, vagyis olyan eljárást, amelynél nem kell a teljes adathalmaznak egyszerre a GPU memóriájában lennie. A mostani bejegyzés szerint azonban a tanítási szakasz eddig egyetlen GPU-ra korlátozódott, és csak a transform() lépés tudott több GPU-t használni. A cuML és a cuVS 25.06 ezt a korlátozást oldja fel azzal, hogy a kNN-gráfépítés drága részét több GPU között osztja szét.
Klaszterekre bontás, átfedéssel
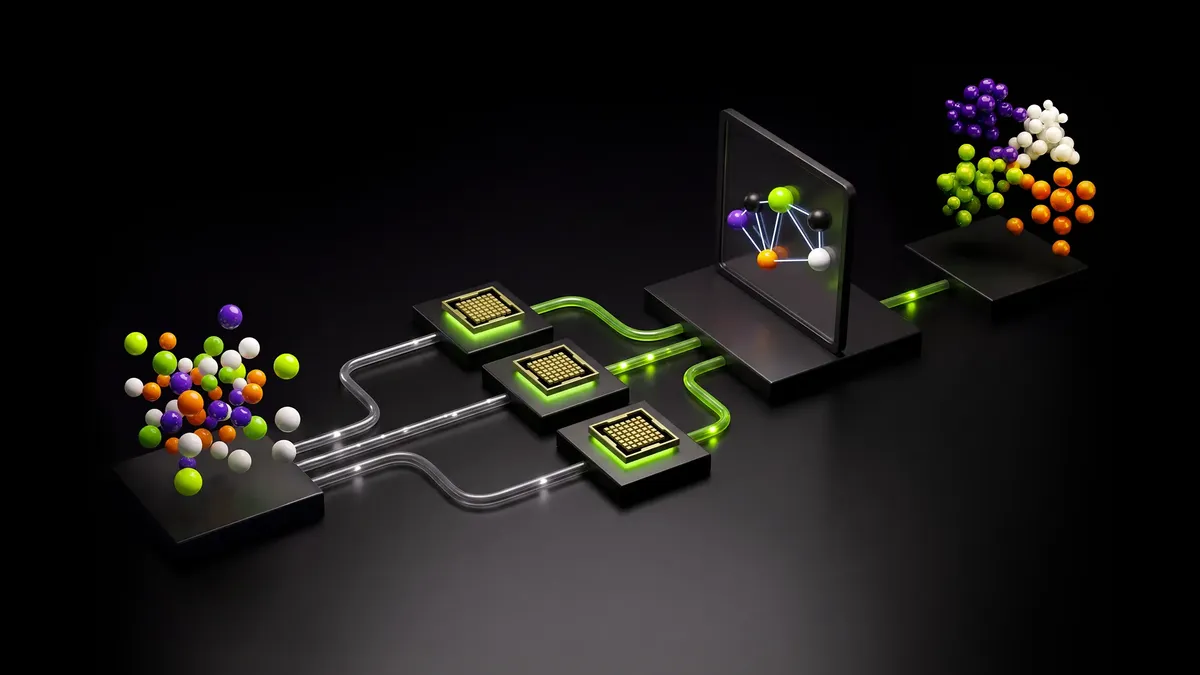
A több GPU-s skálázás alapja, hogy az adatokat kiegyensúlyozott klaszterekre osztják. A vektorok egy része átfedéssel több közeli klaszterhez is hozzárendelhető, hogy a klaszterhatárokon átnyúló szomszédsági kapcsolatok ne vesszenek el. Ezután minden klaszteren helyi kNN-gráf készül, majd ezekből áll össze a globális all-neighbors gráf.
Az NVIDIA leírása szerint a megközelítés azért illeszkedik természetesen több GPU-hoz, mert az egyes klaszterek önálló munkadarabként kezelhetők. A GPU-k a CPU memóriájából gyűjtik be a hozzájuk rendelt klaszterek adatait, kiszámítják a helyi all-neighbors kNN-gráfokat, majd ezeket egy globális kNN-gráffal egyesítik.
A bejegyzés hangsúlyozza, hogy a helyi kNN-gráfok önálló kiszámítása elkerüli a költséges all-to-all kommunikációt, amely az elosztott all-neighbors kNN feladatoknál jellemzően korlátozná a skálázódást. Az NVIDIA szerint ez nagy adathalmazokon jelentős végponttól végpontig tartó gyorsulást hozhat.
Két paraméter szabályozza az idő, memória és minőség arányát
A cuML több GPU-s UMAP ugyanazokat a fő lépéseket követi, mint az egy GPU-s megvalósítás, de a forrás két fontos hiperparamétert emel ki. A knn_n_clusters azt adja meg, hány klaszterre bontják az adatot. A knn_overlap_factor azt határozza meg, hogy egy adatpont összesen hány legközelebbi klaszterhez legyen hozzárendelve.
A knn_n_clusters növelése csökkenti az egy klaszterre jutó pontok számát, így kevesebb adatnak kell elférnie az egyes GPU-k memóriájában. A knn_overlap_factor növelése több átfedést ad a klaszterek között, ami az NVIDIA szerint több valódi legközelebbi szomszéd megőrzését segíti a klaszterhatároknál. Ennek ára a hosszabb számítási idő és a nagyobb memóriahasználat, mert klaszterenként több vektort kell feldolgozni.
A bejegyzés gyakorlati kiindulópontként a knn_overlap_factor=2 értéket javasolja minőségi beágyazáshoz. Mérsékelt léptéknél a 2, 3, 4 növelési sorozatot említi, nagyobb adathalmazoknál, ahol a knn_n_clusters nagyobb mint 100, a 2, 4, 6 lépések is hasznosak lehetnek. A cég szerint az overlap_factor emelését óvatosan kell kezelni, mert bár javíthatja a kNN recall értékét, jelentősen növeli a klaszterenkénti számítási időt.
A memóriahasználat kordában tartására az NVIDIA azt írja, hogy a knn_overlap_factor növelésével együtt érdemes növelni a knn_n_clusters értékét is. Példaként a forrás azt említi, hogy az overlap factor megduplázása várhatóan megduplázza a klaszterenkénti pontszámot, ezért a klaszterek számának megduplázása fenntarthatja a klaszterenkénti pontmennyiséget.
106 millió vektor, 870 GB feletti adatmennyiség
Az NVIDIA összefoglalója szerint a cuML több GPU-s UMAP nyolc NVIDIA H100 GPU-n, egy 106 millió vektorból álló MIRACL adathalmazon akár 74-szeres végponttól végpontig tartó gyorsulást ért el a becsült CPU-s futásidőhöz képest, és 8 perc alatt fejezte be a futást. A cím alatti leírás szerint a cuML és a cuVS több mint 870 GB vektoron futtatta az UMAP-ot 8 perc alatt.
A forrás azt is állítja, hogy a beágyazások minősége összevethető maradt a különböző GPU-konfigurációk között. Ezt trustworthiness pontszámokkal mérték, amelyek az NVIDIA szerint azt mutatják, hogy az elosztott megközelítés nagy léptékben is megőrzi a szomszédsági szerkezetet.
A cuVS all-neighbors API közvetlenül is elérhető azoknak az alkalmazásoknak, amelyek önálló all-neighbors gráfépítést igényelnek. A cuML UMAP belsőleg ugyanezeket a paramétereket továbbítja a cuVS API-nak a gráfépítés során.
Mit jelent ez a nagy adathalmazokkal dolgozóknak
Az NVIDIA bejegyzése alapján a fejlesztés azoknak a munkafolyamatoknak lehet fontos, ahol az UMAP-ot nagy adatmennyiségen, ismétlődő és feltáró jelleggel futtatják. A cég szerint a módszer több száz gigabájtos terheléseken percek alatt teheti futtathatóvá az UMAP-ot, szemben az órákig vagy akár napokig tartó futásokkal.
A felhasználók számára a fő változás az, hogy a tanítási szakaszban is kihasználhatóvá válik több GPU, miközben a minőség, az idő és a memóriahasználat a knn_n_clusters és a knn_overlap_factor paraméterekkel szabályozható. A bejegyzés a RAPIDS telepítési útmutatót ajánlja a több GPU-s UMAP környezet beállításához, a cuVS API Guide-ot pedig az all-neighbors gráfépítési API részleteihez.
NVIDIA Developer: Run Massive-Scale UMAP in Minutes Using Multiple GPUs—Without Losing Accuracy