A Quail több mint egymilliárd tokent dolgoz fel percenként H100-on
A Modal bemutatta a Quail nevű következtetési motort, amelyet kifejezetten AI-SQL munkafolyamatokra terveztek. A vállalat szerint egy H100 GPU-n több mint egymilliárd tokent dolgoz fel percenként, ami ugyanazon a hardveren több mint tízszerese a vLLM-alapú mérésüknek.
- A Quail kifejezetten AI-SQL munkafolyamatokra készült következtetési motor.
- A Modal szerint egy H100 GPU-n több mint egymilliárd tokent dolgoz fel percenként.
- A vállalat mérése alapján a Quail több mint tízszer gyorsabb a vLLM-alapnál egy kiválasztott lekérdezésen.
- Az AI-SQL-mérőszámon a Quail geometriai átlagban 1,84-szer gyorsabb volt a vLLM-nél.
- A megoldás kipróbálható a Modalon, a kód és a dokumentáció is elérhető.
Az AI-SQL más feladat, mint az NL2SQL
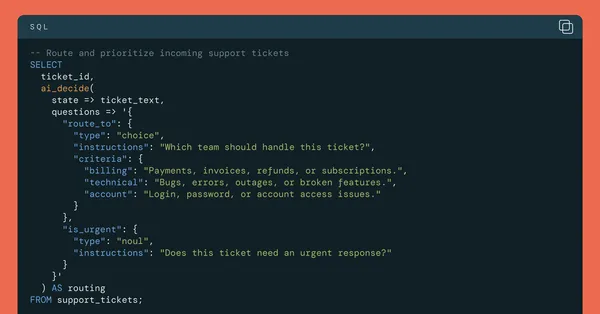
Az AI-SQL nem természetes nyelvű kérdésekből állít elő SQL-lekérdezéseket. A Modal leírása szerint egy SQL-kiterjesztésről van szó, amely adatbázis-bejegyzésekből épít fel promptokat, majd az MI válaszaiból táblázatos eredményeket állít elő.
Egy lekérdezés például ügyfélprofilokat és termékleírásokat vethet össze, hogy azonosítsa azokat a párosításokat, ahol az adott ügyfél valószínűleg érdeklődik a termék iránt. Az AI-SQL-t elsősorban üzleti intelligenciát támogató platformokon használják, hogy az adattudósok és más felhasználók félig strukturált adatokkal, dokumentumokkal és szabad szöveges mezőkkel kapcsolatban is feltehessenek kevésbé merev kérdéseket.
A Modal szerint a nagy analitikai adatbázis-platformoknak már saját megoldásaik vannak erre a célra, például a Snowflake Cortex AI-SQL, a Databricks AI Functions és a BigQuery AI functions.
Miért jelent kihívást a hagyományos következtetés?
Az AI-SQL-lekérdezések nagy számú, gyakran rövid kérést generálhatnak. Egy összetett lekérdezés akár több millió, egyenként több ezer tokenből álló sorozat feldolgozását is igényelheti. Ezekhez a feladatokhoz a Modal szerint sok esetben nincs szükség a legfejlettebb modellek képességeire, ezért kisebb, nyílt súlyú modellek is megfelelőek lehetnek.
A chatbotok és ügynöki rendszerek következtetési motorjai jellemzően tetszőleges, a felhasználó által vezérelt kérésekre készülnek. Az AI-SQL esetében viszont maga az SQL-lekérdezés határozza meg a létrejövő kérések szerkezetét. Ez lehetővé teszi, hogy a lekérdezéstervező és a következtetési motor együtt szervezze a feldolgozást.
A Modal kiemeli, hogy az AI-SQL különösen jól illeszkedik a transzformerekhez, mivel a strukturált kérések miatt hatékonyabban használható a kulcsérték-gyorsítótár, vagyis a KV cache. A GPU-k szempontjából az is fontos, hogy ezeknél a munkafolyamatoknál nincs szükség dekódolásra.
A Quail eredményei és működési elve
A Quail a „QUery-Aware Inference Layer” rövidítése. A Modal és a Carnegie Mellon University Full Stack Data Lab kutatóinak együttműködésében készült, és a vállalat szerint a lekérdezéstervezést, valamint a következtetési motort közösen optimalizálja.
Egy olyan, több összekapcsolást tartalmazó lekérdezésnél, ahol különösen fontos a tervezés, a Quail egy H100 GPU-n több mint egymilliárd tokent dolgozott fel percenként. Ez a Modal azonos hardveren végzett vLLM-alapú mérésénél több mint tízszer gyorsabb eredmény. A vállalat saját infrastruktúráján ez kevesebb mint 6 cent költséget jelent egymilliárd tokenenként.
A Modal új, AI-SQL-lekérdezésekre készült mérőszámán a Quail feladatonkénti geometriai átlagban 1,84-szer gyorsabb volt a vLLM-nél. A mérés két olyan lekérdezést is tartalmazott, amelyeket a fejlesztők az AI-SQL-következtetés jövőbeli fejlesztési területeinek bemutatására készítettek.
A megközelítés egyik kulcsa, hogy a strukturált lekérdezés ismeretében a kérések olyan sorrendben dolgozhatók fel, amely javítja a KV cache használatát és ürítését. A Modal szerint ezzel együtt a sok kis kérésből adódó gazdagép-oldali többletterhelés és az alacsony GPU-kihasználtság is mérsékelhető.
A Quail kipróbálható a Modalon
A Modal 2026. szeptember 24-én közzétett bejegyzése szerint a Quail már kipróbálható a Modalon. A bemutatott példa egy H100 GPU-t használ, a quail-engine==0.1.0 csomagra épül, és a qwen3-4b-fp8 modellt állítja be.
A példakód egy olyan lekérdezést futtat, amely az IMDb adathalmaz értékelései közül választja ki azokat, amelyek a történet befejezéséről szólnak. A Modal a Quail kódját és dokumentációját is elérhetővé tette, továbbá kapcsolatfelvételt kér azoktól, akik nagy léptékben futtatnak AI-SQL-lekérdezéseket, és javítani szeretnék a teljesítményt vagy csökkenteni a költségeket.
A vállalat szerint a projekt az inferenciamérnöki és adatbázis-kutatási terület közös metszetét célozza. A Quail fejlesztői azt szeretnék, hogy a megoldás a jövőben még jobban támogassa a szakértők közötti párhuzamos feldolgozást, miközben a projektet nyílt forrású teljesítményoptimalizálási munka kiindulópontjának tekintik.