Szerver nélküli finomhangolást kínál nyílt súlyú modellekhez a Snowflake
A Snowflake nyilvános előzetesként bemutatta a Cortex Traininget, egy szerver nélküli szolgáltatást nyílt súlyú nagy nyelvi modellek testreszabására és üzembe helyezésére. A vállalat szerint a platform akár 61 százalékkal olcsóbb lehet a versenytársak szerver nélküli megoldásainál.
- Nyilvános előzetesként elindult a Snowflake Cortex Training.
- A szolgáltatás nyílt súlyú modellek szerver nélküli finomhangolását támogatja.
- Elérhető az SFT, az RL, a LoRA és a teljes paraméteres tanítás.
- A Snowflake szerint a költség akár 61 százalékkal alacsonyabb lehet a konkurens megoldásokénál.
- A platform a modell-életciklust az adat-előkészítéstől a telepítésig kezeli.
A Snowflake a GPU-k kezelését venné le a fejlesztők válláról
A Snowflake november 3-án jelentette be a Cortex Training nyilvános előzetesét. A szolgáltatás célja, hogy a vállalati AI-csapatok saját adataikkal szabják testre és telepítsék a nyílt súlyú nagy nyelvi modelleket anélkül, hogy GPU-infrastruktúra kiépítésével, ütemezésével, ellenőrzőpontjaival vagy elosztott futtatásával kellene foglalkozniuk.
A vállalat szerint a termelési AI-alkalmazások nagy mennyiségű, üzleti szempontból értékes adatot termelnek. Ilyenek lehetnek az ügyféligények, a használati minták és az eredmények. A Cortex Training ezeket az adatokat kapcsolja össze a modell testreszabásának folyamatával, miközben a Snowflake kezeli a GPU-kat, a modellállapotot és az elosztott végrehajtást.
A Snowflake közlése szerint a szolgáltatás egy testre szabható, optimalizált, nyílt forráskódú háttérrendszerre épül. A vállalat összehasonlító mérései alapján a Cortex Training akár 61 százalékkal alacsonyabb költséget kínálhat más szerver nélküli szolgáltatásokhoz képest.
SFT, RL és saját tanítási ciklusok
A Cortex Training támogatja a felügyelt finomhangolást, vagyis az SFT-t, valamint a megerősítéses tanulást, az RL-t. Mindkét módszer használható teljes paraméteres tanítással vagy LoRA-val. A fejlesztők olyan nyílt súlyú modellcsaládokkal dolgozhatnak, mint a Qwen, a GLM, a Nemotron, a Gemma és a DeepSeek.
Az SFT során jó minőségű példákból tanul a modell. Egy ügyfélszolgálati ügynök esetében így megtanítható például a hibák felismerésére, az ügyfelekkel való kommunikációra, az eszkalációs szabályok alkalmazására, valamint az eszközök és munkafolyamatok megfelelő használatára.
Az RL ezzel szemben mérhető eredményekből származó visszajelzések alapján alakítja a viselkedést. A Snowflake példái között szerepel annak megtanulása, hogy egy ügyfélszolgálati ügynök mikor használjon jegykezelő rendszert, mikor hívjon számlázási API-t, és mikor továbbítsa az ügyet embernek. A cél a minőség, a sebesség és a költség egyensúlyának javítása.
A szolgáltatás integrálható többek között a Hugging Face TRL, a PrimeRL, a veRL és a SkyRL keretrendszerekkel. Az alacsonyabb szintű API-k egyedi veszteségfüggvények, modellarchitektúrák és tanítási ciklusok létrehozását is lehetővé teszik.
Adat-előkészítéstől az OpenAI-kompatibilis végpontokig
A Snowflake a Cortex Traininget a teljes modell-életciklus kezelésére szánja. A csapatok először saját munkaterhelésükön hasonlíthatják össze a modelleket minőség, késleltetés és költség alapján, majd kiválaszthatják a testreszabásra alkalmas alapmodellt.
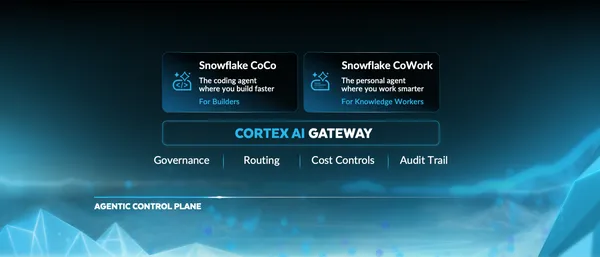
A Snowflake adatplatformján a vállalatok strukturált és strukturálatlan adatokat tisztíthatnak, szűrhetnek, gazdagíthatnak és címkézhetnek. A Cortex AI Functions, az SQL és a Snowpark segítségével ezekből tanításra kész adathalmazokat állíthatnak elő. A Cortex AI Gateway pedig az ügynökök nyomait, naplóit és modellinterakcióit gyűjtheti össze.
Ezek az adatok az alkalmazások eredményeivel és az emberi visszajelzésekkel együtt újabb tanítási adathalmazok alapját adhatják. A Snowflake ezt folyamatos fejlesztési ciklusként írja le: a termelési használatból származó jelek alapján a modellek egyre jobban az adott vállalat feladataihoz igazíthatók.
A testreszabott modellek ellenőrzőpontjai összehasonlíthatók, majd OpenAI-kompatibilis következtetési végpontokon telepíthetők. A Snowflake szerint a szerepköralapú hozzáférés-szabályozás a tanítási adatokat, a modell tanítását, a telepítést és a következtetést is lefedi, miközben az adatok, a modell súlyai és az optimalizáló állapota a Snowflake kezelt környezetében marad.
Mit jelent ez a vállalati felhasználóknak?
A Cortex Training azoknak a vállalati AI-csapatoknak kínál alternatívát, amelyek saját adatokkal szeretnék javítani a nyílt súlyú modellek teljesítményét, de nem akarnak önálló GPU-fürtöt üzemeltetni. A Snowflake szerint a fejlesztők így a modelllogikára és a kísérletekre összpontosíthatnak, miközben a platform kezeli az infrastruktúra-intenzív műveleteket, például az előre- és visszaterjesztést, az optimalizálási lépéseket, a súlyok szinkronizálását és a generálást.
A ResolveAI a Snowflake beszámolója szerint több száz, esetenként több mint ezer GPU-t igénylő, hosszú feladatok tanítására használja a szerver nélküli API-kat. Az OpenHands kutatói pedig arról számoltak be, hogy a Cortex Traininggel a kísérletekre és a tanításra koncentrálhattak anélkül, hogy fel kellett volna adniuk a korábban használt keretrendszereiket.
Snowflake: Cortex Training: Serverless Fine-Tuning for Open-Weight LLMs