A Speechmatics Melia 1 modellje javította a többnyelvű átírást
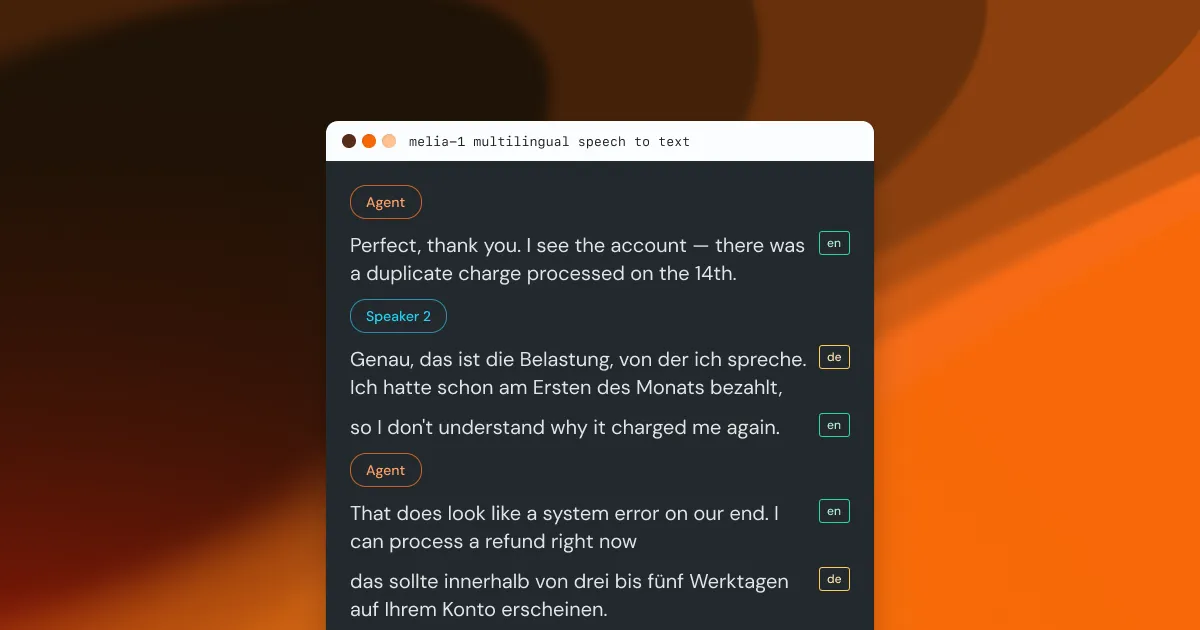
A Speechmatics szerint Melia 1 beszédfelismerő modellje vezeti a tesztelt rendszerek mezőnyét az arab, mandarin és tamil nyelv közötti váltások felismerésében. Arab és angol beszéd esetén a modell vegyes hibaaránya kevesebb mint fele volt a következő legjobb eredménynek.
- A Melia 1 arab és angol beszédnél 15,1 százalékos vegyes hibaarányt ért el.
- Tamil és angol esetében a modell 28,4 százalékos vegyes hibaarányt produkált.
- A váltási pontok F1-értéke mandarin és tamil nyelvnél 0,928 volt.
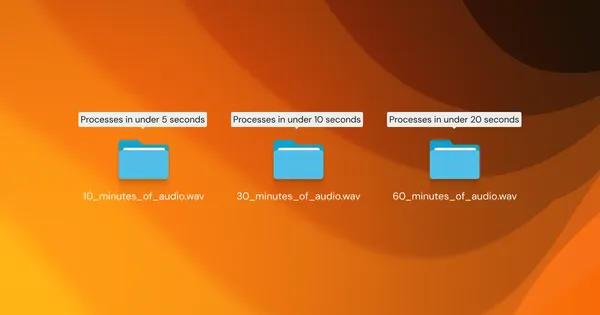
- Egy 60 perces felvétel átírása a Speechmatics szerint 20 másodpercnél kevesebb.
- A vállalat következőként az angol és spanyol, valamint dél-ázsiai nyelvi váltásokra összpontosít.
A rövid nyelvváltásokat is követi
A kódváltás, vagyis amikor egy beszélő egy mondaton belül másik nyelvre tér át, gyakori a többnyelvű munkakörnyezetekben. A Speechmatics szerint a beszédfelismerő rendszerek ilyenkor többféleképpen hibázhatnak: előfordulhat, hogy végig ugyanazon a nyelven írják le a beszédet, akkor is, ha a beszélő váltott, olyan helyen váltanak nyelvet, ahol ez nem történt meg, vagy csak késve követik a változást.
A vállalat júniusban indította el a Melia 1 többnyelvű beszédfelismerő modellt, azóta pedig a kódváltás pontosságának javításán dolgozott. A szeptember 1-jén közzétett értékelésben a modellt a Soniox v5, az Amazon standard és az AssemblyAI Universal 3.5 Pro rendszereivel hasonlították össze. A Speechmatics belső tesztjét nyelvi útmutatók nélkül végezték.
Arab és angol nyelvnél különösen nagy az eltérés
A vegyes hibaarány azt mutatja meg, hogy a modell a szavak, illetve a mandarin esetében a karakterek mekkora részét írta le hibásan. Az arab és angol nyelvpárnál a Melia 1 eredménye 15,1 százalék lett. A következő legjobb modell, a Soniox v5 33,2 százalékot ért el. A Speechmatics közlése szerint ez a Melia 1 esetében kevesebb mint fele a következő eredménynek.
Tamil és angol esetében a Melia 1 vegyes hibaaránya 28,4 százalék volt, szemben a Soniox v5 58,9, illetve az Amazon standard 48,8 százalékával. Mandarin és angol párosításnál a Melia 1 14,1 százalékos eredményt ért el, a Soniox v5 14,5, az AssemblyAI Universal 3.5 Pro 15,4, az Amazon standard pedig 32,9 százalékot produkált. A Malay és angol párosításban a Soniox v5 jobb eredményt ért el, 10,2 százalékkal, míg a Melia 1 12,3 százalékot kapott. Az AssemblyAI ezt a párost nem támogatta.
A váltási pontok felismerésében is első lett
A Speechmatics egy másik mutatót, a váltási pontok F1-értékét is használta. Ez azt méri, hogy a modell felismeri-e, mikor váltott nyelvet a beszélő, és nem jelöl-e tévesen olyan váltást, amely nem történt meg. A mutató 0 és 1 közötti skálán mozog, a magasabb érték a jobb eredmény.
A Melia 1 összesített értéke 0,714 lett a mandarinhoz, a tamilhoz és az arabhoz kapcsolódó angol nyelvváltásoknál. A Soniox v5 0,611, az AssemblyAI Universal 3.5 Pro 0,552, az Amazon standard pedig 0,489 értéket ért el. A mandarin és tamil nyelvpároknál a Melia 1 értéke 0,928-ra emelkedett. A Malay és angol párosításnál ez a mérés nem alkalmazható, mert mindkét nyelv latin ábécét használ.
Gyorsabb átírás és jobb alfanumerikus kezelés
A Speechmatics szerint a Melia 1 az alfanumerikus karaktersorozatok kezelésében is javult minden támogatott nyelven. Ide tartoznak például a referenciaszámok, irányítószámok, termékkódok és kártyaszámok. A vállalat ilyen esetekben különösen fontosnak tartja a pontos átírást, például ügyfélszolgálati hívások vagy klinikai jegyzetek esetén.
A modell feldolgozási ideje is rövidült. A közlemény szerint egy 60 perces felvétel átírása 20 másodpercnél kevesebb, egy 30 perces fájlé 10 másodpercnél kevesebb, egy 10 perces felvételé pedig 5 másodpercnél kevesebb időt vesz igénybe. A Speechmatics következőként Latin-Amerika és az Egyesült Államok spanyol nyelvű piacának angol és spanyol kódváltásait, valamint Dél-Ázsia indiai nyelveit célozza. A vállalat közlése szerint közben a Melia 1 által támogatott nyelvek általános pontosságát is tovább javítja.
Speechmatics: Melia 1 leads speech-to-text code-switching in Arabic, Mandarin and Tamil