Több GPU-n futó TensorRT inferenciát kapott az NVIDIA Dynamo-Triton
Az NVIDIA Dynamo-Triton 26.07-ben elérhetővé vált a TensorRT backend többeszközös inferenciája, amely egyetlen modellvégponton keresztül tud több GPU-t használni. Az NVIDIA példája szerint a Cosmos 3 Nano videógenerálás késleltetése nyolc GPU-n 156,595 másodpercről 34,183 másodpercre csökkent.
- A Dynamo-Triton 26.07 engedélyezi a TensorRT backend többeszközös inferenciáját.
- Egy KIND_MODEL példány több GPU-t kezelhet, a kliens pedig egy gRPC modellvégpontot hív.
- A Cosmos 3 Nano példában 44 160 videó tokent osztottak szét legfeljebb nyolc GPU-ra.
- Az end-to-end késleltetés 156,595 másodpercről 34,183 másodpercre csökkent nyolc GPU-val.
- A CP2, CP4 és CP8 kimenetek megfeleltek a beállított MAE és PSNR küszöböknek.
Egy modellvégpont több GPU mögött
Az NVIDIA 2026. szeptember 21-én ismertette, hogyan kapcsolódik össze a TensorRT többeszközös inferenciája a Dynamo-Triton 26.07 kiadásával. A vállalat leírása szerint a TensorRT multi-device inference lehetővé teszi, hogy egyetlen TensorRT hálózat több GPU-n fusson, NCCL-alapú elosztott kollektív műveletekkel, miközben megmaradnak a TensorRT inferenciaoptimalizálásai. A képesség teljes támogatása a TensorRT 11.0-tól érhető el.
A Dynamo-Triton, korábbi nevén NVIDIA Triton Inference Server, a 26.07-es kiadásban engedélyezi ezt a többeszközös TensorRT backend működést. Egy Triton KIND_MODEL példány több GPU-t birtokolhat, rangonként TensorRT végrehajtási környezeteket, CUDA streameket és NCCL kommunikátorokat hozhat létre, majd a rangokat együtt indíthatja el minden kérésnél.
A kliensoldali alkalmazásnak így nem kell saját maga koordinálnia a GPU-rangokat. A forrás szerint az alkalmazás egy névvel ellátott modellt hív meg egy gRPC végponton keresztül, miközben a több GPU kezelését a kiszolgálóoldali réteg végzi.
Cosmos 3 Nano videógenerálással demonstrálták
Az NVIDIA a működést a Cosmos 3 Nano videógenerálási feladaton mutatta be. A példában a Diffusers továbbra is a promptokat, a latenseket, a classifier-free guidance, röviden CFG folyamatot, az ütemezést, a VAE dekódolást és a képkockák utófeldolgozását vezérli. A Dynamo-Triton a 36 rétegű denoising transformer kiszolgálását végzi, a TensorRT többeszközös inferenciája pedig Ulysses context parallelism segítségével osztja szét a 44 160 videó tokent legfeljebb nyolc NVIDIA GPU között.
A forrás szerint a Cosmos 3 Nano esetében a transformer a single-GPU generálási idő 93,4 százalékát adja, ezért ennek gyorsítása hozza a legnagyobb hatást. A 35 denoising lépés mindegyikénél egy negatív vagy unconditional predikció és egy prompt-conditioned predikció szükséges a CFG-hez. Emiatt a Diffusers proxy lépésenként két egymást követő Triton hívást végez, összesen 70 transformer RPC-t generálásonként.
A többeszközös működéshez az elosztott Ulysses gráfot minden TensorRT tervbe még telepítés előtt fordítják bele. Az NVIDIA hangsúlyozza, hogy a Dynamo-Triton konfigurációja ezt a tervet aktiválja, vagyis nem egy egyeszközös motort alakít át futás közben elosztott motorrá. A single-device alapváltozat egy szabványos GPU modellpéldányt használ a GPU 0 eszközön, míg a két, négy és nyolc GPU-s változatok KIND_MODEL beállítással, bekapcsolt multi-device útvonallal és megadott résztvevő rangokkal futnak.
Mért késleltetés: 156,595 másodpercről 34,183 másodpercre
A tesztek mind a négy változatnál ugyanazon az egészséges, nyolc GPU-s NVIDIA rendszeren futottak. Az egyeszközös alapmérés egy GPU-t használt, a CP2, CP4 és CP8 változat pedig két, négy, illetve nyolc rangot. Minden futás 1280×720-as kimenetet, 189 képkockát 24 FPS mellett és 35 denoising lépést alkalmazott. Az eredmények egy bemelegítő futás után öt mért teljes generáláson alapulnak.
Az időmérésbe beletartozott a promptfeldolgozás, a 70 Dynamo-Triton hívás, a CFG és az ütemező frissítései, a VAE dekódolás, valamint a képkockák utófeldolgozása. A modellbetöltést és az mp4 kódolást az NVIDIA kizárta a mérésből.
- SD, 1 GPU: 156,595 másodperc end-to-end átlag, 146,192 másodperc RPC átlag, 93,4 százalék RPC arány.
- CP2, 2 GPU: 87,999 másodperc end-to-end átlag, 1,78x end-to-end gyorsulás, 77,548 másodperc RPC átlag.
- CP4, 4 GPU: 53,093 másodperc end-to-end átlag, 2,95x end-to-end gyorsulás, 42,661 másodperc RPC átlag.
- CP8, 8 GPU: 34,183 másodperc end-to-end átlag, 4,58x end-to-end gyorsulás, 23,993 másodperc RPC átlag, 6,09x RPC gyorsulás.
Az egy GPU-s futásnál a transformer RPC-k a generálási idő 93,4 százalékát tették ki. CP8 esetén ez az arány 70,2 százalékra csökkent. A forrás szerint a mért RPC útvonalon kívüli idő a különböző konfigurációkban 10,2 és 10,5 másodperc között maradt, ezért a promptmunka, az ütemező frissítései, a VAE dekódolás, az utófeldolgozás és más kliensoldali többletek nagyobb részt képviselnek a teljes időből.
Nem pixelazonos kimenetet ígérnek, hanem ellenőrzött minőséget
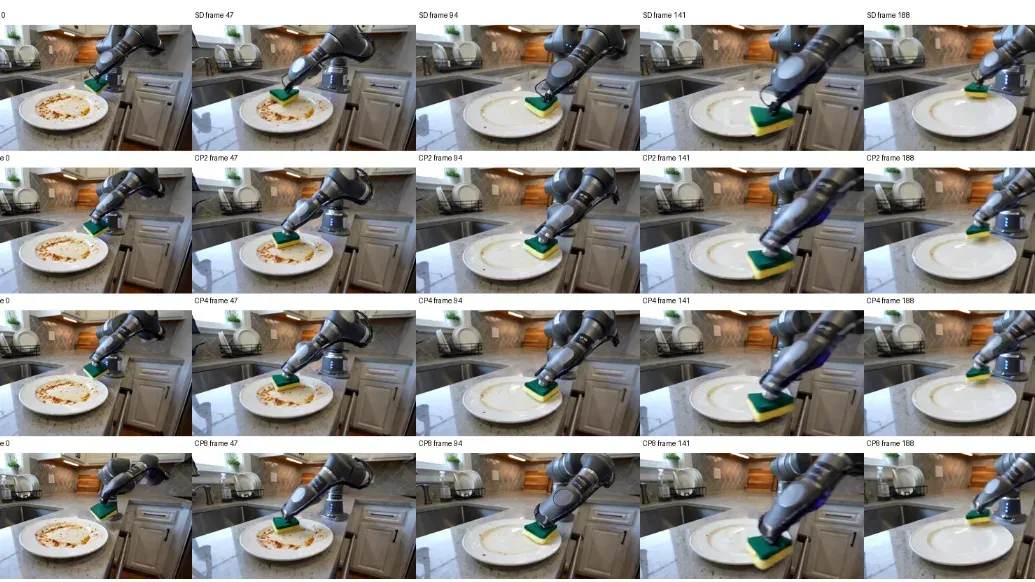
Az NVIDIA a teljesítménymérés mellett a generált kimenetet is ellenőrizte. Minden változat ugyanazt a seedet és generálási profilt használta. A validáció a 0., 47., 94., 141. és 188. képkockát mintavételezte, ellenőrizte a formátumot és az időbeli változást, majd minden context-parallel kimenetet összevetett az egyeszközös eredménnyel.
A CP2, CP4 és CP8 futások megfeleltek a beállított küszöböknek: a mean absolute error, vagyis MAE értéknek legfeljebb 25-nek, a peak signal-to-noise ratio, vagyis PSNR értéknek pedig legalább 18 dB-nek kellett lennie. A forrás külön jelzi, hogy a kimenetekre nem állítanak pixelazonosságot.
A CP2 és CP4 esetében az NVIDIA 12,759 MAE és 21,111 dB PSNR értéket mért. A CP8 futásnál a MAE 16,316, a PSNR 19,400 dB volt. A bemutatott képlap a leírás szerint ugyanazt a koherens akciót mutatta a klipben: egy robotkar tányért tisztít.
Mit jelent ez a modellkiszolgálást használó csapatoknak
Az NVIDIA szerint az integráció azoknak a szervezeteknek lehet gyakorlati opció, amelyek generatív AI-t telepítenek, és a rövidebb válaszidő üzleti értéke nagyobb, mint az egy kéréshez rendelt GPU-k számának minimalizálása. A megközelítés lényege, hogy a csapatok további GPU-erőforrást válthatnak rövidebb kéréskésleltetésre, miközben az alkalmazás felülete és a környező munkafolyamat stabil maradhat.
A forrás alapján a modell TensorRT terve verziózott Triton modellként csomagolható, a rangok és kommunikátorok életciklusának kezelése pedig nem kerül a kliensoldali kódba. Ez különösen a késleltetésérzékeny generatív médiás munkafolyamatoknál számíthat, ahol a rövidebb eredményre várási idő a felhasználói várakozást és az átnézés, finomítás ciklusait is csökkentheti.
Az NVIDIA a következő lépések között a Dynamo-Triton 26.07 NGC-ről történő letöltését, a Dynamo-Triton TensorRT backend többeszközös útmutatójának áttekintését, valamint a TensorRT Multi-Device dokumentációjának megismerését javasolja.