4 bites modell előzné meg a teljes pontosságú eredetit a Hugging Face-poszt szerint
Elton Williams 2026. augusztus 25-én a Hugging Face-en írt a Quantization-Aware Healing nevű megközelítésről. A bejegyzés szerint egy tömörített, 4 bites modell több mérésben is felülmúlta a teljes pontosságú kiinduló változatát.
- A Hugging Face-poszt a Quantization-Aware Healing nevű helyreállítási megközelítést mutatja be.
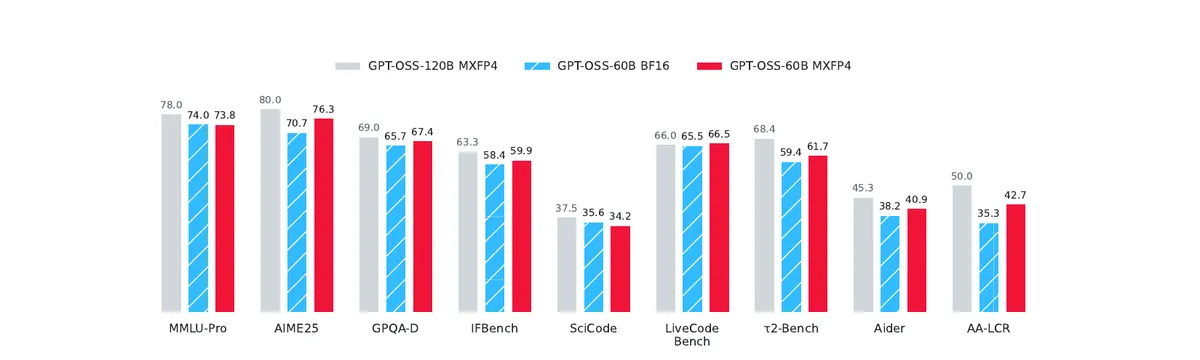
- A szerző szerint egy GPT-OSS 120B-ből 60B-re tömörített MXFP4 modell 9 benchmarkból 7-en verte a bfloat16 ellenőrzőpontját.
- A bejegyzés szerint a tömörítés és a 4 bites kvantálás általában rontja az érvelést, a matematikát és a kódgenerálást.
- Egy hozzászóló módszertani kontroll hiányára és ellentmondó leírásokra hívta fel a figyelmet.
- A lehetséges előny a kisebb memóriaigény és az alacsonyabb inferenciaköltség lehet.
A tömörítés ára és a gyógyítás szerepe
A Hugging Face-en megjelent bejegyzés abból indul ki, hogy a nagy nyelvi modellek kisebbé tétele szinte mindig teljesítményvesztéssel jár. A szerző szerint a hatékony telepítésben ma elterjedt eljárás az, hogy először az architektúrát tömörítik, például rétegek, fejek vagy neuronok eltávolításával, majd a megmaradt súlyokat 4 bitre kvantálják, hogy tovább csökkenjen a memóriaigény és a számítási költség.
A poszt szerint a két lépés együtt éppen azokban a képességekben okozhat romlást, amelyek a felhasználók számára fontosak: az érvelésben, a matematikai feladatmegoldásban és a kódgenerálásban. Emiatt a komolyabb telepítési folyamatokban a modell éles használata előtt helyreállító lépést alkalmaznak, amelyet a bejegyzés healing néven említ.
A szerző példaként a gpt-oss, az NVIDIA Nemotron család és a Hypernova 60B nyílt súlyú kiadásait említi, amelyek szerinte valamilyen tömörítés utáni helyreállítási megközelítésre támaszkodnak.
Mit állít a Quantization-Aware Healing?
A Quantization-Aware Healing, röviden QAH lényege a bejegyzés alapján az, hogy a helyreállítási folyamatot már a kvantált modell szempontjaihoz igazítják. A szerző állítása szerint ez a célzott helyreállítás nemcsak visszahozhat elveszett képességeket, hanem bizonyos esetekben javíthatja is azokat.
A poszt kiemelt példája a GPT-OSS 120B modell 60B méretre tömörített változata. A szerző szerint a kisebb MXFP4 modell 9 benchmarkból 7-en felülmúlta a saját bfloat16 ellenőrzőpontját. A bejegyzés ezt annak bizonyítékaként mutatja be, hogy egy 4 bites, erősen tömörített modell megfelelő helyreállítással akár jobb eredményt is elérhet, mint a teljes pontosságú kiinduló változat.
A forrás nem közöl részletes benchmarklistát a megadott szövegrészben, ezért az eredmények értelmezése a szerző összefoglaló állítására korlátozódik.
Vita a módszertan körül
A bejegyzés alatt 2026. augusztus 29-én Saga, a Hugging Face egyik felhasználója módszertani kifogást fogalmazott meg. Szerinte a címben szereplő összehasonlításból hiányzik egy kontroll: a bf16 60B modell egy desztillációs kört kapott, míg az MXFP4 60B változat ezt követően egy második kört is, jobb tanítómodelltől.
A hozzászóló szerint így nem lehet egyértelműen szétválasztani, hogy a javulás a QAH recept érdeme-e, vagy annak a következménye, hogy az egyik ellenőrzőpontot hosszabb ideig, több számítással és tanítómodell ellenében tréningezték. A komment arra is felhívja a figyelmet, hogy az eredménytábla a tanítót „120B teacher (MXFP4)” néven jelöli, miközben a megközelítést leíró rész teljes méretű és teljes pontosságú tanítóról beszél.
Mit jelenthet ez a felhasználóknak és a piacnak?
Ha a bejegyzésben leírt megközelítés más modelleken és terheléseken is működik, a tömörítés kevésbé jelentene automatikus minőségromlást. A forrás szerint a cél egy kisebb, olcsóbban futtatható modell, amely közben erősebb benchmarkteljesítményt adhat az érvelésben, matematikában és kódolásban.
A gyakorlati jelentőség a memóriahasználatban és az inferenciaköltségben lehet, mivel a 4 bites kvantálás ezek csökkentését célozza. A módszertani hozzászólás miatt ugyanakkor a konkrét állítások megítéléséhez fontos lenne az azonos feltételek melletti összehasonlítás.