nyelvi modellek
A beszédre optimalizált szöveg generálását kutatja a NAVER LABS Europe
A NAVER LABS Europe olyan nagy nyelvi modellek fejlesztését vizsgálja, amelyek közvetlenül beszédszintézishez alkalmas szöveget állítanak elő. A kutatók szerint a…
A tapasztalatokból tanuló LLM-ügynökök módszerét mutatta be a NAVER
A NAVER LABS Europe kutatói olyan nagy nyelvi modellekre épülő ügynökök betanítási módszerét mutatták be, amely a korábbi tapasztalatok visszakeresését és a felügyelt…
SPLADE-Code: ritka keresőmodelleket fejlesztettek kódhoz
A NAVER LABS Europe bemutatta a SPLADE-Code modellsorozatot, amelyet kifejezetten forráskódok keresésére fejlesztettek. A kutatók szerint a rendszer 1 millió…
A látható minták még nem bizonyítják, hogyan gondolkodik egy AI
A NAVER LABS Europe kutatása szerint a látens gondolkodási modellekben megfigyelhető minták önmagukban nem bizonyítják, hogy a modellek valóban az ezekhez társított…
Gyorsabb újrarangsorolást mutatott be a NAVER LABS Europe
A NAVER LABS Europe olyan újrarangsoroló rendszert mutatott be, amely a dokumentumokat többutas, rögzített méretű beágyazási reprezentációkká tömöríti. A cég szerint az…
Az Aleph Alpha bemutatta a Kolibri nevű, nyílt súlyú AI-modellt
Az Aleph Alpha bemutatta a Kolibrit, egy német és angol nyelvre fejlesztett, nyílt súlyú Mixture-of-Experts modellt. A 78 milliárd teljes és 3 milliárd aktív…

A Baseten szerint akár 90 százalékkal gyorsabb lett az AI-inferencia
A Baseten egy LLM által létrehozott, egyedi inferenciamotorral akár 90 százalékkal jobb egyfolyamos dekódolási sebességet ért el a vLLM-nél. A VibeQwen nevű motor…
FejlesztőknekA Helion gyorsíthatja a vLLM LLM-inferenciáját NVIDIA GPU-kon
A PyTorch Helion-alapú lineáris backendet integrált a vLLM-be, hogy automatikus hangolással javítsa a nagy nyelvi modellek következtetési teljesítményét. Az NVIDIA…
Az olcsóbb működéshez önmagában nem elég a promptok gyorsítótárazása
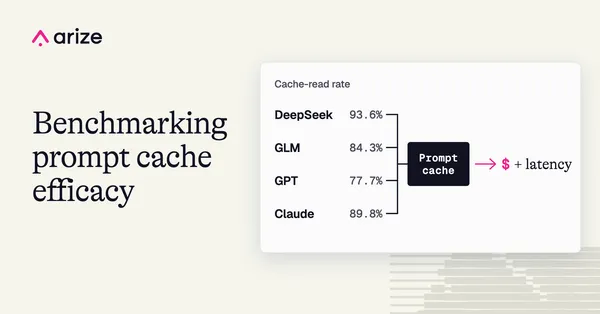
A promptok gyorsítótárazása csökkentheti az ismétlődő bemenetek feldolgozásának költségét, de az Arize AI tesztje szerint a magas cache újraolvasási arány önmagában nem…
A Baseten szerint 200 token/másodperc felett fut nála a GLM-5
A Baseten állítása szerint a GLM-5 több mint 200 token/másodperces sebességet ért el a szolgáltatásán, miközben az első tokenig eltelt idő körülbelül 200 ezredmásodperc…
ModellekAz OpenAI útmutatót adott ki a GPT-6 modellek használatához
Az OpenAI gyakorlati útmutatóban mutatja be, hogyan érdemes kiválasztani és használni a GPT-6 család modelljeit. A dokumentum a fejlesztési feladatoktól a több napon át…
Az AWS többfordulós megerősítéses tanulással fejleszt keresőügynököt
Az AWS bemutatta, hogyan hangoltak finomra egy keresőügynököt többfordulós megerősítéses tanulással az Amazon SageMaker AI szolgáltatásban. A módszer célja, hogy kisebb…
Az Allen Institute nyílt forrásúvá tette az AstaBrief modellt
Nyílt forrású modellként jelent meg a Hugging Face-en az AstaBrief, amelyet az Asta gyors jelentéskészítő modelljeként mutatnak be. A bejelentéshez a teljes képzési…
A Google szeptemberi AI újdonságai: Gemini 4 Argon és WeatherNext 3
A Google szeptemberben bemutatta a Gemini 4 Argon modellt, új hangalapú AI-eszközöket és a Gemini alkalmazáshoz kapcsolható szolgáltatásokat. A vállalat tudományos…
Kimi K3: Claude-klón vagy önálló fejlesztés?
A Moonshot AI Kimi K3 modellje 2,8 billió paraméterével az első nyílt súlyú modell ezen a méreten. A megjelenés után felmerült, hogy a fejlesztés Anthropic-modellből…
A CoreWeave szerint élmezőnyben a Kimi K2.7 Code ár-teljesítménye
Elérhetővé vált a Moonshot AI Kimi K2.7 Code modellje a CoreWeave Serverless Inference szolgáltatásán. A CoreWeave szerint a modell a szolgáltatók között a legmagasabb…
A CoreWeave 512 H100 GPU-n tesztelte a torchforge RL-keretrendszert
A CoreWeave támogatást jelentett be a torchforge nevű, PyTorch-ra épülő, elosztott megerősítéses tanulási keretrendszerhez. A vállalat a Meta és a Stanford Scaling…
A LangChain modellirányítóval 64 százalékkal csökkentette a költséget
A LangChain modellirányítót épített nyílt forráskódú Open SWE kódoló ügynökébe, amely a feladat összetettsége alapján választ a modellek között. A vállalat kísérleteiben…
64 GB memóriával jön az NVIDIA DGX Spark új változata
Az NVIDIA 2026. október 2-án bejelentette a DGX Spark 64 GB-os, egyesített memóriával szerelt konfigurációját. A rendszer október 23-án érkezik az Acer, ASUS, Dell…
Az Ai2 megnyitotta az AstaBrief tudományos jelentéskészítő modellt
Az Ai2 nyílt súlyokkal és a tanításához használt adatokkal együtt tette közzé az AstaBrief 8B modellt, amely tudományos kérdésekből és visszakeresett szakirodalmi…

Az Apple új módszerrel vizsgálta a többnyelvű modellek működését
Az Apple kutatói egy tanítás nélküli, ABX-alapú módszercsaládot mutattak be a többnyelvű nyelvi modellek vizsgálatára. A megközelítés azt méri, hogy a modellek mennyire…
Az OpenRouter új oldalon hasonlítja össze a modellroutereket
Az OpenRouter új Model Router Benchmarks oldalt indított, amely különböző területeken méri össze a modellrouterek teljesítményét. A rendszer a válaszminőséget, a…
A Vercel bemutatta a Jev modellt, amely gyors döntésekre készült
A Vercel AI SDK for Python új, kísérleti evaluate() API-ja egyszerű hozzáférést ad a Jevhez, egy olyan modellhez, amely feleletválasztós kérdésekre válaszol, és a…
Új történetmotorral fejleszti interaktív világait a Hidden Door
A Hidden Door frissítette az interaktív történeteket működtető, fordulóról fordulóra dolgozó motorját. A vállalat szerint a rendszer élesebben reagál a játékos…