A külön szerepekre bontott AI-rendszer sokkal több kódot fedett le
A Factory Research vizsgálata szerint a nagy szoftveres feladatoknál jelentősen javíthatja az eredményt, ha a kódoló ügynök mellett külön szerep felel a teljesítés méréséért. A 24 vizsgált ProgramBench-feladat közül többnél a többszereplős rendszer jóval magasabb viselkedési egyezést ért el, miközben az alapul szolgáló modell nem változott.
- A Factory 24 nehéz ProgramBench-feladaton hasonlított össze egy- és többszereplős rendszereket.
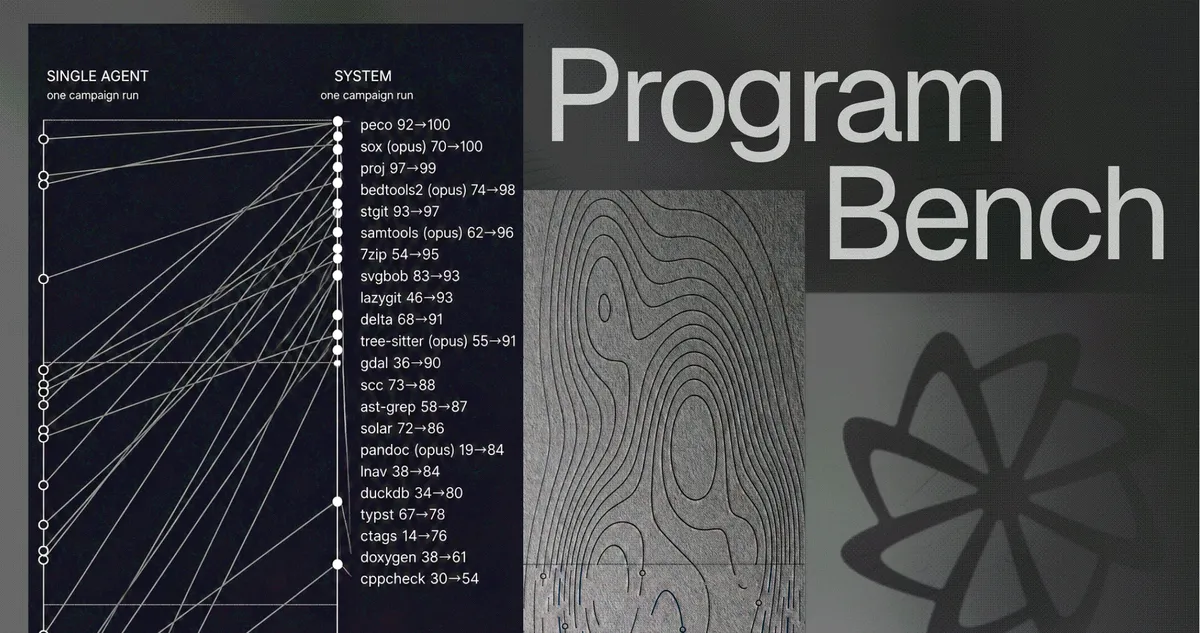
- A GDAL egyetlen ügynökkel 36, külön validátorral dolgozó rendszerrel 90 százalékos egyezést ért el.
- A többszereplős rendszer a 7-Zip eredményét 54-ről 95 százalékra javította.
- A ProgramBench referencia programok feketedobozos, viselkedésalapú újraépítését méri.
A GDAL újraépítésénél mutatkozott meg a különbség
A Factory három modellt és 24 kiválasztott ProgramBench-feladatot hasonlított össze egyetlen ügynökkel, illetve több külön szerepre bontott rendszerrel. Az egyik tesztben a Droidnak a GDAL parancssori eszközt kellett a semmiből újraépítenie. A referencia program futtatható volt, de a modell nem férhetett hozzá a forráskódhoz, a tesztekhez vagy az internethez.
A GDAL a geospaciális adatfeldolgozásban használt eszköz, amelyet a Factory szerint 1998 óta fejlesztenek. A projekt a QGIS, az ArcGIS és a PostGIS mögött is jelen van, és több mint kétszáz raszteres és vektoros formátumot kezel. A teljes upstream kódbázis körülbelül 2 millió soros, a parancssori felületen keresztül elérhető rész pedig mintegy 600 ezer sornyi.
Az egyetlen ügynök 17 ezer sor C++ kódot írt, és a program viselkedésének 36 százalékát reprodukálta. A Factory szerint a gyakori használati útvonalak működtek, de a program nagy része hiányzott. Az ügynök nem idő- vagy költségkorlát miatt állt le, saját értékelése alapján befejezettnek tekintette a munkát.
A második futtatásban a rendszer külön szerepeket kapott. A megvalósítás előtt egy önálló szerep meghatározta, mit kell tudnia az újraépítésnek, és milyen bizonyíték igazolná a teljesítést. Ez a változat 115 ezer sorra nőtt, és 90 százalékos viselkedési egyezést ért el.
A validáció hiánya miatt az ügynök túl korán állhat le
A Factory magyarázata szerint a kódoló ügynökök általában menet közben ellenőrzik a munkájukat. Elkészítenek egy részt, néhány ellenőrzést írnak vagy futtatnak, megvizsgálják a kimenetet, majd eldöntik, folytatják-e. Ez kisebb módosításoknál működőképes lehet, mert a feladat, a megvalósítás és az ellenőrzés egyetlen áttekinthető egységet alkot.
Nagy projektekben azonban a munkát funkciókra, alrendszerekre és egymást követő fejlesztési körökre kell bontani. Az ügynök ilyenkor nemcsak egy rész elkészítéséről dönt, hanem arról is, milyen bizonyíték számít elegendőnek. Az így létrehozott ellenőrzések könnyen csak azt mérik, amit az ügynök már eleve megépített. Kimaradhatnak azok a funkciók, együttműködések vagy korlátozások, amelyeket az ügynök soha nem vett fel a feladat képébe.
Így minden helyi döntés lehet ésszerű, miközben a teljes eredmény jelentős része mérés nélkül marad. A Factory szerint az ügynök ilyenkor nem feltétlenül azért nem valósítja meg a hátralévő részt, mert erre képtelen, hanem azért, mert nem alakított ki teljes képet arról, mi hiányzik még.
A rendszer már a fejlesztés előtt kialakítja a mércét
A vizsgálatban használt többszereplős megközelítés a megvalósítástól függetlenül állított fel egy teljesítési szabványt. Ennek tartalmaznia kellett, mit kell ellenőrizni, milyen eljárással lehet ezt megtenni, és milyen aktuális bizonyíték igazolja, hogy az elkészült program megfelel.
A mércét a követelményekből és a releváns igazodási pontokból kellett levezetni még azelőtt, hogy a fejlesztés kisebb munkatételekre szűkítette volna a feladatot. A szabvány közben módosítható: új ellenőrzések adhatók hozzá, a meglévők lecserélhetők vagy pontosíthatók. A Factory szerint azonban nem szabad annak megfelelően összezsugorodnia, amit addig sikerült megépíteni.
Ez a gyakorlat az emberi fejlesztésben sem ismeretlen. A biztonságkritikus projektek követhetőséget használnak a követelményekhez, valamint független ellenőrzést és validációt alkalmaznak. A szabványügyi szervezetek megfelelőségi tesztcsomagokat készítenek, a termékcsapatok pedig elfogadási teszteket írnak. Az ilyen átfogó mérce minden projektnél történő kialakítása azonban költséges.
A ProgramBench a feketedobozos újraépítést méri
A ProgramBench tisztaszobás szoftverfejlesztési mérce. Minden feladat egy referencia programot, tesztadatokat és részleges dokumentációt ad. A referencia feketedobozként működik: futtatni lehet, de a forráskódja nem olvasható, nem lehet visszafejteni vagy nyomon követni. A cél a program megfigyelhető viselkedésének újraalkotása a semmiből, amelyet rejtett viselkedési ellenőrzések alapján pontoznak.
A Factory a 200 feladat közül 24-et választott ki, a nyilvános ranglistán elért legjobb eredmény alapján, külön súlyt adva az alacsonyabb pontszámú, nehezebb feladatoknak. A GDAL mellett a 7-Zip újraépítésénél 54 százalékról 95 százalékra, a DuckDB esetében pedig 34 százalékról 80 százalékra nőtt az egyezés. Több újraépítés a kilencvenes százalékos tartomány felső részébe jutott.
A felhasználók és a fejlesztőcsapatok számára a kutatás azt jelzi, hogy nagy kódolási feladatoknál önmagában a megvalósító ügynök teljesítménye nem feltétlenül mutatja meg, mennyire teljes az eredmény. A Factory által vizsgált rendszer a kódolási folyamat mellett külön erőforrást fordított a hiányzó viselkedések feltérképezésére és ismételt mérésére.