Néhány paranccsal futtathatók AI-modellek NVIDIA edge-eszközökön
Az NVIDIA TensorRT Edge-LLM néhány paranccsal teszi lehetővé AI-modellek előkészítését és futtatását a DGX Spark 64GB számítógépen. A fejlesztők a Nemotron-3.5 Lightning modellt helyben, terminálból vagy OpenAI-kompatibilis API-n keresztül is használhatják.
- A TensorRT Edge-LLM a DGX Spark 64GB gépen támogatja az AI-modellek fejlesztését és tesztelését.
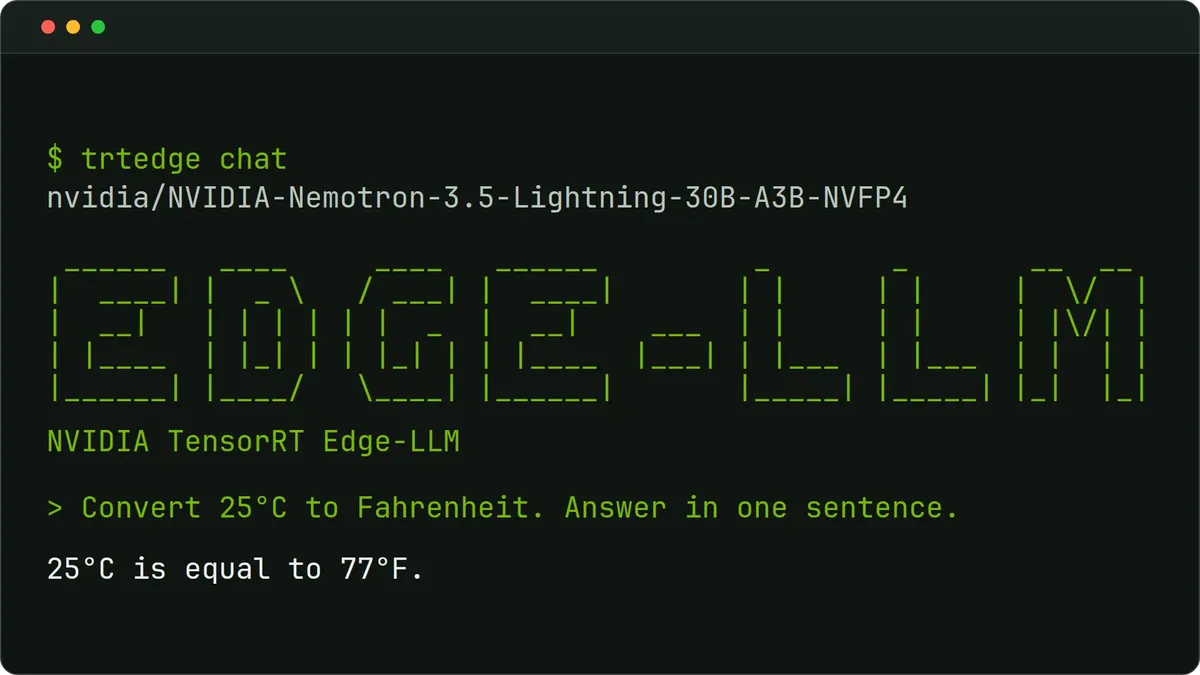
- A trtedge CLI letölti a modellt és felépíti a TensorRT-motort.
- A Nemotron-3.5 Lightning terminálból és helyi, OpenAI-kompatibilis API-n keresztül is futtatható.
- DSpark használatával a HumanEval mérés generálási sebessége 73,4-ről 126,9 tokenre nőtt másodpercenként.
- A futtatókörnyezet Jetson Thor, DRIVE AGX Thor és IGX Thor platformokra is szánt telepítési útvonalat kínál.
Fejlesztési környezet beágyazott rendszerekhez
Az NVIDIA oktatóanyaga 2026. október 30-án jelent meg, és az edge alkalmazások fejlesztését mutatja be a DGX Spark 64GB konfigurációján. A vállalat szerint a platformon a fejlesztők AI-modelleket és ügynököket prototipizálhatnak, finomhangolhatnak és tesztelhetnek.
Az edge-en futó alkalmazások között az NVIDIA a vezető figyelmének és az utastér állapotának megfigyelését, a robotok környezetértelmezését és feladatok megtervezését, valamint a gyártósori gépflották koordinálását említi. Ezeknél a rendszereknél a modelleknek szűk memória-, energia- és késleltetési korlátok mellett kell működniük.
A TensorRT Edge-LLM könnyű, C++ alapú következtetési futtatókörnyezetet biztosít beágyazott munkaterhelésekhez. Ugyanez a keretrendszer használható a DGX Sparkkal végzett fejlesztéshez, majd olyan platformokra történő telepítéshez, mint az NVIDIA Jetson Thor, az NVIDIA DRIVE AGX Thor és az NVIDIA IGX Thor.
A trtedge tölti le a modellt és építi fel a motort
A folyamat központi eleme a trtedge parancssori felület. A szükséges környezethez támogatott NVIDIA-szoftververem, NVIDIA CUDA 13, a TensorRT 10.16.1.11-es vagy újabb, de még 10.x sorozatú változata, valamint Python 3.10 és 3.12 közötti verzió szükséges. A példákat a TensorRT Edge-LLM 0.11.1 és a TensorRT 10.16.1.11 használatával tesztelték.
Az útmutatóban a fejlesztő a nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4 modellt indítja el a DGX Sparkkon. Az első indításkor körülbelül 21 GB méretű letöltésre és a TensorRT-motor felépítésére kell várni. A fájlok alapértelmezés szerint a ~/.cache/tensorrt-edgellm könyvtárba kerülnek, a későbbi indítások pedig újrahasználják az illeszkedő gyorsított motorokat.
A modell terminálos beszélgetésben is kipróbálható. Az NVIDIA példája egy Celsius-fok Fahrenheitre váltását használja, a munkamenet pedig további kérdésekkel folytatható, vagy a /exit paranccsal zárható le.
Helyi API és gyorsabb generálás DSparkkal
A TensorRT Edge-LLM helyi, OpenAI-kompatibilis API-szervert is indít. A fejlesztők a 127.0.0.1 címen, a 8000-es porton szolgálhatják ki a modellt, majd a /health/ready végponton ellenőrizhetik, hogy a szerver készen áll-e. A chat completions végpont streamelt JSON-eseményekben küldi a választ, így az alkalmazás prototipizálásához és teszteléséhez közvetlenül használható.
Az NVIDIA bemutatja a DSpark spekulatív dekódolást is. Ez egy kisebb, úgynevezett vázlatmodell segítségével több tokent javasol a fő modellnek, amelyeket egyetlen menetben ellenőriz. A példában három vázlattokent használnak.
A DGX Spark 64GB mérésében a HumanEval promptoknál a generálási sebesség DSpark nélkül 73,4 token volt másodpercenként, DSpark használatával pedig 126,9 token másodpercenként. A medián első tokenig eltelt idő 98,1 ezredmásodpercről 98,7 ezredmásodpercre változott. SpeedBench 1K esetén a sebesség 73,3-ról 108,5 tokenre nőtt másodpercenként, SpeedBench 2K esetén pedig 72,8-ról 105,3-ra.
A DSpark melletti csúcsponti teljes rendszermemória-használat 27,9 GB volt, az operációs rendszert is beleszámítva. A mérést DGX OS 7.6.0, Ubuntu 24.04.4 LTS alatt, NVFP4 használatával, egyes kötegmérettel, egy párhuzamos streamelt kéréssel és 128 tokenes kimeneti korláttal végezték.
További modellek és edge-alkalmazások
Az NVIDIA szerint a fejlesztők a támogatott modellek listájáról további lehetőségeket is kipróbálhatnak a Sparkkon. Ezek között képeket és videókat értelmező látás-nyelvi modellek, beszédfelismerő modellek és szövegfelolvasó modellek is szerepelnek.
A TensorRT Edge-LLM dokumentációja a célplatformtól és a modelltől függő munkafolyamatokat és követelményeket ismerteti. Az NVIDIA a Nemotron fejlesztői oldalát, a Hugging Face-en elérhető nyílt Nemotron-modelleket és adatkészleteket, valamint a build.nvidia.com oldalon található Blueprint-eket is a továbblépés lehetséges forrásaként jelöli meg.
NVIDIA Developer: Run AI Models for Edge Application Development with Just a Few Commands