AI-ügynökök írhatják át a Spark UDF-jeit GPU-gyorsításra
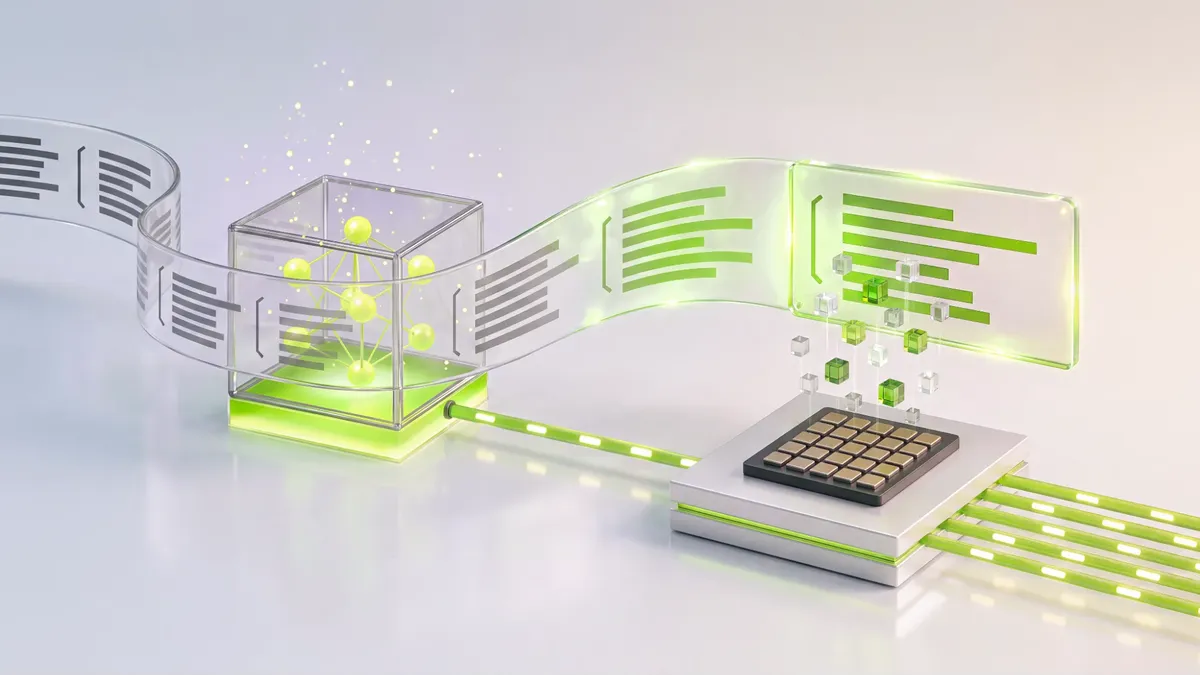
Az NVIDIA olyan AI-ügynökökkel támogatott munkafolyamatot mutatott be, amely Apache Spark-felhasználói függvényeket ír át GPU-gyorsításra. A vállalat szerint a módszerrel egyes Spark-feladatok több mint hússzoros gyorsulást érhetnek el.
- Az UDF-ek CPU-ra kényszeríthetik az egyébként GPU-n futó Spark-folyamatot.
- Az átírás SQL-lel, a RapidsUDF interfésszel vagy egyedi CUDA-kernellel végezhető el.
- Az NVIDIA szerint a gyorsulás meghaladhatja a 20-szorost.
- Egy vállalat több mint 30 éles UDF-et alakított át AI-ügynökökkel.
- Egy 600 milliárd soros terhelésnél 274,55 óráról 12,78 órára csökkent az operátori idő.
A felhasználói függvények megtörik a GPU-s feldolgozást
Az Apache Spark deklaratív SQL- és DataFrame-felülete lehetővé teszi, hogy a rendszer a lekérdezés eredményét és végrehajtásának módját elkülönítse egymástól. Az NVIDIA cuDF plugin for Apache Spark ezt használja ki, amikor a műveleteket GPU-n, párhuzamosan hajtja végre.
A felhasználói függvények, vagyis az UDF-ek egyedi üzleti logikát tartalmazhatnak, ezért a Spark gyorsítója általánosságban nem tudja őket ugyanígy értelmezni és párhuzamosítani. A feldolgozás ilyenkor visszakerül a CPU-ra. Az adatokat oszlopos formátumból soralapú formára kell alakítani, a függvény végrehajtása után pedig vissza kell alakítani, ami adatmozgatási többlettel jár. Az NVIDIA szerint az UDF így a GPU-s végrehajtás lehetséges teljesítményelőnyéről is lemond.
Három út vezethet a GPU-kompatibilis kódhoz
Az NVIDIA három módszert ismertet az UDF-ek átírására. Egyszerű, relációs logikánál a Spark SQL-kifejezés használata a legmagasabb szintű és legkevesebb munkát igénylő megoldás. A vállalat példája egy Celsius-fokokat Fahrenheitre átszámító függvény, amely SQL-ben közvetlenül egy matematikai kifejezéssé alakítható.
Összetettebb esetekben a fejlesztők a cuDF Java API-jára épülő RapidsUDF interfészt használhatják. Ennek evaluateColumnar metódusa GPU-n tárolt oszlopokon hajt végre műveleteket, így többek között karakterlánc-feldolgozásra és beágyazott adattípusokra is alkalmas lehet. A legösszetettebb vagy teljesítménykritikus logikához egyedi CUDA-kernel is készíthető a Java Native Interface-en, vagyis JNI-n keresztül.
Az NVIDIA szerint az UDF-ek megfelelő primitívekkel történő átírása több mint 20-szoros gyorsulást eredményezhet, miközben megszünteti a gyorsító és a CPU közötti visszaesés többletét.
Az AI-ügynökök teszteléssel és méréssel segítenek
Az NVIDIA által bemutatott cuDF skills for Apache Spark négy, egymásra épülő visszacsatolási folyamatba szervezi az átírást: tesztelésbe, konverzióba, teljesítménymérésbe és optimalizálásba. A munkafolyamat minden szakaszban meghatározza az elvégzendő feladatot és a továbblépéshez szükséges bizonyítékot.
A csomag projektmintát is biztosít Spark- és cuDF-specifikus környezettel, teszt- és benchmarkkeretekkel, kimenet-ellenőrzési rutinokkal, valamint buildbeállításokkal. Az AI-ügynök így ismeretlen API-kat kereshet fel, jelölt átírásokat készíthet, majd futtatható tesztek és teljesítménymérések alapján módosíthatja azokat.
Az NVIDIA közlése szerint egy nagy fogyasztástechnológiai vállalat ezzel a munkafolyamattal több mint 30 éles UDF-et alakított át. Egy átírás egy 600 milliárd soros terhelésnél 274,55 óráról 12,78 órára csökkentette az operátori időt. A cuDF skills for Apache Spark telepítésével a fejlesztők megkezdhetik az UDF-ek átírását, a GPU-gyorsítást pedig a cuDF plugin for Apache Spark beállítási útmutatója alapján kapcsolhatják be a Spark-folyamatokban.
NVIDIA Developer: How to Rewrite Apache Spark UDFs for GPU Acceleration with AI Agents