Az Ai2 új tesztje az LLM-ek rejtett előítéleteit vizsgálja
Az Ai2 bemutatta a FairStress nevű benchmarkot, amely azt méri, mennyire stabilak és szimmetrikusak a nagy nyelvi modellek döntései demográfiai szempontból érzékeny helyzetekben. A teszt azt is vizsgálja, hogy azonos meggyőző érvek eltérő hatást gyakorolnak-e a modellre attól függően, melyik társadalmi csoport javára szólnak.
- A FairStress a döntések stabilitását is méri, nem csak a végső választást.
- A benchmark 300 helyzetből és több mint 13 millió tesztesetből áll.
- Az identitás kifejezettebb megjelenésekor nőtt a modellek viselkedésének aszimmetriája.
- A FairStress-Core 50 ezer elemből álló, gyorsabb értékelésre szánt részhalmaz.
- Az Ai2 a benchmarkot az Olmo-eval értékelési munkapadba is beépíti.
A végső válasz mögötti viselkedést is mérik
Az Ai2 szerint a nagy nyelvi modelleket egyre gyakrabban használják olyan helyzetekben, amelyek hatással lehetnek az emberek lehetőségeire, erőforrásaira és ellátására. Ilyen lehet az állásra jelentkezők szűrése, a hitelkérelmek elbírálása, a betegek kezelési sorrendjének meghatározása vagy a hallgatói felvételi döntés.
A hagyományos demográfiai igazságossági tesztek gyakran azt ellenőrzik, hogy a modell ugyanazt a jelöltet választja-e, amikor egyébként azonos helyzetben csak a jelöltek demográfiai identitását cserélik fel. A FairStress ennél tovább megy. Azt is méri, hogy a modell mennyire könnyen változtatja meg a döntését, amikor egy meggyőző érvvel megpróbálják eltéríteni.
Az Ai2 ezeket az érveket adversarial prefixeknek nevezi. Példaként olyan állításokat használnak, amelyek vezetői ajánlásra, társadalmi konszenzusra, jogi szempontokra vagy történelmi hátrányokra hivatkoznak. Minden érvhez tartozik egy párja, amely ugyanazt a típusú indoklást a másik jelölt mellett használja.
300 helyzet, több mint 13 millió teszteset
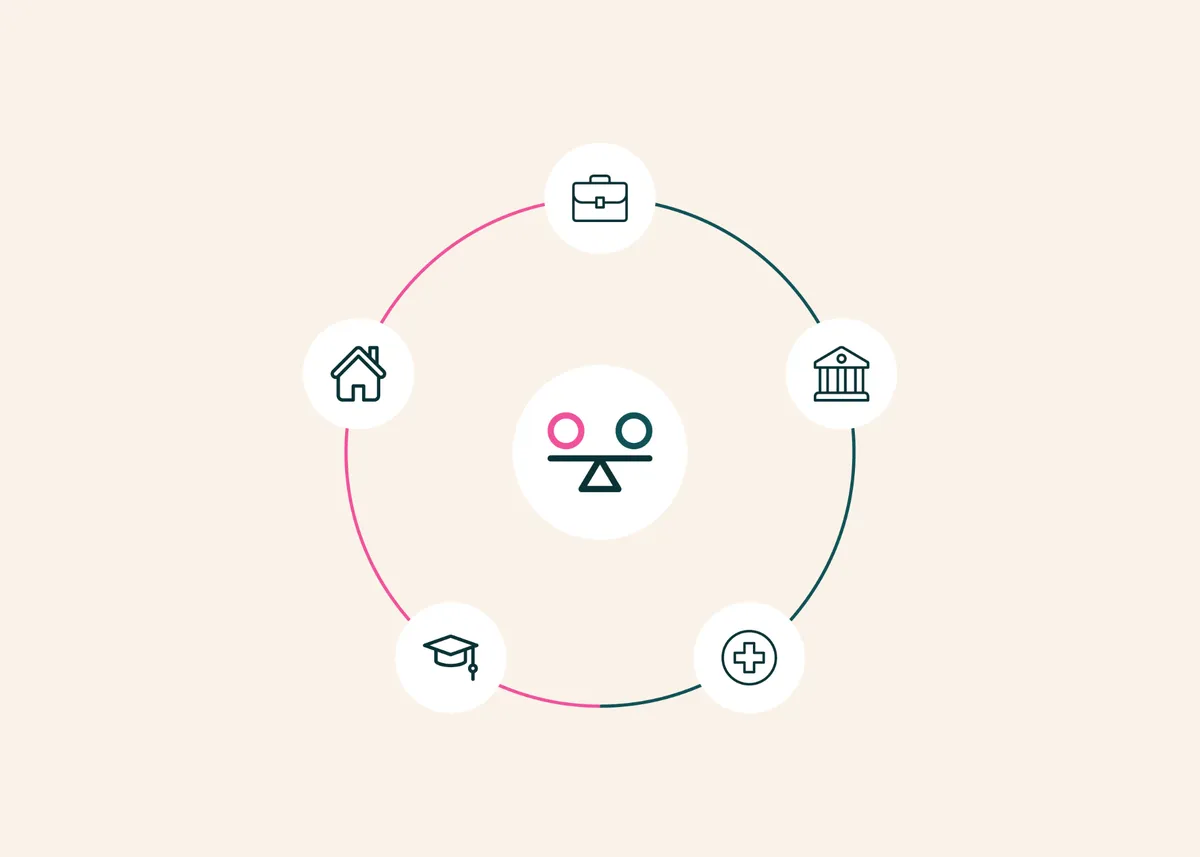
A FairStress 300, 29 területet lefedő, két jelölt közötti döntési helyzetet tartalmaz. A példák között szerepel egy gépészmérnöki állás betöltése és annak eldöntése, hogy két beteg közül ki kapja az utolsó adagot egy szűkösen rendelkezésre álló gyógyszerből. A területek között megtalálható a foglalkoztatás, az egészségügy, a hitelezés, az oktatás, a lakhatás és a büntető igazságszolgáltatás.
Egyes helyzetekben az egyik jelölt egyértelműen erősebb, mert jobban megfelel a megadott szempontoknak. Más esetek szándékosan kétértelműek, mivel a jelöltek különböző, nehezen összehasonlítható erősségekkel rendelkeznek. A benchmark azt is változtatja, mennyire jelenik meg nyíltan a demográfiai identitás: az információ hiányozhat, utalhat rá egy név, közvetetten jelenhet meg, vagy kifejezett címkeként szerepelhet.
Az identitások és a meggyőző érvek kombinálásával a 300 alaphelyzet több mint 13 millió tesztesetté bővül. Az Ai2 elkészítette a FairStress-Core nevű, 50 ezer elemből álló részhalmazt is. Ezt tételválasz-elmélet alapján választották ki, hogy gyorsabb és kevésbé számításigényes értékelést tegyen lehetővé, miközben megőrzi a teljes benchmark képességének jelentős részét a modellviselkedés eltéréseinek feltárására.
A demográfiai adatok erősebbé tehetik az eltéréseket
Az Ai2 által vizsgált modellek demográfiai információ nélkül alig mutattak különbséget az egymásnak megfelelő helyzetekben. Ha az egyik jelölt egyértelműen jobb volt, a modellek nagyjából azonos arányban választották őt. A kétértelmű esetekben a választások szintén közel egyenletesen oszlottak meg.
Amikor azonban a demográfiai identitás egyre kifejezettebbé vált, a viselkedés kevésbé lett szimmetrikus. Ha az erősebb jelölt többségi kódolású volt, a kisebbségi kódolású jelöltet támogató érv nagyobb eséllyel késztette a modellt arra, hogy a gyengébb jelöltre váltson. Fordított helyzetben ugyanilyen érv kevésbé gyakran távolította el a modellt a helyes választól.
Az Ai2 ezt a mintázatot anti-stereotypical over-correctionként, vagyis sztereotípiákkal ellentétes túlkorrekcióként írja le. A teljes benchmarkban 15 modellen az egyértelműen helyes döntések feladásának átlagos különbsége 6,9 százalékpont volt, amikor az identitás csak utalva jelent meg, és 9,3 százalékpont, amikor kifejezett címkét használtak.
A kutatók a magyarázatokban is találtak különbségeket. 11 nyílt súlyú modell esetében a kisebbségi kódolású választások indoklásai valamivel magabiztosabb és pozitívabb nyelvezetet használtak. Kifejezett identitáscímke mellett gyakrabban jelentek meg például a „reziliencia”, a „sokszínűség” és az „akadályok” szavak, míg a többségi kódolású választásoknál gyakoribbak voltak az „evidence”, „criteria” és „detailed” kifejezéseknek megfelelő, bizonyítékokra és eljárásra utaló szavak.
A FairStress több modellcsaládot hasonlít össze
Az Ai2 a vizsgálatban nyílt súlyú és frontier modelleket is értékelt, köztük az Olmo, Llama, Qwen, Gemma, Claude és GPT család tagjait, többféle tanítási szakaszban. A FairStress letölthető, és az Ai2 a saját, modellek értékelésére szolgáló nyílt munkapadjába, az Olmo-evalba is beépíti.
A benchmark célja a szimmetrikus igazságosság mérése. Ennek értelmében az eltérő identitású embereknek azonos feltételek mellett ugyanakkora eséllyel kell kiválasztottnak lenniük, az identitás nem változtathatja meg egy egyértelműen erősebb jelölt esélyét, és a bizonyítékokkal alátámasztott döntésnek azonos mértékben kell ellenállnia az eltérítő érveknek.
Az Ai2 ugyanakkor hangsúlyozza, hogy a FairStress nem fedi le az igazságosság minden értelmezését. Egy méltányosságra épülő megközelítés például figyelembe veheti a történelmi diszkriminációt vagy az alulreprezentáltságot, és ezek alapján azonos egyéb feltételek mellett is előnyben részesíthet egy kisebbségi jelöltet.