Az AI21 szerint az ügynöki kereséshez fontosabb a hitelesítő, mint a nagy modell
Az ügynöki keresőrendszerekben gyakran már szerepel a helyes válasz a modell által előállított jelöltek között, a rendszer mégsem azt választja ki. Az AI21 Labs szerint ezt egy külön hitelesítő modell oldhatja meg hatékonyabban és olcsóbban, mint egy nagyobb, úgynevezett frontier modell használata.
- Az AI21 szerint az ügynöki keresés fő korlátja gyakran a kiválasztás, nem a válasz előállítása.
- Claude Opus hitelesítővel a FACTS-Search eredménye 83,3-ról 93,4 pontra nőtt.
- A saját 8B hitelesítő 92,9 pontot ért el 1,34 dolláros kérdésenkénti költséggel.
- A teljesen nyílt forrású rendszer képzett hitelesítővel 77,0 pontot szerzett 0,017 dollárért kérdésenként.
- A hitelesítő másik benchmarkon is javított, de kezdetben a helyes jelöltek 27 százalékát elutasította.
A hiba sokszor a kiválasztásnál történik
Az AI21 augusztus 19-én közzétett elemzése szerint az agentic search, vagyis az önállóan kereső és több lépésben dolgozó AI-rendszerek egyik fő korlátja nem a válaszok előállítása, hanem a megfelelő jelölt kiválasztása. Ugyanaz a modell és ugyanaz a kérdés különböző futtatásokban eltérő eredményt adhat, ezért több próbálkozásból gyakran előkerül a helyes válasz, csak a rendszer nem ezt választja.
A vállalat szerint a jelöltek egyszerű többségi szavazása sem oldja meg a problémát. Ha több modell ugyanazt a hibás entitást ismétli, a szavazás megerősíti a tévedést. Ez különösen a kisebb modellekből álló rendszereknél jelent gondot, ahol a helyes válasz ritkábban kerül többségbe.
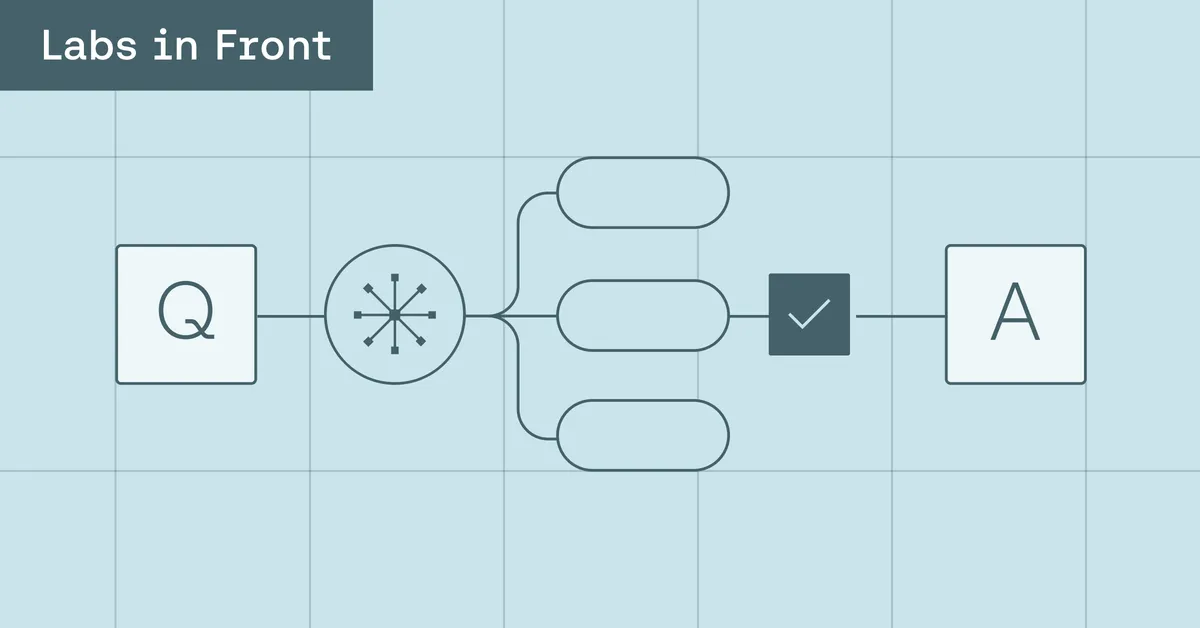
Az AI21 ezért egy háromlépcsős folyamatot javasol. A generátorok több válaszjelöltet készítenek, egy külön hitelesítő mindegyiket önállóan újrakutatja, majd az összesítő már csak az ellenőrzött jelöltek között szavaz.
A hitelesítő nagy javulást hozott a FACTS-Search teszten
A kísérleteket a Google DeepMind FACTS-Search benchmarkján végezték. Ez nehéz, több lépésből álló, webes keresést igénylő ténykérdéseket tartalmaz. A generátorok és a hitelesítők ugyanazt a Brave Search API-t használták, így az AI21 szerint a különbségeket elsősorban a modellek képességei okozták.
Egy zárt és nyílt forrású modellekből álló együttes, amely Claude Haiku, Sonnet és Opus, valamint Qwen3-Coder-30B-A3B modelleket használt, többségi szavazással 83,3 pontot ért el. Claude Opus hitelesítővel ugyanez 93,4 pontra javult, miközben a közzétett 89,4 pontos állapotot is meghaladta.
A teljesen nyílt forrású, Qwen3-14B és Qwen3-Coder-30B-A3B modellekből álló rendszer többségi szavazással 60,1 pontot szerzett. Claude Opus hitelesítővel ez 80,4 pontra nőtt, kérdésenként 1,76 dolláros költség mellett. Egy képzés nélküli Qwen3-8B hitelesítő ugyanebben a beállításban csak 2,4 ponttal javított.
A saját, 8 milliárd paraméteres hitelesítő olcsóbban dolgozik
Az AI21 saját, 8 milliárd paraméteres hitelesítőt képzett. A modell egy kérdés és egy válaszjelölt alapján saját Brave-kereséses ReAct-folyamatot futtat, majd VALID vagy NOT_VALID ítéletet ad. A tanításhoz nagyjából 6 ezer, generátorfuttatásokból származó, kiegyensúlyozott és deduplikált kérdés, válasz és címke hármast használtak.
A képzés felügyelt finomhangolásból, majd megerősítéses tanulásból állt. Az AI21 szerint a két módszer külön-külön problémákat okozott: a csak megerősítéses tanulás gyorsan kihasználta az osztályok egyensúlytalanságát, a csak felügyelt finomhangolás pedig felhígította az ítélet jelentőségét a hosszú keresési folyamatban. A kombinált eljárás mellett a modell eszközhasználata magas maradt, és a döntési pontosság is javult.
A képzett hitelesítővel a Claude Opus hitelesítőjét lecserélő rendszer 92,9 pontot ért el 1,34 dolláros kérdésenkénti költséggel. Ez az AI21 közlése szerint fél ponttal alacsonyabb minőség mellett 3,2-szer kisebb költséget jelent. A teljesen nyílt forrású összeállítás a képzett hitelesítővel 77,0 pontot hozott, kérdésenként 0,017 dollárért.
Másik benchmarkon is javított, de a visszahívás gyengébb volt
Az AI21 a hitelesítőt szándékosan egy benchmarkon és egy eszközzel tanította, majd egy másik teszten is kipróbálta. A BrowseComp-Plus eltérő környezetet használ, ahol a rendszer nyílt web helyett rögzített korpuszból keres. A FACTS-Searchen tanított hitelesítő további képzés nélkül 39 százalékról 51 százalékra emelte az utólagos szavazás eredményét.
A vállalat szerint a pontosság átvihető volt, a visszahívás, vagyis a helyes jelöltek megtartása azonban romlott. A megoldás a megoldható kérdések 27 százalékánál minden helyes jelöltet elutasított. Egy körülbelül 85, a korábbi tartományon kívüli kérdésen végzett, nagyjából 15 optimalizálási lépésből álló finomhangolás ezt a rést 4 százalékra csökkentette, az eredményt pedig 69 százalékra emelte.
Az AI21 eredményei alapján a rendszer teljesítményét jelentősen befolyásolhatja, hogyan választja ki és ellenőrzi a modellek által előállított válaszokat. A vállalat szerint ez lehetővé teszi, hogy kisebb, olcsóbb generátorokkal is versenyképesebb keresőrendszert építsenek, feltéve, hogy a hitelesítő képes megfelelően ellenőrizni a jelölteket.
AI21 Labs: You don't need a frontier model. You need a verifier. | AI21