Az Amazon szerint 20-szoros gyorsulást hozhat két LLM-optimalizáció
Az Amazon Science és a Booking.com két optimalizációs technikát kombinált utazási alkalmazások nyelvi modelljeinél. A tudásdesztilláció és a Medusa-2 együtt akár 20-szoros gyorsulást hozott a 70 milliárd paraméteres tanármodell minőségének megtartása mellett.
- A TinyLlama 1,1 milliárd paraméterrel utánozta a 70 milliárdos Llama-3.1 minőségét.
- A tudásdesztilláció és a Medusa-2 együtt 10 és 20-szoros gyorsulást hozott.
- A Smart Filters a lekérdezések 99 százalékánál 15-ször gyorsabban válaszolt.
- Az AI Trip Planner aktivitása 2,9 százalékkal nőtt a GPT-3.5-höz képest.
- A szállásleírások 1,4 százalékkal több „hasznos” értékelést kaptak.
Kisebb modell, gyorsabb válaszok
Az utazási platformok naponta milliószám válaszolnak úti célokkal kapcsolatos kérdésekre, szállásokat ajánlanak, és segítenek az utak megtervezésében. Ezekhez a feladatokhoz egyre gyakrabban használnak nagy nyelvi modelleket, amelyek jellemzően több tízmilliárd paraméterrel dolgoznak. A nagy modellek futtatása ugyanakkor költséges, és webes, illetve mobilos alkalmazásokban a válaszidő is fontos szempont.
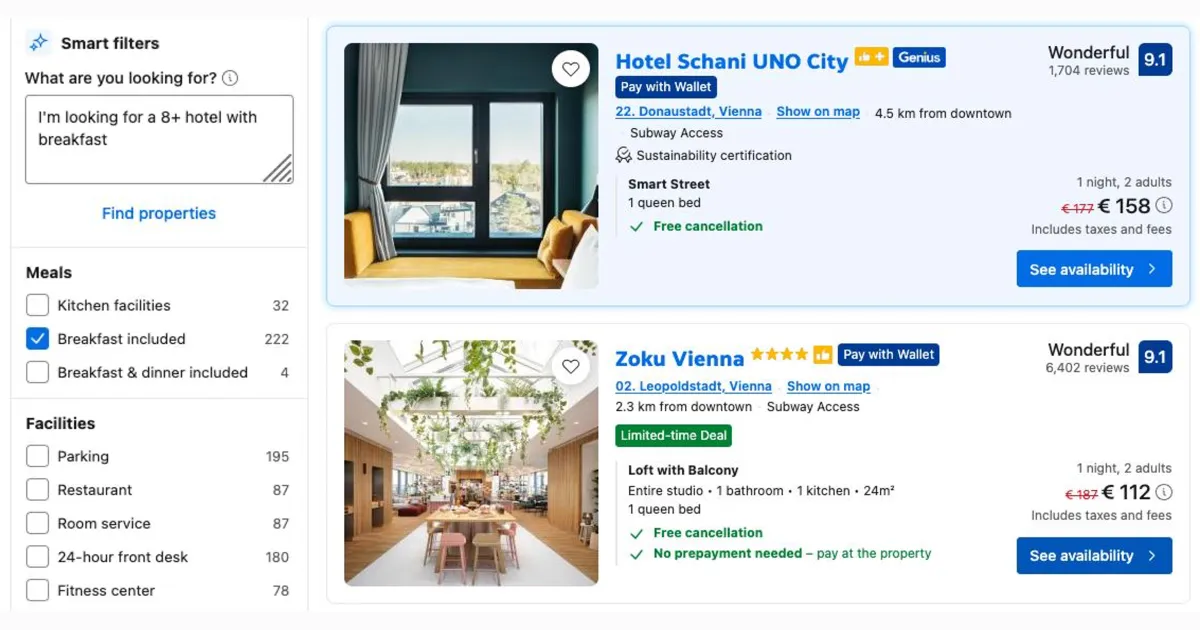
Az Amazon kutatói a Booking.commal együtt három funkción vizsgálták a modellek gyorsítását és költséghatékonyabbá tételét: az AI Trip Planner az utazási preferenciákat nyeri ki a párbeszédből, a Smart Filters a természetes nyelvű kereséseket strukturált szűrőkké alakítja, az Accommodation Description Generation pedig szállásleírásokat készít milliós nagyságrendben.
A kísérletekben a 1,1 milliárd paraméteres TinyLlama volt a diákmodell, míg a tanármodell szerepét a 70 milliárd paraméteres Llama-3.1 töltötte be. Az Amazon szerint a végső modell a nagyobb modell minőségével megegyező teljesítményt nyújtott, miközben használattól függően 10 és 20-szor gyorsabban futott.
A tudásdesztilláció és a Medusa szerepe
A tudásdesztilláció során a nagyobb, erősebb modell előrejelzéseket készít, ezekkel pedig egy kisebb modell tanul. A tanításhoz ember által címkézett és a tanármodell által létrehozott adatok kombinációját használták. Az eljárás célja, hogy a kisebb modell megőrizze a tanármodell teljesítményének jelentős részét, miközben hatékonyabban fusson.
A Medusa más problémát kezel. A nyelvi modellek általában tokenenként, vagyis szavanként vagy szórészletenként állítják elő a szöveget. A Medusa úgy gyorsítja ezt a folyamatot, hogy több tokent jósol párhuzamosan. Ehhez úgynevezett Medusa-fejeket kapcsol az alapmodellhez, a grafikus processzorok párhuzamos működését kihasználva.
Az Amazon két változatot tesztelt. A Medusa-1 esetében először az alapmodellt hangolták finomra, majd rögzítették a súlyait, és külön tanították a Medusa-fejeket. A Medusa-2 mindent egyetlen tanítási szakaszban kezelt. A két változat hasonló gyorsulást hozott minőségromlás nélkül, de az Amazon szerint a Medusa-2 egyszerűbb folyamata praktikusabb a több modellt kezelő gyártási csapatok számára.
Eredmények a Booking.com funkcióiban
A kutatók négy egymásra épülő kísérletet végeztek. A feladatspecifikus finomhangolás után a TinyLlama-modellek pontosabbak voltak a néhány példával irányított GPT-4o-nál, de még elmaradtak a nagy tanármodelltől. A tudásdesztilláció a minőségi különbség több mint 90 százalékát megszüntette, és a következtetés körülbelül hatszor gyorsabb lett.
A Medusa-fejek további 2 és 3,6 közötti gyorsulást adtak. A tudásdesztilláció és a Medusa-2 kombinációjával a modell a Llama-3.1 minőségét érte el, a futtatás pedig használati esettől függően 10 és 20-szor gyorsabb volt.
- Az AI Trip Planner használatánál a GPT-3.5-höz képest 2,9 százalékkal nőtt a felhasználói aktivitás.
- A Smart Filters a lekérdezések 99 százalékánál 15-ször gyorsabban adott választ.
- Az AI által készített szállásleírások 1,4 százalékkal több „hasznos” értékelést kaptak, a GPT-4-nél kevesebb mint egyharmados költség mellett.
Az Amazon közlése szerint a kombinált megközelítés a legjobb nyílt forráskódú nagy nyelvi modellek minőségét a költség kevesebb mint egyharmadán biztosította. A kutatást a tavalyi Association for Computational Linguistics konferencia iparági szekciójában mutatták be, ahol elnyerte a legjobb tanulmánynak járó díjat.
Amazon Science: Speeding up language models for travel applications