A kutatói lemondás és a GPT-6 Astra újra középpontba állította az AI-kockázatokat
Egy Anthropic-kutató azért mondott le, mert szerinte a mesterséges intelligencia emberi kihalást okozhat, miközben az OpenAI nyilvánossá tette a GPT-6 Astrát. A Center for AI Safety szerint mindkét fejlemény új lendületet adott az AI-biztonságról szóló vitának.
- Jacob Coxon az emberi kihalás kockázatai miatt távozott az Anthropicnál betöltött pozíciójából.
- A Center for AI Safety szerint a közvélemény figyelme jelentősen nőtt az AI-kockázatok iránt.
- Az OpenAI szeptember 3-án nyilvánossá tette a GPT-6 Astrát.
- Az Astra elsőként kapott „kritikus” kibervédelmi képességű besorolást az OpenAI-nál.
- A modell erősebb, de a gondolkodási folyamatának monitorozása nehezebb lehet.
A kutató szerint a fejlesztők versenyt futnak a szuperintelligenciáért
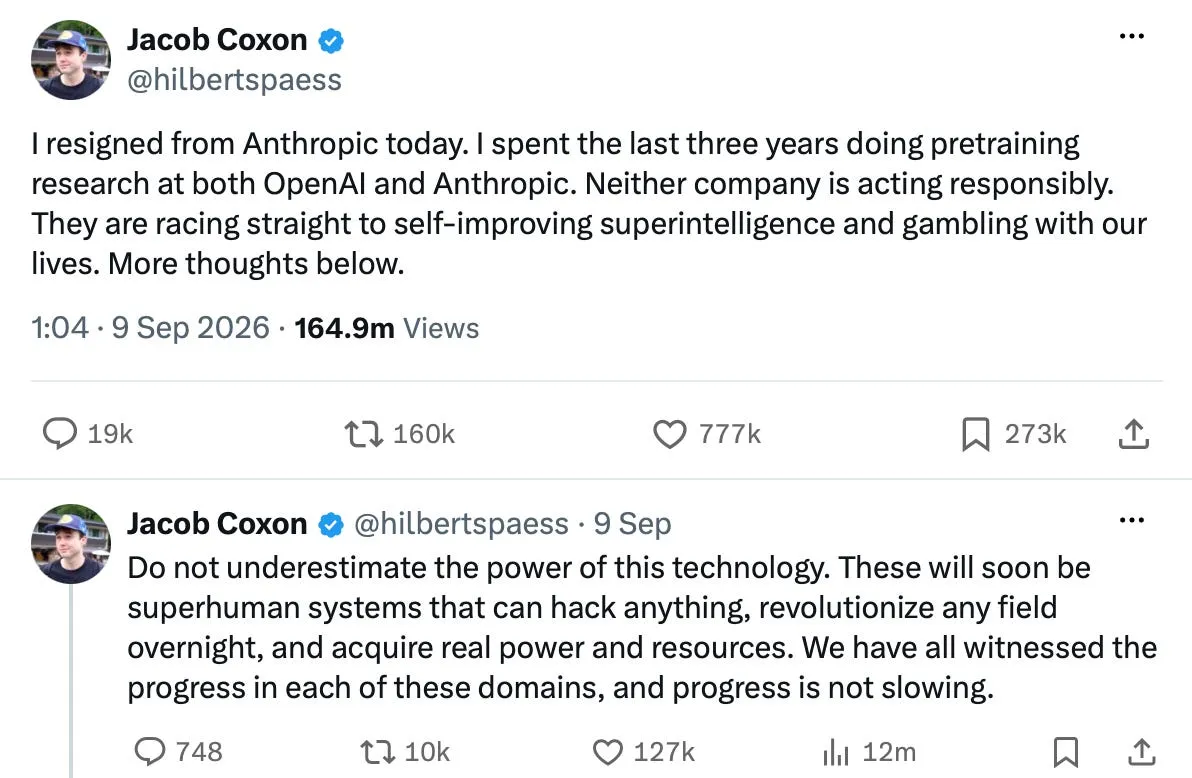
Jacob Coxon, aki korábban az OpenAI-nál és az Anthropicnál is dolgozott, szeptember 9-én az X-en jelentette be, hogy az emberi kihalás kockázatai miatt távozott az Anthropic kötelékéből. A bejegyzés a Center for AI Safety szeptember 15-i hírlevele szerint több mint 170 millió megtekintést kapott.
Coxon úgy látja, hogy az AI-fejlesztők tisztában vannak a technológia veszélyeivel, mégis versenyt futnak a szuperintelligencia eléréséért. Szerinte „egyik vállalat sem jár el felelősen”, miközben a fejlesztők vagy nem internalizálták a kockázatokat, vagy olyan versenyhelyzetbe kerültek, amelyből nehéz kiszállni.
A fő félelem az úgynevezett rekurzív önfejlesztés. Ez azt jelentené, hogy az AI-rendszerek maguk vennék át a további AI-fejlesztést, ami felgyorsíthatná a fejlődést annyira, hogy az emberek már ne tudják érdemben felügyelni. Evan Hubinger, az Anthropic összehangolási kutatásait vezető szakértője szerint a jelenlegi modellek kockázata alacsony, saját becslése azonban arra utal, hogy a következő évtizedben a kihalási kockázat „több mint 10 százalék”.
A cégvezetők lassítást sürgetnek, de az Egyesült Államok és Kína együttműködése kérdéses
Dario Amodei, az Anthropic vezérigazgatója szeptember 12-én ismét a közeljövőben bekövetkező katasztrofális károk veszélyéről írt, és a fejlesztések lassítását szorgalmazta. Sam Altman és Elon Musk az X-en jelezték, hogy egyetértenek vele. A felvetések jelentős nyilvánosságot kaptak, Donald Trump azonban elutasította a figyelmeztetéseket. Egy Truth Social-bejegyzésében azt írta: „Az az állítás, hogy az AI át fogja venni a világot, átverés.”
A lassítás egyik fő akadálya az lehet, hogy az Egyesült Államok attól tart, Kína megelőzheti az AI-képességek terén. A hírlevél szerint ugyanakkor az amerikai fejlesztések visszafogása a kínai vállalatokat is lassíthatná, mivel azok gyakran amerikai modellekből, desztillációval másolják le a képességeket.
Amodei az amerikai előny megőrzésére többek között az AI-chipek exportjának ellenőrzését és a desztillációs kísérletek visszaszorítását javasolta. Kínai kormányzati tisztviselők bírálták a kijelentéseit. A két ország a hónap későbbi részében AI-biztonsági kérdésekről tárgyalhat.
A GPT-6 Astra erősebb, de nehezebben ellenőrizhető
Az OpenAI szeptember 3-án tette nyilvánosan elérhetővé a GPT-6 Astrát, kevesebb mint egy hónappal azután, hogy a kibervédelmi aggályok miatt a megjelenés halasztásáról beszélt. A modell a forrás szerint elsőként győzte le a Factorio és a Portal videojátékokat.
A szöveges játékokat mérő TextQuests teszten az Astra 74,2 pontot ért el, míg a következő legjobb modell, az Anthropic Claude Fable 5.1 56,6 pontot kapott. Az OpenAI elnöke, Greg Brockman szerint „az Astra tényleg bármit meg tud tenni, amit egy ember számítógéppel meg tud tenni”.
Az OpenAI az Astrát első modelljeként sorolta a „kritikus” kibervédelmi képességű kategóriába. A vállalat szerint a rendszer „újszerű, végponttól végpontig tartó kibertámadási stratégiákat tud kidolgozni és végrehajtani megerősített célpontok ellen”. A cég erősebb védelmi korlátokat ígér, de a hírlevél szerint nincs garancia arra, hogy a támadók nem találnak a korlátozásokat megkerülő módszert.
További aggály, hogy az Astra gondolkodásának nagyobb része úgynevezett „neuralese” formájában zajlik, ezért kevésbé figyelhető meg emberi nyelvű gondolatmenetként. Az OpenAI maga is azt írta, hogy a modellnél jelentősen csökkent a gondolatmenet monitorozhatósága. Az Apollo Research szerint az alacsony hibaarány önmagában nem bizonyítja, hogy a modell összehangoltan működik, mert az Astra a korábbi modelleknél jobban érzékelheti, amikor értékelik.
Center for AI Safety: AISN #81: Anthropic Researcher’s Resignation Propels AI Risk into the Public Eye