Az Arize Alyx ügynöke egyetlen fájlban tárolja a hosszú távú memóriát
Az Arize AI az Alyx AI-mérnöki ügynök hosszú távú memóriáját egyetlen, strukturált szövegfájlra építette fel felhasználónként és Arize space-enként. A vállalat szerint az egyszerűbb megoldás elég lehet a szűk feladatra szabott ügynököknek, miközben olcsóbban és könnyebben tesztelhető.
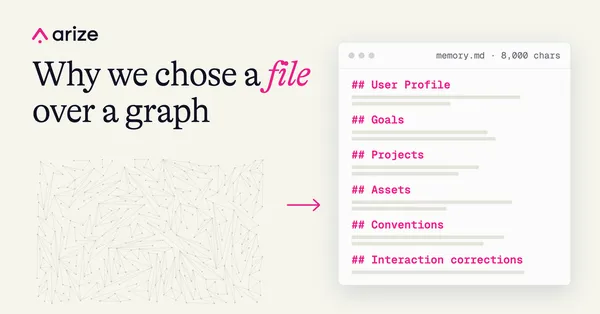
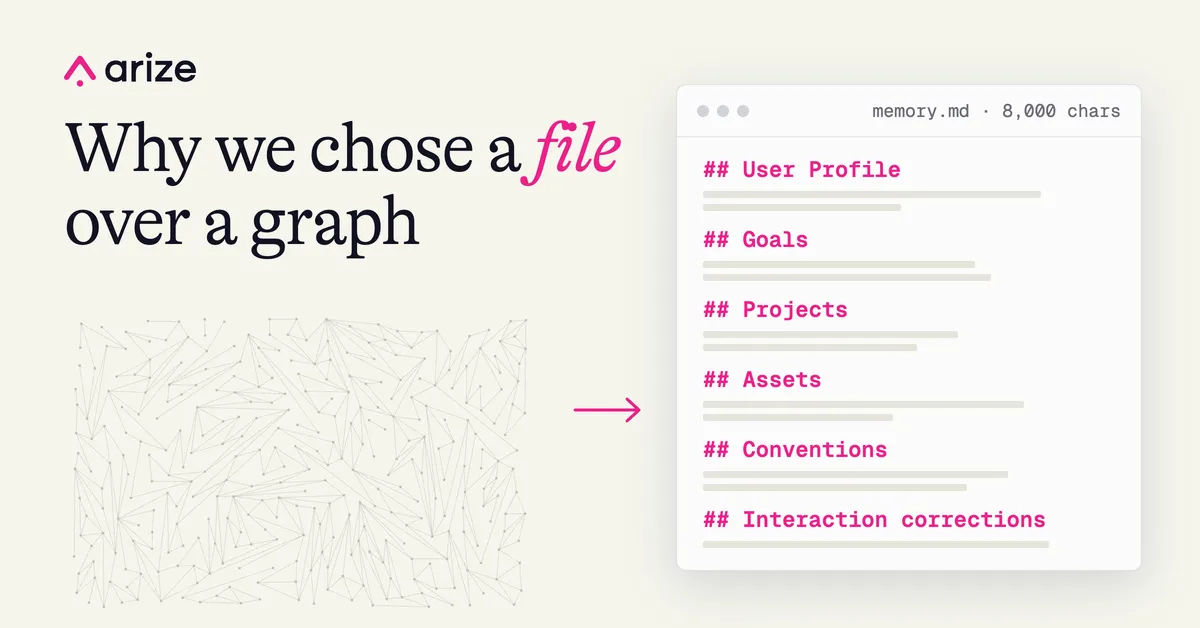
- Az Alyx felhasználónként és Arize space-enként egy, legfeljebb 8000 karakteres memóriafájlt használ.
- Az Arize elvetette a kezdeti vektoros és tudásgráfos architektúrát.
- A háttérfolyamatok összefoglalják a beszélgetéseket és módosításokat javasolnak.
- A végső teszteken az Alyx 18 memóriafüggő kérdésből 16-ra válaszolt helyesen.
- Az Arize szerint a módszer szűk feladatra szabott ügynököknél lehet megfelelő.
A bonyolult architektúrától az egyetlen fájlig
Az Arize AI október 1-jén ismertette, hogyan építette ki az Alyx hosszú távú memóriáját. A fejlesztés kezdetén vektoros visszakeresést, külön epizodikus és szemantikus tárakat, valamint időbeli tudásgráfot használtak. A végleges rendszer ennél jóval kisebb lett.
Az Alyx minden felhasználóhoz és minden általuk használt Arize space-hez egy strukturált szövegfájlt kezel. A fájl legfeljebb 8000 karakteres lehet, és az ügynök minden kérésnél a teljes tartalmát beolvassa. A háttérfolyamatok összefoglalják a lezárt beszélgetési fordulókat, majd célzott módosításokat javasolnak a memórián.
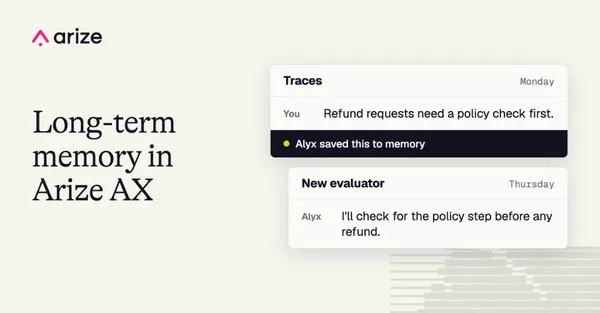
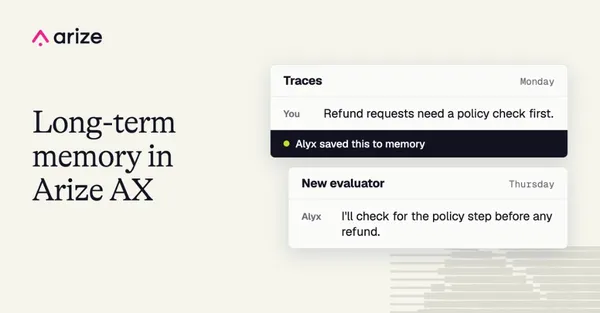
A vállalat szerint a hosszú távú memória olyan tartós információkat őrizhet, mint a felhasználói beállítások, a projektek szabályai, a korábbi döntések indokai és az ügynök korábbi hibáinak javításai.
Miért bizonyult drágának a tudásgráf?
Az első Alyx-prototípus a memóriát visszakeresési problémaként kezelte. A rendszer felhasználókat, projekteket, eszközöket, célokat és termékterületeket modellezett gráfentitásokként, majd minden kéréshez releváns emlékeket keresett.
Az Arize tapasztalata szerint ez több nehézséget okozott. A szélesebb érvényű beállításokat könnyű volt kihagyni, ha az aktuális kérdés szövege nem hasonlított hozzájuk. Egy adathalmaz létrehozására vonatkozó kérdés például nem feltétlenül hívja elő azt a szabályt, hogy a felhasználó pontosan 70 soros adathalmazokat szeretne.
A tudásgráf karbantartása közben minden írás több nyelvimodell-hívást igényelhet. Az Arize példája szerint egy öt entitást és hat tényt tartalmazó forduló nagyjából 10 hívást jelenthet egyedi típusok nélkül, és 20-nál is többet egyedi típusokkal. Erre a költségre és késleltetésre minden fordulónál, minden felhasználónál szükség lehet.
A fájl egyszerűbb, de a hibákra figyelni kell
Az egyetlen, mindig betöltött memóriafájl megszünteti a memóriakeresést az olvasási folyamatban. A feladat ettől nem tűnik el: továbbra is el kell dönteni, mit érdemes megőrizni, mikor kell alkalmazni, és hogyan lehet a tartalmat a méretkorláton belül tartani.
A tömörítés segít a fájl méretének korlátozásában, de az Arize egyik tapasztalata szerint egy elutasított frissítés miatt a legutóbbi információk nem mindig kerülnek mentésre. A fejlesztők azt is vizsgálták, hogy a memória javítja-e a válaszokat, vagy bizonyos esetekben ront rajtuk.
A végső teszteken az Alyx 18 memóriát igénylő kérdésből 16-ra válaszolt helyesen. Ezt három külön forgatókönyvben és egy olyan vegyes futásban is vizsgálták, amely összekeverte ezeket. Azokat a kérdéseket is tesztelték, amelyeknél a memória félrevezető lehetett, és az ügynök ebben a második csoportban minden kérdésen megfelelt.
Az Arize szerint az Alyx megközelítése közel áll ahhoz, ahogyan az OpenAI és az Anthropic a ChatGPT, illetve a Claude memóriáját kezeli: egy tömör profil közvetlenül a modell kontextusába kerül, a ritkábban szükséges információkhoz pedig keresést használnak. A vállalat következtetése szerint egy jól strukturált, mindig betöltött fájl sok szűk feladatra szabott ügynöknél megfelelő alapértelmezés lehet.