Bővül az Azure Content Understanding GPT-5 modellkínálata
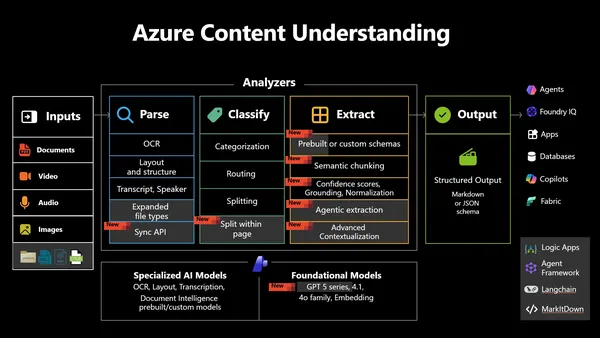
Az Azure Content Understanding már a GPT-5, GPT-5.1, GPT-5.2, GPT-5.4 és GPT-5.5 sorozat standard, mini és nano modelljeit is támogatja dokumentumok, képek, videók és beszéd elemzésére. A Microsoft emellett új grounding- és bizalmi pontozási módszert vezetett be, amely saját tesztjei szerint alacsonyabb költséget és pontosabb eredményeket hoz.
- Az Azure Content Understanding támogatja a GPT-5 sorozat standard, mini és nano modelljeit.
- Az új grounding rendszer akár 28 százalékkal csökkentette a teljes következtetési tokenfelhasználást.
- A GPT-5.1 és a GPT-5.2 kiegyensúlyozott választás dokumentumokhoz és beszédelemzéshez.
- Videónál a GPT-5 érte el a tesztben a legmagasabb, 89,0 százalékos Generation F1 értéket.
- A Microsoft nem javasolja a GPT-5 Mini és GPT-5 Nano használatát bizalomérzékeny munkafolyamatokban.
Több GPT-5 modell közül választhatnak a vállalatok
A Microsoft Foundry augusztus 12-i bejegyzése szerint az Azure Content Understanding új modellkatalógusa azt célozza, hogy a szervezetek az egyes feladatokhoz megfelelő szintű intelligenciát választhassák. A rendszer dokumentumokból, képekből, hanganyagokból és videókból nyer ki információt, amelyre később automatizált műveletek épülhetnek.
A bővítés a GPT-5, GPT-5.1, GPT-5.2, GPT-5.4 és GPT-5.5 modellekre terjed ki, standard, mini és nano változatokkal. A Microsoft szerint minden modellhez optimalizált feldolgozási folyamat tartozik. Az előfeldolgozás nagyobb fájlok kezelését és jobb minőségű eredményeket tesz lehetővé az egyszerű, nagy nyelvi modellre épülő dokumentumfolyamatokhoz képest.
A vállalat szerint a megoldás az idősebb alapmodellek kivezetésekor is átjárást biztosít az újabb modellgenerációkra, így az ügyfeleknek nem kell újratervezniük a Content Understanding munkafolyamatait.
Akár 28 százalékkal kevesebb token
Az új grounding rendszer hatékonyabban azonosítja a kinyert adatok forrását. A Microsoft tesztjeiben modellenként 20 és 30 százalék közötti csökkenést mértek a bemeneti tokenek, valamint 18 és 28 százalék közötti csökkenést a dokumentumonkénti teljes következtetési tokenek számában.
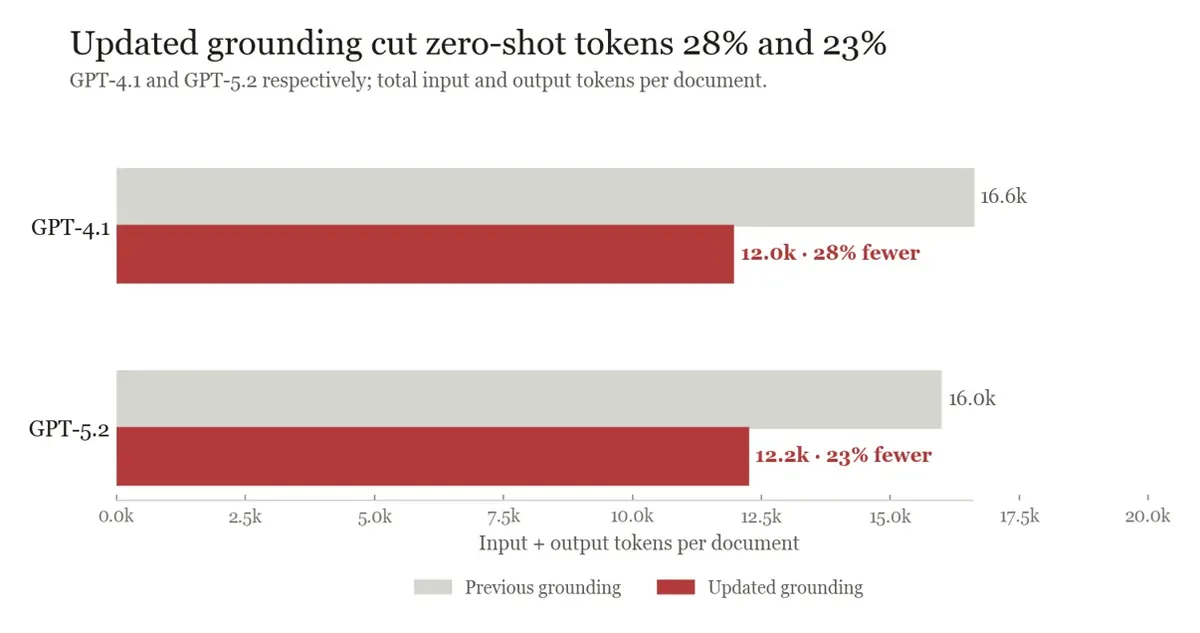
A GPT-4.1 esetében a nulla példás következtetés tokenigénye 28 százalékkal, a GPT-5.2-nél 23 százalékkal mérséklődött. A tesztelt modell- és címkézettmintás konfigurációkban ez 11 és 25 százalék közötti csökkenést jelentett a teljes következtetési nagy nyelvi modellköltségben, miközben a P50 és P95 késleltetés is csökkent. A grounding pontossága a korábbi módszerhez hasonló maradt.
A kiadás egészét vizsgálva a Microsoft legfeljebb 28 százalékkal kevesebb teljes következtetési tokenről, legfeljebb 25 százalékkal alacsonyabb teljes következtetési költségről, valamint a bizalmi pontszámok pontosságának legfeljebb 14 százalékos javulásáról számolt be. A grounding pontossága legfeljebb 3 százalékkal javult.
Modellválasztási ajánlások feladattípusonként
Dokumentumokhoz és beszédelemzéshez a Microsoft kiegyensúlyozott kiindulópontként a GPT-5.1-et vagy a GPT-5.2-t ajánlja. A GPT-5.5 körülbelül 2 százalékkal jobb minőséget ad a GPT-5.2-nél, becsült költsége azonban nagyjából 101 százalékkal magasabb. A GPT-5.4 Mini körülbelül 50 százalékkal olcsóbb, átlagosan 2 százalékponttal alacsonyabb Answer Match eredménnyel.
Videónál a GPT-5 és a GPT-5.1 számít kiegyensúlyozott választásnak. A tesztben a GPT-5 89,0 százalékos, a GPT-5.1 88,6 százalékos, a GPT-5.4 pedig 87,5 százalékos Generation F1 értéket ért el. A GPT-5 Mini körülbelül 28 százalékkal került kevesebbe a GPT-5-nél, miközben az összesített Generation F1 nagyjából 7 százalékkal alacsonyabb volt.
Képeknél a feladattípus számít. A Microsoft a GPT-5.1-et javasolja kiegyensúlyozott választásként. A GPT-5.5 generálási feladatokban körülbelül 3 százalékkal jobb minőséget adott, költsége viszont mintegy 130 százalékkal magasabb volt. Osztályozásnál a GPT-5 Mini körülbelül 52 százalékkal olcsóbb a GPT-5.1-nél, de körülbelül 12 százalékkal alacsonyabb Classify F1 értéket ad.
A bizalmi pontszámokra külön figyelmeztet a Microsoft
Az új bizalmi pontozási módszer szélesebb modellkörön alkalmazható. AUROC alapján a pontszámok megbízhatósága a GPT-4.1-nél körülbelül 9, a GPT-5.2-nél 14 százalékkal javult a korábbi módszerhez képest.
A Microsoft ugyanakkor jelentős minőségromlást tapasztalt a GPT-5 Mini és a GPT-5 Nano bizalmi modelljénél. Ezeket ezért nem ajánlja olyan munkafolyamatokhoz, amelyekben fontos a bizalmi pontszámok minősége. A vállalat szerint az elfogadási küszöböket mezőnként kell beállítani, és minden modellváltáskor újra kell kalibrálni.
A közzétett mérési eredmények nem feltétlenül reprezentálják minden éles munkafolyamat eredményeit. A Microsoft arra ösztönzi az ügyfeleket, hogy a javasolt modellekből állítsanak össze egy rövid listát, majd saját adataikon, költségkeretük, minőségi elvárásaik, régiós elérhetőségük és áteresztőképességi céljaik alapján válasszanak.