160 szakértő vitatta meg az AI-biztonság jövőjét Santa Cruzban
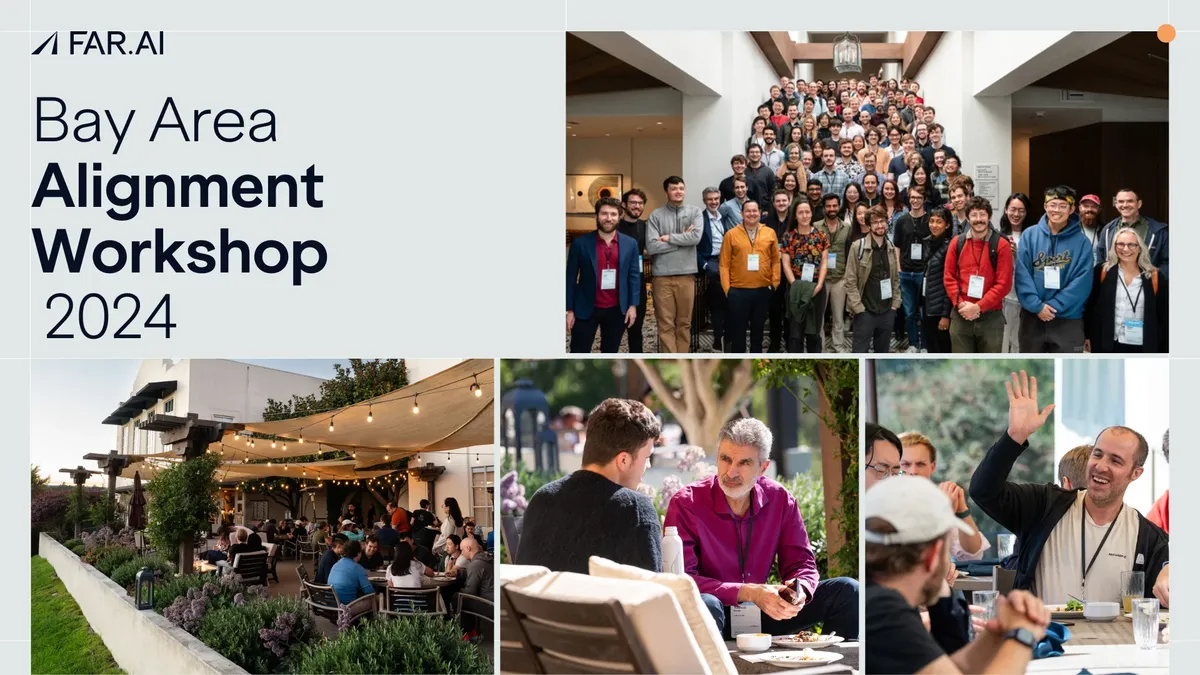
160 kutató és vezető találkozott a Bay Area Alignment Workshopon, hogy az AI-rendszerek biztonságáról és társadalmi értékekhez való igazításáról egyeztessen. A kétnapos eseményen az értékelés, a robusztusság, az értelmezhetőség és az irányítás kérdései kerültek középpontba.
- 160 szakértő vett részt a 2024. október 24én és 25én rendezett workshopon.
- A fő témák között az AI értékelése, robusztussága, értelmezhetősége és irányítása szerepelt.
- Az előadók a modellmanipuláció, a megtévesztés és az össze nem hangolt célok kockázatait vizsgálták.
- A résztvevők nyílt értékeléseket és harmadik fél által végzett tesztelést is támogattak.
- A FAR.AI elérhetővé tette a teljes előadások felvételeit.
Kutatók és döntéshozók vitatták meg az AI kockázatait
A FAR.AI beszámolója szerint a workshopot 2024. október 24én és 25én rendezték meg Santa Cruzban. Az eseményen az akadémiai szféra, az ipar, a kormányzat és nonprofit szervezetek 160 kutatója és vezetője vett részt.
A találkozó célja az volt, hogy a résztvevők az AI jövőjét a biztonság és a társadalmi értékekkel való összehangolás irányába tereljék. Több párhuzamos szekció és rövid előadás adott lehetőséget arra, hogy a résztvevők részletesen tárgyalják a fejlett AI-rendszerek kockázatait és a lehetséges védelmi módszereket.
Az esti nyílt beszélgetések között szó esett arról, hogy elegendőek e a jelenlegi biztonsági intézkedések, valamint külön beszélgetést szenteltek az SB 1047 törvény utólagos értékelésének.
Értékelés, felügyelet és értelmezhetőség
Anca Dragan, a Google DeepMind AI biztonságért és összehangolásért felelős igazgatója a hibás jutalmazási modellekből fakadó, össze nem hangolt célok kockázatáról beszélt. Szerinte a mesterséges intelligencia teljesítményének növekedésével egyre fontosabbá válik a robusztus fenyegetésmodellezés.
Beth Barnes, a METR munkatársa, szigorú értékelési módszereket sürgetett, amelyek a fejlett AI kockázatait mérik és előre jelezhetik. Az értékelések nyílt forrásúvá tételét is támogatta, mert ez szerinte növelheti az átláthatóságot és az együttműködést a vezető modellfejlesztők között.
Buck Shlegeris a megbízható megfigyelésről, az összejátszás felismeréséről és az ellenséges tesztelésről beszélt. Julian Michael a vitára épülő felügyeletet vizsgálta, amelyben az AI-rendszerek strukturált érvelése segítheti az embereket összetett, nagy tétű feladatok értékelésében.
Az értelmezhetőség témájában Atticus Geiger a modellek működésének ember számára érthető algoritmusokhoz való kapcsolását szorgalmazta. Andy Zou pedig felülről lefelé haladó megközelítést mutatott be, amely a teljes modell viselkedésére összpontosít az egyes neuronok helyett.
Robusztusság és szabályozás a középpontban
A robusztusságról szóló előadások a modellek sérülékenységeit és a tesztelés korlátait vizsgálták. Stephen Casper harmadik fél által végzett értékeléseket sürgetett, és arról beszélt, hogy a modellmanipulációs támadások olyan problémákat is feltárhatnak, amelyeket a szokásos tesztek nem mutatnak ki. Alex Wei szerint a válaszadás előtti érvelés segíthet az ellenséges támadások és a kijátszási kísérletek kivédésében.
Adam Gleave azt vizsgálta, hogy a modellek egyszerű méretnövelése önmagában javítja e a robusztusságot. Előadásában az ellenséges tanítás korlátairól és a hatékonyabb biztonsági megoldások szükségességéről beszélt.
A kormányzati és biztonsági szekcióban az Egyesült Államok, az Egyesült Királyság, az Európai Unió és Kína AI politikájáról is szó esett. Kwan Yee Ng Kína kötelező biztonsági szabályozását és a Pekingben, illetve Sanghajban működő regionális kísérleti programokat ismertette. A beszámoló szerint Kína az AI biztonságát nemzetbiztonsági és közbiztonsági kérdésként kezeli.
A résztvevők további együttműködést sürgettek
A második napon a rövid előadások az irányítás, az értékelés és a magasabb szintű biztonsági kérdések felé fordultak. Dawn Song a felelős AI fejlesztés társadalmi és technikai megközelítését hangsúlyozta, Shayne Longpre pedig az AI értékelését és a vörös csapatos tesztelést támogató biztonságos jogi keret ötletét mutatta be.
A FAR.AI szerint a workshop erősítette az AI biztonságával foglalkozó közösség együttműködését. A szervezet a teljes előadássorozat felvételeit a weboldalán és YouTube csatornáján tette elérhetővé, a jövőbeli Alignment Workshopok iránt érdeklődők pedig regisztrálhatják érdeklődésüket.
A rendezvény témái azt mutatják, hogy a résztvevők a biztonságot több oldalról közelítik meg. A modellek tesztelése, működésük értelmezése, a manipuláció felismerése és a kormányzati szabályozás egyaránt része annak a munkának, amelyet a FAR.AI szerint a fejlett AI-rendszerek társadalmi értékekhez igazítása igényel.
FAR.AI: Bay Area Alignment Workshop 2024 | FAR.AI