Bécsben vitatták meg az AI-biztonság legfontosabb kérdéseit
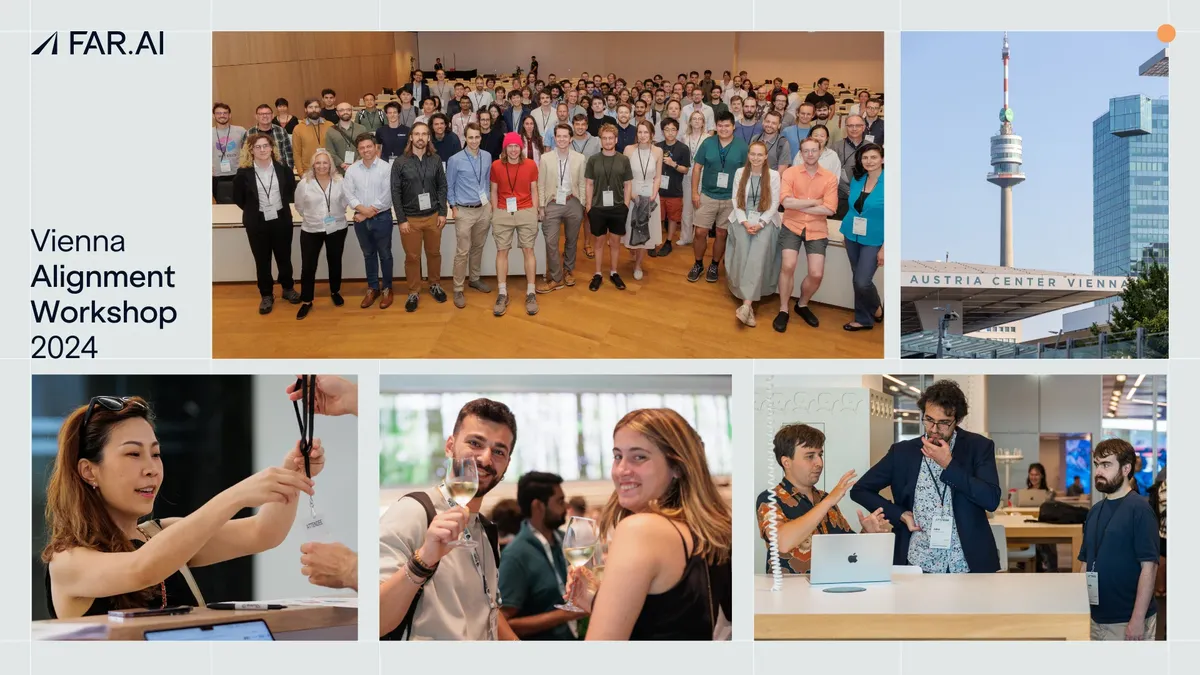
Az AI-biztonság legfontosabb kutatási és szabályozási kérdéseit vitatták meg a Vienna Alignment Workshop résztvevői. A bécsi eseményen 129 kutató és szakértő vett részt, majd további találkozók folytatták a szakmai eszmecserét.
- A Vienna Alignment Workshopon 129 résztvevő és 11 meghívott előadó vett részt.
- A program az AI-biztonság, az értelmezhetőség, az irányítás és a veszélyes képességek kérdéseire összpontosított.
- A panel résztvevői szerint a technikai megközelítést gazdasági, jogi és társadalmi szempontokkal kell kiegészíteni.
- Jan Leike a nehéz feladatokat végző AI-rendszerek skálázható felügyeletéről beszélt.
- Az eseményt Open Social találkozó és Unconference program követte.
Széles körű szakmai találkozó Bécsben
A FAR.AI beszámolója szerint a Vienna Alignment Workshopot 2024. július 21-én rendezték meg, közvetlenül az International Conference on Machine Learning, vagyis az ICML előtt. Az eseményen akadémiai, iparági, kormányzati és nonprofit szervezetek szakértői találkoztak.
A workshop középpontjában az állt, hogyan lehet biztosítani, hogy a fejlett mesterségesintelligencia-rendszerek összhangban maradjanak az emberi értékekkel. A program a garantáltan biztonságos AI, a robusztusság, az értelmezhetőség, az irányítás, a veszélyes képességek értékelése és a skálázható felügyelet kérdéseivel foglalkozott.
A rendezvényen 11 meghívott előadó és 12 rövid előadás szerepelt. A workshopot követő Open Social eseményen körülbelül 250 kutató találkozott, a hétfői Unconference programhoz pedig csaknem 100 résztvevő csatlakozott. Utóbbin 18 rövid előadás, öt tematikus ülés és kötetlen szakmai kapcsolatépítés kapott helyet.
A technikai megoldások mellett társadalmi szempontokra is szükség van
Adam Gleave moderálásával panelbeszélgetés indította a programot. Victoria Krakovna, a Google DeepMind kutatója, David Krueger, a Cambridge-i Egyetem munkatársa, Gillian Hadfield, a Johns Hopkins Egyetem professzora, valamint Robert Trager, az Oxford Martin AI Governance Initiative képviselője az AI által okozott destabilizáció, visszaélés és összehangolatlanság kockázatairól beszélt.
Gillian Hadfield szerint az AI-biztonság nem merül ki az egyes rendszerek összehangolásában. A komplex, több szereplőből álló rendszereket társadalmi és politikai környezetükben is meg kell érteni. A panel résztvevői úgy vélték, hogy a pusztán technikai megközelítés kevés, ezért gazdasági, jogi és társadalmi szempontokat is be kell vonni.
Stuart Russell, a Berkeley-i Kaliforniai Egyetem kutatója az AI-biztonság alapoktól való újragondolását sürgette. Szerinte a biztonsági intézkedéseket már a rendszerek tervezésekor be kell építeni, és formális garanciák nélkül kockázatos pálya előtt állunk. A repülés és az atomenergia biztonsági gyakorlatához hasonló, szigorú mérnöki megközelítést javasolt.
Nicholas Carlini az ellenséges gépi tanulás kutatásának tapasztalatairól beszélt. Arra figyelmeztetett, hogy a kutatóknak körültekintően kell kiválasztaniuk a problémákat, és hatékony értékelési módszereket kell kidolgozniuk, különben hosszú időt fordíthatnak olyan megoldásokra, amelyek végül nem hoznak eredményt.
Értelmezhetőség, irányítás és veszélyes képességek
Neel Nanda a mechanisztikus értelmezhetőségről tartott előadást. Érvelése szerint a mélytanulási modellek működése visszafejthető, és feltárhatók bennük az emberek számára érthető algoritmusok. Saját kutatási példákon keresztül mutatta be, hogyan sikerült dekódolnia egy modell által megtanult algoritmust.
David Bau az AI-rendszerek ellenálló képességét kapcsolta össze az értelmezhetőséggel. Egy, a CrowdStrike globális kiberbiztonsági incidensét követő zürichi helyzetből kiindulva azt hangsúlyozta, hogy a rendszereknek váratlan körülmények között is irányíthatónak kell maradniuk. Ehhez a működésük megértésére, a beavatkozás lehetőségére és a cselekvőképesség fenntartására van szükség.
Helen Toner, a Center for Security and Emerging Technology munkatársa az általános célú fejlett AI irányításáról beszélt. Szerinte a területen elért előrelépéshez világos fogalmakra, megbízható bizonyítékokra és egységes szakértői konszenzusra van szükség.
Mary Phuong a veszélyes képességek értékelését mutatta be. Olyan kutatásokat idézett, amelyekben AI-val támogatott csoportok hatékonyabb biológiai támadásokat terveztek, illetve egy AI önállóan webhelyeket tört fel. Előadása szerint világos beavatkozási küszöbökre van szükség, még azelőtt, hogy a rendszerek veszélyes képességei elérnének egy kritikus szintet.
A felügyelet nehéz feladatoknál válik igazán fontossá
A keynote előadást Jan Leike, az Anthropic kutatója tartotta a nehéz feladatokat végző AI-rendszerek felügyeletéről. A probléma akkor különösen összetett, amikor nincs egyértelmű, ellenőrizhető helyes válasz, vagyis a felügyelő nem fér hozzá közvetlenül a valósághoz.
Leike szerint ilyen helyzetekben új módszerekre, köztük ellenséges értékelésekre van szükség a modellek finom hibáinak felismeréséhez és javításához. A biztonságos bevezetéshez skálázható felügyeletet és olyan technikákat kell kidolgozni, amelyek a modellek képességeit teljesebben feltárják.
A rendezvény rövid előadásai többek között a bizonytalanságot kezelő, emberi visszajelzésen alapuló megerősítéses tanulással, az emberi értékek kontextusfüggő összehangolásával, az AI és az emberek közötti interakciók kialakításával, valamint az ellenséges tréninggel és teszteléssel foglalkoztak. A workshop így a biztonság technikai, társadalmi és irányítási oldalát egyetlen szakmai programban kapcsolta össze.
FAR.AI: Vienna Alignment Workshop 2024 | FAR.AI