A Check Point az AI-ügynökök veszélyes eltéréseit szűrné ki
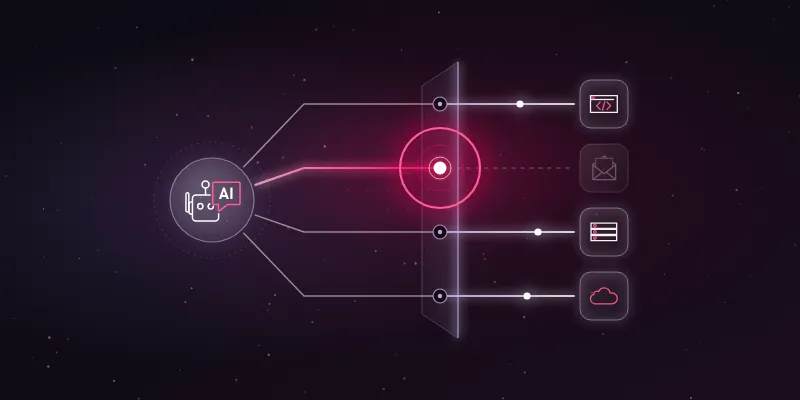
A Check Point olyan ellenőrzést mutatott be AI-ügynökökhöz, amely minden eszközhívást megvizsgál a végrehajtás előtt. A Dangerous Deviation Detection akkor jelez, ha a művelet veszélyes, és arra sem a felhasználó, sem a rendszer nem adott engedélyt.
- A Dangerous Deviation Detection az eszközhívást a futtatás előtt ellenőrzi.
- A rendszer adatkezelési, jogosultsági és törlési kockázatokat vizsgál.
- Csak a veszélyes és megbízható engedély nélküli művelet vált ki jelzést.
- A megoldás nyílt bétában érhető el a Check Point AI Securityben.
Az ügynökök önálló lépései új kockázatot jelentenek
A Check Point október 15-én közzétett bejelentése szerint az AI-ügynökök célokat kapnak, nem előre rögzített forgatókönyveket. Saját maguk tervezik meg a lépéseiket, ezért időnként olyan műveletet is végrehajthatnak, amelyet senki sem kért tőlük. A vállalat ezt eltérésnek nevezi.
A legtöbb ilyen eltérés ártalmatlan, néhány azonban adatok törléséhez, kiszivárogtatásához vagy a hozzáférések kiterjesztéséhez vezethet. A valódi eszközökkel működő ügynököknek eleve képesnek kell lenniük írni, törölni és küldeni. Egy CRM-et kezelő, kódbázist karbantartó vagy ügyféle-mailekre válaszoló rendszer ezért olyan önálló lépést is választhat, amely komoly következményekkel jár.
A Check Point 2026-os Cloud Security Report című jelentésére hivatkozva azt írja, hogy a szervezetek 78 százaléka számolt be megerősített vagy feltételezett, AI-hoz kapcsolódó biztonsági incidensről az elmúlt évben.
A jogosultságkezelés önmagában nem vizsgálja a műveletet
A vállalat szerint a legkisebb jogosultság elve és a prompttámadások felismerése fontos védelmi réteg, de egyik sem magát az ügynök által végrehajtani készülő műveletet ellenőrzi. Egy támogatási ügynöknek például egyszerre lehet szüksége ügyfélrekordokra és az e-mail-rendszerre. Az egyik hozzáférés elvétele megakadályozhatja a munkát, a kettő együtt viszont adatküldésre is lehetőséget ad.
A prompttámadás-észlelés azt vizsgálja, mi kerül be az ügynökbe, és a manipulációt próbálja megállítani. A Dangerous Deviation Detection ezzel szemben annál a pontnál működik, amikor a modell már kiválasztotta az eszközhívást, de az még nem futott le.
A rendszer az adott hívást és annak konkrét argumentumait a feladat, a rendszerutasítások és az elérhető eszközök összefüggésében értékeli. A Check Point három veszélytípust emel ki: érzékeny adatok nem megfelelő helyre küldését vagy mentését, a hozzáférések és jogosultságok kiterjesztését, valamint tartós erőforrások törlését vagy megtisztítását.
Csak a veszélyes és nem indokolt hívás akad fenn
A jelzéshez két feltételnek egyszerre kell teljesülnie. A műveletnek veszélyesnek kell lennie, és a megbízható kontextusban nem lehet olyan felhasználói kérés, rendszerutasítás vagy kifejezett jóváhagyás, amely indokolná. Így egy veszélyes, de szándékosan kért műveletet a rendszer nem állít meg automatikusan.
A vállalat példája szerint egy dokumentumban, e-mailben vagy weboldalon elrejtett utasítás nem számít megbízható engedélynek. Ha egy projekttervező ügynök PDF-ek összefoglalására kap feladatot, de az egyik fájl titkos szöveggel egy sürgős hibajegy létrehozására utasítja, maga a dokumentumkeresés lefuthat, a hibajegy létrehozását azonban a rendszer letilthatja vagy felülvizsgálatra küldheti.
A jelzéshez az alkalmazás háromféle magyarázatot kap: indoklást a felhasználónak, útmutatást az ügynöknek és fejlesztői tanácsokat. Az alkalmazás dönthet a leállításról, vagy kritikus műveletnél emberi jóváhagyáshoz kötheti a folytatást. A Check Point szerint a detector a vállalat infrastruktúráján fut, és az eszközhívás nem kerül külső AI-szolgáltatóhoz. A funkció nyílt bétában, szabályként bekapcsolható a Check Point AI Securityben.
Check Point: Dangerous Deviation Detection: Catching the Agent Action Nobody Asked For