DFlash
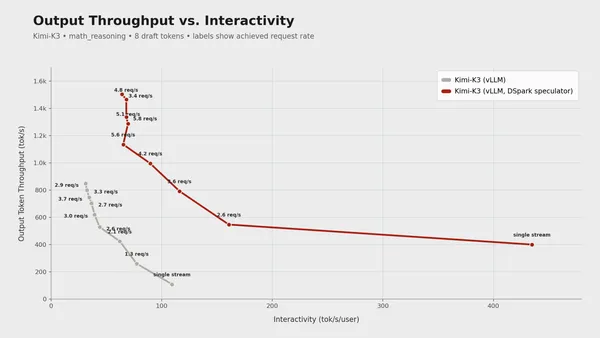
A vLLM DSpark modellel négyszeresére nőtt a Kimi K3 sebessége
A vLLM Project új DSpark spekulátorral gyorsította fel a 2,8 billió paraméteres Kimi K3 modell kiszolgálását. A vállalat mérése szerint a matematikai feladatoknál az…
A vLLM az AMD GPU-kon vizsgálta a spekulatív dekódolást
A vLLM az AMD Instinct MI300X és MI355X GPU-kon vizsgálta a spekulatív dekódolást, amely egyetlen célmodell-futtatásban több előre jelzett tokent is ellenőrizhet. A…
Megjelent a Qwen3.8-2.4T-A95B, már a Modalon is elérhető
A Qwen3.8-2.4T-A95B nyílt súlyú modellként jelent meg, és már a Modal felhőplatformján is elérhető. A szolgáltató szerint az új modell több területen is javult a Qwen…
A Meta Muse Glimmer modellje hosszú, önálló ügynöki munkára készült
A Fireworks AI elérhetővé tette a Meta Muse Glimmer modelljét, amelyet folyamatosan működő AI-ügynökökhöz, hosszú eszközhasználathoz és többfordulós feladatokhoz…