A vLLM DSpark modellel négyszeresére nőtt a Kimi K3 sebessége
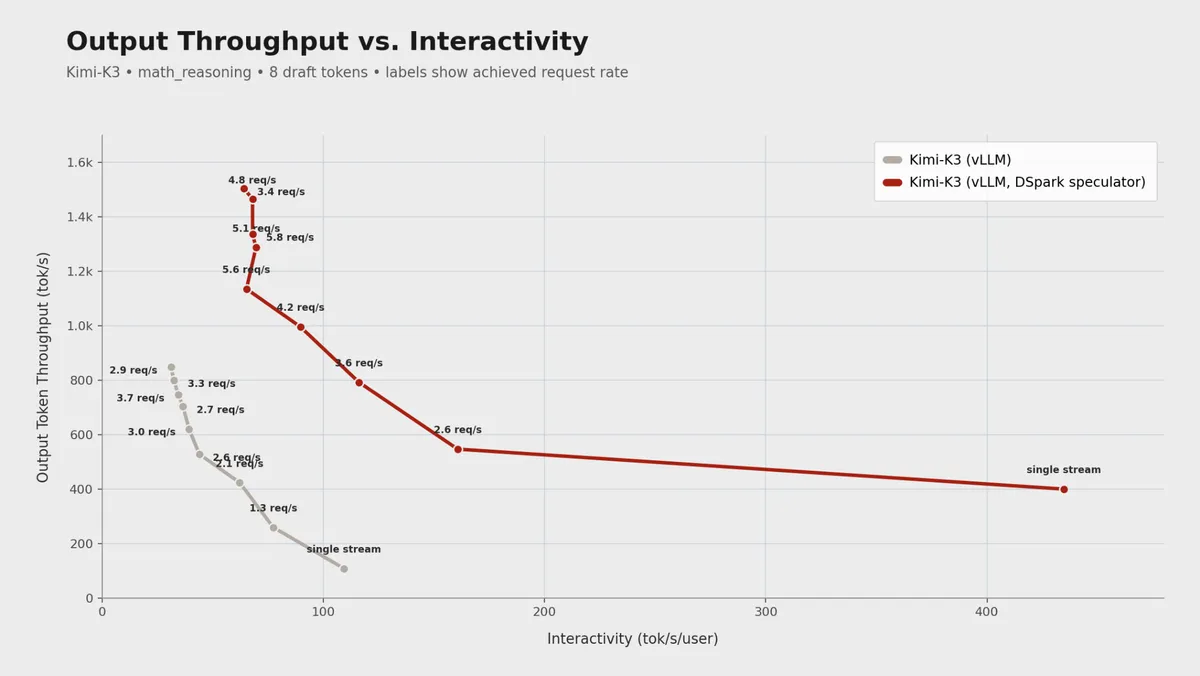
A vLLM Project új DSpark spekulátorral gyorsította fel a 2,8 billió paraméteres Kimi K3 modell kiszolgálását. A vállalat mérése szerint a matematikai feladatoknál az egyfelhasználós interaktivitás körülbelül 110-ről 435 token/másodpercre nőtt.
- A Kimi K3 DSpark spekulátora 110-ről körülbelül 435 token/másodpercre növelte az egyfelhasználós interaktivitást.
- A spekulátor ötrétegű, ötmilliárd paraméteres draftmodellt és nyolc spekulatív tokent használ.
- 16 egyidejű kérésnél az összesített teljesítmény 177-ről 683 token/másodpercre nőtt.
- A modellt egy Verda által biztosított GB300 NVL72-racken képezték.
- A DSpark modell vLLM-ben, Hugging Face-kompatibilis formátumban telepíthető.
Párhuzamos javaslatok, szekvenciális korrekció
A vLLM szeptember 15-i beszámolója szerint a DSpark a DeepSeek által júniusban bemutatott DFlash blokk-alapú spekulatív dekódolási algoritmus kiterjesztése. A spekulatív dekódolás során egy kisebb modell több lehetséges tokent javasol, amelyeket a teljes célmodell egyszerre ellenőriz.
A DFlash egyetlen, nem kauzális gerinchálózati futással becsüli meg a teljes tokenblokkot, ezért a vLLM szerint akár 2,5-szer nagyobb gyorsulást is elérhet az EAGLE-3-hoz képest. A párhuzamos előrejelzés hátránya, hogy az egyes pozíciók nem tudnak egymásra támaszkodni. Emiatt egy korai hibás token a blokk további részét is érvénytelenítheti.
A DSpark ezt két könnyű komponenssel kezeli. A Markov-logitkorrekciós fej a korábban kiválasztott token alapján módosítja a következő pozíciók valószínűségeit. A bizalmi fej azt becsüli meg, hogy az egyes tokeneket várhatóan elfogadja-e a célmodell. A hardverhez igazított ütemező ezek alapján hosszabb előtagokat ellenőriz kis terhelésnél, nagyobb terhelés esetén pedig levágja a kevésbé valószínű folytatásokat.
A Kimi K3 mérési eredményei
A Kimi K3-hoz kiadott DSpark spekulátor egy ötrétegű, ötmilliárd paraméteres draftmodellt használ, és dekódolási lépésenként nyolc tokent javasol. Kilenc értékelési területen a makroszintű átlagos elfogadási hossz 4,11 token volt ellenőrzési körönként.
A legerősebb eredményeket strukturált feladatokon mérték: matematikai gondolkodásnál 6,42, HumanEval esetén 4,96, fordításnál pedig 4,65 token jutott egy ellenőrzési körre. A vLLM szerint a módszer különösen hosszú kontextusoknál hatékony. A LongBench-v2 adathalmazon, egy 378 ezer tokenes prompt mellett, a Kimi K3 DSpark legfeljebb 5,31 kimeneti tokent ért el dekódolási iterációnként.
A párhuzamos kérések számának növelésével az összesített kimeneti teljesítmény is emelkedett. Egy és 16 egyidejű kérés között 177-ről 683 token/másodpercre nőtt. A medián elsőtoken-idő eközben 379 milliszekundumról 479 milliszekundumra változott.
GB300 NVL72 rendszeren képezték a modellt
A spekulátort a Verda által biztosított GB300 NVL72-racken képezték. A vLLM közlése szerint a Verda európai AI-felhőszolgáltató, amely az adatközpontoktól a menedzselt szolgáltatásokig saját maga üzemelteti a teljes infrastruktúrát, és 100 százalékban megújuló energiát használ.
A rendszer bare metal környezetben, virtualizáció nélkül futott, Ubuntu 24.04.4 LTS operációs rendszerrel és az NVIDIA 64K oldalas kernelével. A konfigurációban az NVIDIA 610.57.04 nyílt kernelű GPU-illesztőprogram, CUDA 13.4.0 Developer Preview, valamint NCCL 2.31.2 szerepelt. A vLLM szerint a CUDA 13.4.0 új Blackwell-programozási képességei miatt volt fontos, és ez az első olyan eszközkészlet, amely Rubin-támogatást is tartalmaz.
Közvetlenül használható vLLM-ben
A vLLM Speculators könyvtára lehetővé teszi a DSpark draftmodellek képzését, csomagolását és telepítését szabványos, Hugging Face-kompatibilis formátumban. A vLLM szerint a megoldást már Qwen3.6-35B-A3B, Gemma-4-31B-it és GLM-5.2 modelleken is validálták.
A Kimi K3 DSpark spekulátorát a vLLM közvetlenül betölti. A hivatalos telepítési recept Kimi K3-mal, 16 tensorpárhuzamosítással, két csomóponttal, FP8 KV-gyorsítótárral és nyolc spekulatív tokennel konfigurálja a szolgáltatást. Ez az open source közösség számára azt jelenti, hogy a módszerhez kész képzési és kiszolgálási útvonal áll rendelkezésre, a vLLM pedig a célmodell mellett a draftmodell futtatását is kezeli.

