A Confluent egyesíti a valós idejű adatfeldolgozást és az AI-t
A Confluent jelentősen kibővítette a Confluent Cloud for Apache Flink szolgáltatást, amelyet egyszerre szán a küldetéskritikus, valós idejű rendszerekhez és az adatelemzési, illetve AI-munkafolyamatokhoz. A vállalat szerint az Apache Kafka és a Flink mostantól egy közösen tervezett, szerver nélküli termékként működik.
- A Flink Table API Java nyelven általánosan elérhetővé vált.
- A PTF-ek egyedi állapotkezelést és időzítőket biztosítanak.
- A dbt-adapter és a Materialized Tables a teljes Flink-életciklust támogatja.
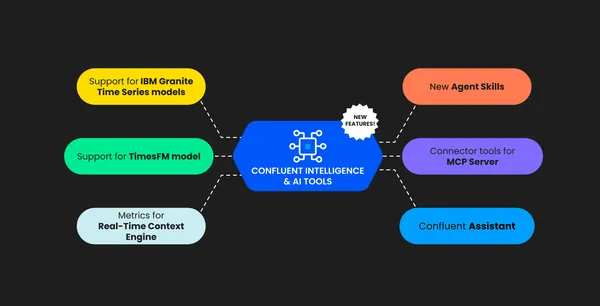
- A Flink AI Model Inference, anomáliaészlelés és Granite-modellek használatát is támogatja.
- A Kafka és a Flink egy közösen tervezett, szerver nélküli termékként működik.
Programozható Flink a fejlesztőknek
A Confluent augusztus 18-i bejelentése szerint a Flink Table API Java nyelven általánosan elérhetővé vált. A fejlesztők így kódalapú módon építhetnek összetett Flink-alkalmazásokat, miközben megmarad a szerver nélküli, teljesen menedzselt futtatási környezet egyszerűsége.
A vállalat állítása szerint a Table API a streamfeldolgozási feladatok 95 és 99 százaléka esetében eléri vagy felülmúlja a DataStream API teljesítményét. Az API deklaratív módon támogatja a kötegelt és a folyamatos adatfeldolgozást, így a fejlesztőknek a Confluent szerint elsősorban az üzleti logikára kell koncentrálniuk.
Az olyan esetekhez, amelyeket a szabványos SQL nem tud kifejezni, a Confluent bevezette a Process Table Functions, röviden PTF-ek általános elérhetőségét Java nyelven, az AWS, az Azure és a GCP felhőszolgáltatón. Ezek egyedi állapot kezelését és pontos időzítők beállítását teszik lehetővé, például csalásészlelési, dinamikus árazási és többváltozós anomáliaészlelési folyamatokban.
A felhasználó által definiált függvények, vagyis az UDF-ek Java nyelven a Google Cloudon, Pythonban pedig az AWS-en is támogatottak. A Flink Apps alkalmazások automatikus skálázást, pontosan egyszeri feldolgozási szemantikát és infrastruktúra-kezelés nélküli futtatást kínálnak. A Confluent emellett automatikus Kubernetes-fürtök közötti átállást, SQL-helyreállítási mechanizmusokat, hibaminták felismerését és gyorsabb ellenőrzőpontokat vezetett be.
dbt-alapú adatfolyamok és egységes kötegelt feldolgozás
Az elemzési mérnökök és az adattudósok számára a dbt-adapter és a Materialized Tables általános elérhetőségét jelentette be a Confluent. Ezekkel a csapatok ugyanazzal a dbt run munkafolyamattal kezelhetik a Flink-folyamatok teljes életciklusát, amelyet például a Snowflake vagy a Databricks adattárházaiban is használnak.
A Materialized Tables tartós, adatbázisszerű eszközökként kezelik a folyamokat. Ha egy csapat új oszlopot ad hozzá, szűrőt szigorít vagy módosítja a logikát, a Flink a Confluent szerint automatikusan elvégzi a leállítást, az újraindítást, az offsetek kezelését és a felzárkózást. A cél, hogy az irányítópultok, adattavak és lakehouse-rendszerek folyamatosan friss, elemzésre kész adatokat kapjanak.
A Flink kötegelt és folyamatos feldolgozást is kezel. A Snapshot Queries és a Table API kötegelt módja lehetővé teszi a korábbi adatok és az élő adatfolyamok együttes lekérdezését. A Snapshot Queries egy adott időpontra vonatkozó teljes nézetet adhatnak vissza a Tableflow történeti adatai és a Kafka legújabb eseményeinek összekapcsolásával. A lekérdezések Apache Iceberg vagy Parquet formátumokon futnak, a Confluent szerint ezért gyorsabbak a nyers Kafka-adatfolyamok teljes átvizsgálásánál.
Valós idejű kontextus az AI-rendszerek számára
A Confluent a Flinket az AI-hoz szükséges adatok dúsításának rétegeként pozicionálja. A Flink AI Model Inference funkcióval távoli modellvégpontok hívhatók közvetlenül Flink SQL-ből. Ez lehetővé teszi az élő adatfolyamok valós idejű következtetéssel, beágyazásokkal és vektorkeresési lekérdezésekkel való kiegészítését.
A bejelentés része a többváltozós anomáliaészlelés általános elérhetősége és a Granite modellek támogatása is. A Streaming Agents segítségével a fejlesztők eseményvezérelt, folyamatosan működő ügynököket építhetnek közvetlenül a Flinkre. A vállalat szerint ezek a rendszerek a Model Context Protocolon, vagyis az MCP-n keresztül friss kontextust szolgáltathatnak az AI-alkalmazásoknak.
Mit jelent a bejelentés a felhasználóknak?
A Confluent célja, hogy a fejlesztők, az adatbázis-mérnökök és az AI-csapatok ugyanazon a platformon dolgozzanak, eltérő munkamódszereik megtartásával. A fejlesztők Java és Python segítségével programozhatják a feldolgozást, míg az elemzési csapatok SQL-t, dbt-t és Materialized Tables elemeket használhatnak.
A vállalat ügyfélpéldái szerint a MasterControl három óráról öt percnél rövidebbre csökkentette az adatfeldolgozási időt. A Henry Schein One irányított, éles használatra kész adatokat állít elő kevesebb utólagos újramunkával, míg a Fiserv és a JPMC nagy áteresztőképességű pénzügyi munkafolyamatokhoz használja a platformot. A bejelentés központi eleme a Kafka és a Flink közös irányítási modellje, amelyet a Confluent Schema Registry támogat.