A CoreWeave folyadékhűtésre épített adatközpontokkal készül
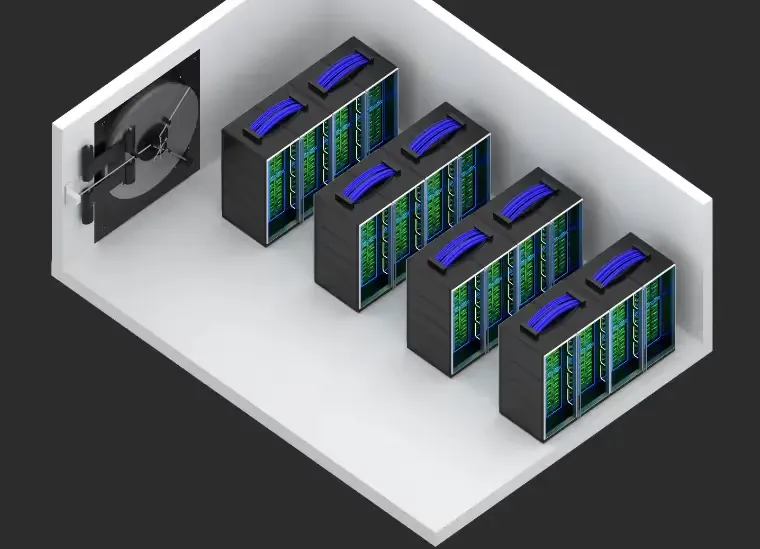
A CoreWeave olyan adatközponti infrastruktúrát épít, amelyet kifejezetten mesterségesintelligencia-munkafolyamatokra és több tízezer GPU-s klaszterekre terveznek. A vállalat tervei szerint a 2025-ben megnyíló CoreWeave-adatközpontok többsége már folyadékhűtési képességgel rendelkezik.
- A CoreWeave AI-munkafolyamatokra tervezett adatközpontokat épít.
- A 2025-ben megnyíló helyszínek többsége folyadékhűtési képességet kap.
- A vállalat körülbelül 130 kW-os rackek támogatását célozza.
- A Mission Control automatizált klaszterfelügyeletet biztosít.
- A CoreWeave széles NVIDIA GPU-portfólióval készül a változó terhelésekre.
A nagyobb GPU-sűrűség új hűtést igényel
A CoreWeave október 2-án közzétett bejegyzése szerint az AI-iparág a több száz vagy több ezer GPU-t egyetlen összekapcsolt rendszerben használó megaklaszterek felé halad. Ez jelentősen növeli az energiaigényt, miközben a hagyományos adatközponti kialakítások gyakran nem alkalmasak az ilyen rendszerek kiszolgálására.
A vállalat az NVIDIA Blackwell rendszereit hozza példaként. Az NVIDIA GB200 NVL72 egyetlen rackben 72 GPU-t tartalmaz, és a CoreWeave szerint akár 30-szor gyorsabb valós idejű, ezermilliárd paraméteres következtetést tesz lehetővé. A nagyobb teljesítmény ugyanakkor több hőt termel. A tipikus tárhelyszolgáltatási helyszínek jellemzően 5 és 10 kW közötti rackpozíciókat támogatnak, ami a nagyobb sűrűségű rendszerekhez kevés lehet.
A CoreWeave teljes adatközpontokat tervez folyadékhűtésre, ahelyett, hogy utólag alakítana át kisebb területeket. A vállalat szerint ez akár körülbelül 130 kW-os rackek támogatását is lehetővé teszi, és gyorsíthatja az új helyszínek kialakítását.
AI-ra szabott adatközpontok és szigorú védelem
A nagy nyelvi modellek növekedésével egyre nagyobb tanítási klaszterekre van szükség. A CoreWeave szerint egy 100 000-nél több GPU-ból álló megaklaszter több száz megawatt energiát is igényelhet, ami különösen nagy terhet jelenthet a CPU-munkafolyamatokra tervezett hagyományos adatközpontoknak.
A szolgáltató hardver- és adatközponti partnereivel együtt tervezi az infrastruktúra kritikus elemeit. A vállalat NVIDIA-val fennálló együttműködése szerintük a magas minőségű AI-platformokhoz való hozzáférést is támogatja. Mérnökeik a gyártási és tesztelési folyamatokon is dolgoznak a partnerekkel, hogy csökkentsék a későbbi hibák számát.
A CoreWeave adatközpontjai korlátozott hozzáférésű épületek, látható jelzés nélkül. A vállalat közlése szerint éjjel-nappali biztonsági személyzet, szigorú beléptetési protokoll, valamint a személyazonosság- és jogosultságkezelés segíti az illetéktelen hozzáférés megakadályozását.
A teljesítményhez a klaszter állapota is számít
A CoreWeave a teljesítményt nem kizárólag a GPU-k számával méri. A vállalat a 2024-es Llama 3 jelentésre hivatkozik, amely szerint a modellek egy 54 napos időszak alatt akár 420 váratlan megszakítást is tapasztalhatnak. A szinkronizált GPU-s tanításnál egyetlen meghibásodott GPU is az egész feladat újraindítását teheti szükségessé.
A szolgáltató Local Object Transport Accelerator nevű, LOTA rövidítésű megoldása közvetlenebb adatútvonalat biztosít a GPU-k és az adattárak között. A hálózati oldalon NVIDIA Quantum-2 InfiniBand-alapú klasztereket és SHARP-képességgel rendelkező hálózatot használ.
A CoreWeave Mission Control rendszere a csomópontok és klaszterek állapotát kezeli. A Fleet Lifecycle Controller és a Node Lifecycle Controller automatizált üzembe helyezést, tesztelést és megfigyelést végez, és a vállalat szerint a gyengébben teljesítő csomópontokat is képes lecserélni.
Széles GPU-választék a változó terheléshez
Az AI-munkafolyamatok terhelése gyorsan változhat. A CoreWeave szerint egy ügyfél percek alatt juthat teljesen nyugodt időszakból tíz megawattos nagyságrendű energiafelhasználásig, amikor elindul egy tanítási folyamat.
A vállalat ezért széles NVIDIA GPU-portfóliót tart fenn, amelyet a munkaterhelésekhez szükséges kapacitás biztosítására szán. A tervezés során a tartalék energiaellátást is figyelembe veszik. Ez a CoreWeave értelmezése szerint puffert és mérnöki támogatást adhat a nagy, összetett klaszterek stabil működéséhez, miközben elkerülhetővé válhatnak az utólagos, költséges és időigényes átalakítások.
CoreWeave: Our Capacity Plans for CoreWeave Data Centers