A CUDA optimalizációs tudást vinné át Apple chipekre a K-Search
A Berkeley kutatói a K-Search nevű keresi és optimalizálja GPU-kernelfejlesztő rendszert MLX-támogatással bővítették. A cél, hogy a CUDA ökoszisztémában felhalmozott optimalizációs tudás Apple Silicon chipeken is hasznosítható legyen.
- A Berkeley kutatói MLX-hátteret készítettek a K-Search keretrendszerhez.
- A rendszer CUDA-kódok optimalizációs tudását használja Apple Siliconhoz.
- A jelentett eredmény az MLX Attention kernel 0,97-szeres teljesítménye.
- A Mamba kernel prefixelése akár 20-szor gyorsabb volt a közösségi mlx-lm megoldásnál.
- A módszer a kutatók szerint más, CUDA-tudást átvevő ökoszisztémákban is használható.
A CUDA-tapasztalat átültetése MLX-re
A Berkeley BAIR 2026. július 29-én ismertetett munkája abból indul ki, hogy a különböző gyártók hardvereihez készülő GPU-kernelt általában külön kell optimalizálni. A CUDA környezetben évtizedek alatt felhalmozódott a figyelemmechanizmusok, állapottérmodellek és más fontos műveletek kézi hangolásának tudása, az újabb hardveres ökoszisztémákban azonban ennek jelentős része még hiányzik.
A kutatók a Berkeley Sky Lab munkatársa, Shiyi Cao által eredetileg kidolgozott K-Search keretrendszerre építettek. A rendszer egy kezdeti, egyszerű kernelt és a hardver leírását kapja meg, majd mesterséges intelligencia segítségével új változatokat készít, azokat valódi hardveren lefordítja és leméri. A mérések alapján folytatja az ígéretes irányok keresését, a gyengébb próbálkozásokat pedig elveti.
Az új MLX-háttér Apple Silicon chipeken futtatja és méri a kerneleket. A fejlesztés része volt az MLX-re szabott feladatadapter, a Metal- és MLX-kódot előállító promptok, valamint az MLX mérési eszközeivel való integráció.
A keresés döntési fát épít
A K-Search nem egyszerű próbálkozáslistát vezet. A kutatók szerint a rendszer egy tartósan bővülő döntési fát, úgynevezett világmodellt használ. A fa egyes ágai teljes optimalizációs terveket képviselnek, a testvérágak pedig egymással versengő alternatívák.
A rendszer minden csomóponthoz értékelést, bizonyossági szintet, valamint a memória-sávszélességre, a regiszternyomásra és a számítási illeszkedésre vonatkozó hatásbecslést rendel. A keresés három fő lépésből áll: kiválasztja a legígéretesebb műveletet, konkrét kódváltozatokat készít és tesztel, majd frissíti a keresési fát.
A Berkeley BAIR beszámolója szerint a futtatásokban ugyanaz a modell, a Gemini 3.5 Pro Preview töltötte be a következtetési és a kódíró szerepet. A modell először osztályozza a kernelt, felírja a számítást kanonikus formában, elemzi az adatelrendezést és megpróbálja meghatározni a szűk keresztmetszetet. Ezután iterációnként egyetlen, megvalósítható optimalizációt javasol.
Mért eredmények Apple Siliconon
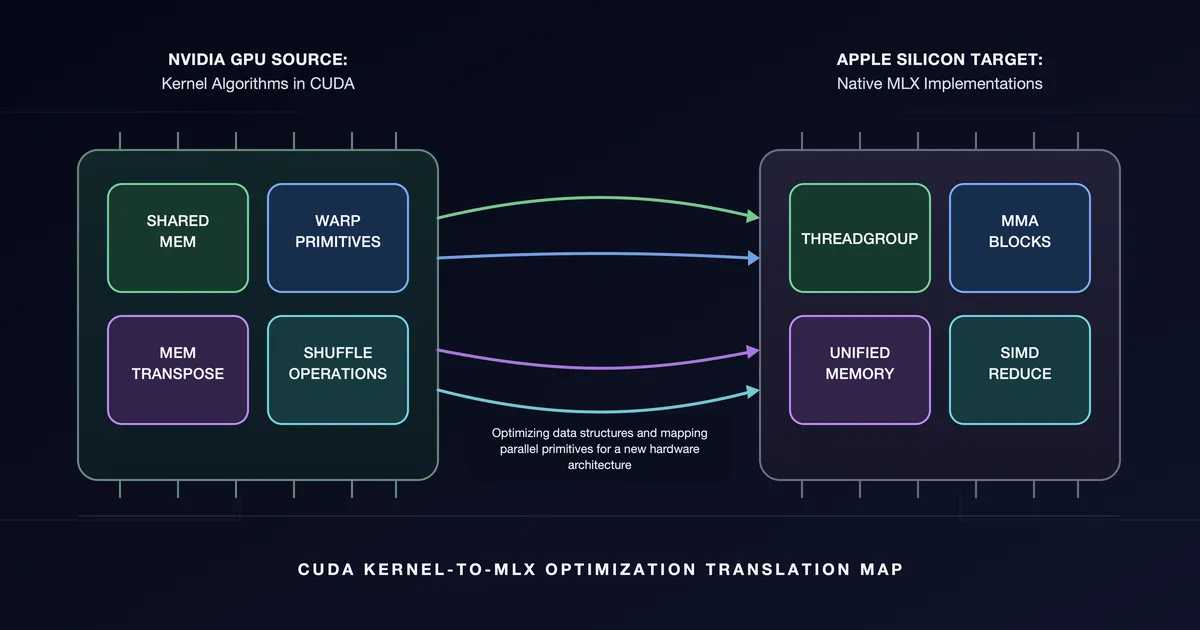
A kutatók szerint a CUDA-kód közvetlen átadása egy nyelvi modellnek nem elegendő. Így ugyan szintaktikailag helyes, de az adott architektúrához rosszul illeszkedő kód születhet, például hibás csempeméretekkel vagy nem megfelelő memóriaműveletekkel.
Ezért strukturált CUDA és MLX közötti fordítási réteget készítettek. A réteg fogalmi megfeleltetéseket és hardveres korlátozásokat tartalmaz. A forrás egyik példája szerint a CUDA __shared__ konstrukciója Metal threadgroup memóriájának felel meg, utóbbinál azonban 32 KB-os korlátot kell figyelembe venni, szemben az NVIDIA 48 KB-os értékével.
A beszámoló szerint a megközelítés az Apple Siliconon a natív MLX Attention kernel teljesítményének 0,97-szeresét érte el. A Mamba állapottérmodell-kernel esetében a közösségi mlx-lm megvalósításához képest akár 20-szoros prefixelési gyorsulást jelentettek. A kutatók azt írják, hogy a módszer nem kizárólag MLX-re alkalmazható, hanem minden olyan ökoszisztémára, ahol átvihető a CUDA-ban felhalmozott optimalizációs tudás.
Miért fontos ez az Apple Silicon felhasználóinak?
Az MLX az Apple saját gépi tanulási keretrendszere, amely a Berkeley BAIR szerint 2023 vége óta gyorsan terjed. Az Apple Silicon chipek egységes memóriája közepes méretű, 7B és 70B paraméter közötti modellek helyi futtatását is vonzóvá teszi M sorozatú chipeken, felhőszolgáltatás költsége nélkül.
A kutatók szerint az MLX jelenleg helyesen futtat modelleket, de több teljesítménykritikus kernel, például a lapozott figyelem, a hangolt állapottérmodell-szkennelés és a kevert szakértős modellek útválasztása még hiányzik, vagy hardveres hangolás nélkül működik. A K-Search erre a hiányra kínálhat automatizált megközelítést, a CUDA-környezetben felhalmozott tapasztalatot Apple Siliconra igazítva.
Berkeley BAIR: From CUDA to MLX: How K-Search Brings Decades of Kernel Expertise to Apple Silicon