vllm-metal érkezett az Apple chipes gépek párhuzamos kiszolgálására
A vLLM bejelentette a vllm-metal projektet, amely az Apple Silicon gépekre hozza a vLLM ütemezőjét, lapozott KV-gyorsítótárát és OpenAI-kompatibilis szerverét. A végrehajtást az MLX és a Metal végzi, így több, egy időben érkező modellkérés kiszolgálására is használható.
- A vllm-metal a vLLM ütemezőjét és OpenAI-kompatibilis szerverét Apple Siliconra hozza.
- Az MLX és a Metal végzi a modellek végrehajtását.
- A rendszer lapozott KV-gyorsítótárat és összecsomagolt, változó hosszúságú modelllépéseket használ.
- A v0.28.0 bevezette az MTP, a GGUF- és a hibridmodell-támogatást.
- A vLLM szerint a vllm-metal több tesztben alacsony TTFT-t ért el párhuzamos terhelés mellett.
A vLLM rendszere Apple chipeken
A vllm-metal a vLLM felsőbb szintű komponenseire épül. A rendszer a V1 ütemezőt, a lapozott KV-blokkok kezelését, a darabolt előfeldolgozást, a mintavételezést és az OpenAI-kompatibilis, folyamatos válaszadást, valamint eszközhívások elemzését az upstream vLLM-ből veszi át.
A modellmegvalósításokat az mlx_lm biztosítja, a végrehajtásért pedig az MLX felel. A vllm-metal változtatás nélkül használja többek között a súlyok betöltését, az RMSNorm, a lineáris, a MoE- és az MLP-rétegeket. Az attention réteghez saját, lapozott, változó hosszúságú Metal-kernelt használ, mert az attentionnek ismernie kell az egyes kérések határait.
A projekt első hivatalos kiadása a v0.28.0 volt, amelynek verziószámozását a fejlesztők az upstream vLLM-hez igazították. Ez a kiadás bevezette a kötegelt többtokenes előrejelzést, a GGUF- és hibridmodell-támogatást, valamint az M5 gépeken gyorsabb előfeldolgozást.
OpenAI-kompatibilis szerver Homebrew-val
A stabil kiadás macOS 15 vagy újabb rendszert futtató Apple Silicon gépeken telepíthető Homebrew-val. A vLLM közlése szerint a csomagkezelő a Pythont és a függőségeket is kezeli. A szerver a vllm serve paranccsal indítható, a modellek között a Qwen3.5-0.8B, a Qwen3.8-27B-4bit és a Gemma 4 E4B-it példákat említi a dokumentáció.
A szolgáltatás az OpenAI API-t használja, ezért az olyan programok, amelyek OpenAI-kompatibilis alap URL-t támogatnak, a helyi szerverhez irányíthatók. A forrás külön említi a kódoló ügynököket, valamint a Claude Code és a Codex beállítását is.
A következő, v0.29.0 verzió Homebrew-val telepíthető. A forrás szerint a vllm-metal modellmátrixa további támogatott modelleket, a telepítési útmutató pedig más telepítési módokat ismertet.
Lapozott KV-gyorsítótár és kiszámítható memóriahasználat
A vllm-metal memóriaőre a --gpu-memory-utilization kapcsolóval állítható be az inferencia költségkerete, így hely maradhat a macOS és más alkalmazások számára. Induláskor a rendszer bemelegítő futtatást végez, amelybe beleszámítja a modell súlyait, az aktivációkat és az ideiglenes puffereket, majd a fennmaradó keretet rögzített KV-gyorsítótárhoz rendeli.
A rendszer az MLX újrahasznosítható puffer-gyorsítótárát is korlátozza, hogy a memória ne halmozódjon fel a kiszolgálás közben. Ha egy új kérés nem fér el a KV-készletben, várakozik, amíg lapok szabadulnak fel.
A modelllépésben a különböző kérések tokenjeit egyetlen, összecsomagolt tengelyre helyezik. A kérésenkénti határokat a cu_seqlens jelöli, a KV-adatokat pedig fix méretű lapokban, kérésenkénti blokktáblák segítségével tárolják. Ez lehetővé teszi, hogy a már felvett kérések növekedjenek a kitöltött, téglalap alakú gyorsítótár átformálása nélkül.
A fejlesztők szerint terhelés alatt is alacsony marad a TTFT
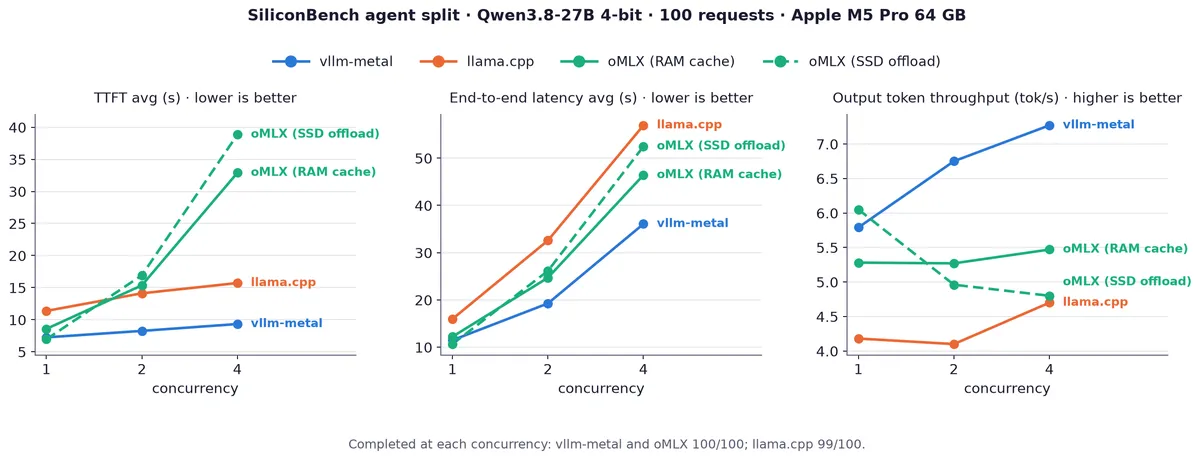
A vLLM a SiliconBench ügynöki tesztjével mérte a párhuzamos kiszolgálást. A vizsgálat 100 többfordulós promptot használt, körülbelül 4,6 ezer bemeneti tokennel, egy 64 GB memóriájú M5 Pro gépen. A modellek minden összehasonlításban 4 bites súlyokat használtak.
A Qwen3.8-27B esetében a vllm-metal a közlemény szerint 2-es és 4-es konkurenciaszinten érte el a legalacsonyabb első tokenig tartó időt és teljes kéréskésleltetést. A Gemma 4 E4B tesztjét 16-os konkurenciáig bővítették, és az MTP-vázlatmodellt is bevonták. A vllm-metal ebben a vizsgálatban végig alacsony TTFT-t tartott.
A Gemma 4 E4B-nél egy vázlattokennel végzett MTP használata 1-es konkurenciánál 15 százalékkal rövidebb faliórát, 20 százalékkal magasabb kimeneti tokensebességet és 1 százalékkal alacsonyabb átlagos TTFT-t hozott a forrás táblázata szerint. 16-os konkurenciánál ezek az értékek rendre 8 százalékkal alacsonyabb faliórát, 9 százalékkal magasabb tokensebességet és 20 százalékkal magasabb TTFT-t jelentettek.
Az MTP opcionális, a Gemma 4 támogatása jelenleg egyszerű, mohó mintavételezést és szinkron ütemezést igényel. A megoldás így azoknak lehet hasznos, akik Apple Silicon gépen több egyidejű helyi modellkérést, például kódoló ügynökök munkameneteit szeretnék egy OpenAI-kompatibilis végponton kiszolgálni.