A Databricks AI Runtime nyolcszorosára gyorsította a kutatási kísérleteket
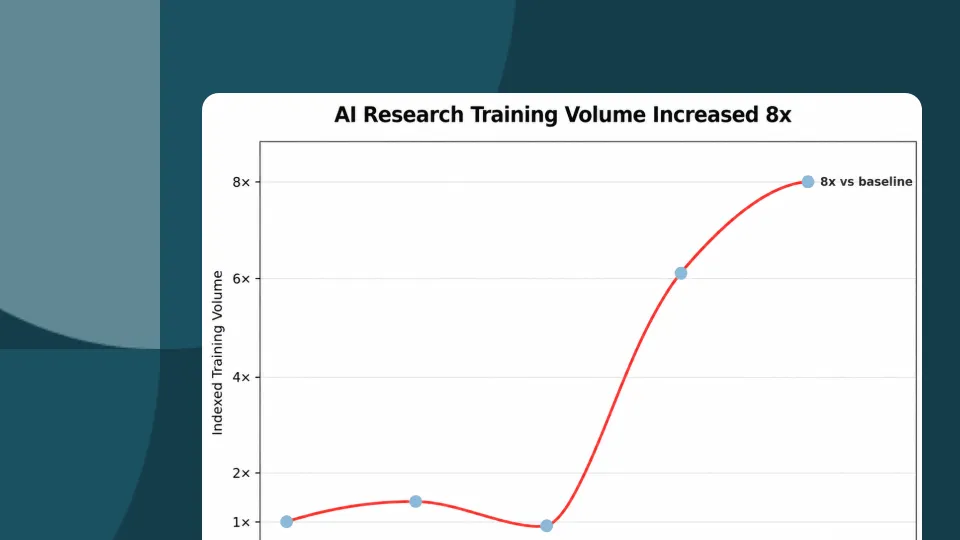
A Databricks AI Research az AI Runtime infrastruktúráját használja modellek képzésére és finomhangolására, a kisebb próbáktól a több száz GPU-t igénylő feladatokig. A vállalat szerint az ügynökök bevonása nyolcszorosára növelte a tréningfeladatok számát.
- A Databricks AI Research kis kísérletektől több száz GPU-s képzésekig használja az AI Runtime-ot.
- Az AI Runtime ellenőrzi és futás közben is figyeli a GPU-csomópontok állapotát.
- Az MLflow és a Unity Catalog integrációja egységes kutatási munkafolyamatot biztosít.
- Az AI Functions kutatásában nyolcszorosára nőtt a tréningfeladatok száma.
- Az ügynökök párhuzamosan indítják, értékelik és finomítják a kísérleteket.
A kisebb próbáktól a több száz GPU-s képzésekig
A Databricks AI Research olyan termékekhez fejleszt modelleket és módszereket, mint a Genie, a Smart Routing és az AI Functions. Az AI Functions része például az ai_parse_document és az ai_extract, amelyek vállalati dokumentumok feldolgozására szolgálnak.
A kutatók több tízezer képzési és értékelési futtatást végeznek különböző architektúrákkal, adatkészletekkel, tanítási technikákkal és hiperparaméterekkel. Felügyelt finomhangolást, offline megerősítéses tanulást és online megerősítéses tanulást is használnak. A modellek mérete néhány milliárd paramétertől közel egybillió paraméterig terjed.
A munkaterheléstől függően NVIDIA H100 és B300 GPU-kat alkalmaznak. A legnagyobb képzésekhez több száz GPU dolgozik együtt napokon vagy heteken át, nagy sávszélességű hálózati kapcsolattal.
GPU-megbízhatóság és gyorsabb kísérletezés
A Databricks szerint a hosszú futású képzéseknél egyetlen csomópont vagy RDMA-hálózati hiba is több száz GPU leállását okozhatja, és a munkát egy korábbi ellenőrzési pontról kell újraindítani. Az AI Runtime a képzés előtt ellenőrzi a kijelölt GPU-csomópontok állapotát, futás közben pedig figyeli többek között az NCCL-kommunikációs hibákat, a hőmérsékleti vagy energiaellátási korlátozásokat, valamint a GPU-illesztőprogramok problémáit.
Ha egy csomópont meghibásodik, a rendszer felismeri a problémát, és kizárja az érintett infrastruktúrát a következő feladatok ütemezéséből. Ez a Databricks szerint különösen fontos a KARL projektnél, ahol a több mint 100 milliárd paraméteres modellek összetett utógenerálása és utólagos képzése több ezer GPU-órát igényelhet.
Az AIR parancssori felületén keresztül a kutatók programból indíthatják a munkaterheléseket, megadhatják a szükséges GPU-kat, a rendszer pedig kezeli az erőforrások biztosítását és ütemezését. A vállalat közlése szerint a képzési feladatok másodpercek alatt elindulhatnak. A helyi fejlesztéshez használt Docker-képek ugyanúgy alkalmazhatók a tréningekben, így nem kell újra felépíteni a környezetet.
MLflow, Unity Catalog és ügynökök a kutatási folyamatban
Az AI Runtime automatikusan létrehozza és kezeli az MLflow-kísérleteket a képzési feladatokhoz. A kutatók követhetik a munkák állapotát, megtekinthetik a naplókat, és lekérhetik a mérőszámokat. Ezek az adatok az AI-ügynökök számára is elérhetők, így az ügynökök értékelhetik az eredményeket, majd kiválaszthatják a következő próbálkozást.
A kutatási adatok a Unity Catalogban találhatók. A Unity Catalog FUSE-csatolásával az AIR ezeket helyi fájlrendszer részeként teszi elérhetővé akkor is, ha a munka több Databricks-munkaterület között zajlik. A vállalat szerint így az adatok követhetők, megoszthatók és szabályozottan kezelhetők, miközben a képzési kód fájlkezelése változatlan marad.
A Databricks AI Functions kutatási munkaterheléseiben a tréningfeladatok száma nyolcszorosára nőtt. Az ügynökök fejlesztési javaslatokat készítenek, párhuzamosan indítják a próbákat, kiértékelik a mérőszámokat, majd az eredmények alapján frissítik a tervet. Az AI Runtime prioritáskezelése és előemptálása lehetővé teszi, hogy a sürgősebb kísérletek előnyt kapjanak, a szabad kapacitást pedig további feltáró próbák használják ki.
Mit jelent ez a felhasználóknak?
A Databricks AI Research szerint az AI Runtime csökkenti az infrastruktúra kezelésére fordított időt, miközben egységes munkafolyamatot biztosít a helyi fejlesztéstől az elosztott képzésig. A gyors indítás, a programozható hozzáférés, a megbízhatósági ellenőrzések és az MLflow-mérőszámok elérése különösen az ügynökvezérelt kutatásban fontos, ahol egyszerre akár több száz kísérlet is elindulhat.
A vállalat az AI Runtime dokumentációját ajánlja azoknak, akik saját modelleket képeznek vagy finomhangolnak. A közlés alapján a rendszer célja, hogy a kutatók nagyobb modellekkel és gyorsabb kísérletezési ütemben dolgozhassanak, miközben az erőforrások elosztását az infrastruktúra kezeli.
Databricks: How our AI Research team uses AI Runtime